


Python可变序列与不可变序列的区别:list、bytearray与tuple、str对比
深入对比Python中的可变序列(list、bytearray)与不可变序列(tuple、str),从底层内存模型、原地修改机制、哈希性、性能开销到工程选型场景进行全面解析。
在 Python 中,序列(Sequence)是承载有序集合的核心数据结构。依据对象创建后是否允许原地修改其内部数据,Python 将序列严格划分为两大阵营:以 list(列表)和 bytearray(字节数组)为代表的可变序列(Mutable Sequences),以及以 tuple(元组)和 str(字符串)为代表的不可变序列(Immutable Sequences)。理解这一核心差异,不仅关乎语法规则的使用,更直接决定了程序的内存开销、运行效率、字典键合法性以及多线程并发时的安全性。本文将从底层内存机制、对象哈希性、具体操作方法及典型选型场景展开系统剖析。
一、核心本质:内存地址与原地修改机制
可变与不可变的最本质区别,体现在对数据执行增删改操作时,Python 底层对内存堆块的处理机制上:
- 不可变序列(str / tuple):对象一旦被解释器在内存中分配,其内部存储的引用或字节序列便被冻结。任何形式的“修改”操作(如拼接、切片替换、字符转换),本质上都是在堆内存中重新申请一块新空间、构建一个全新对象,并将变量重新绑定(Rebind)到新对象的地址上。旧对象若失去所有引用,则等待垃圾回收器(GC)回收。
- 可变序列(list / bytearray):对象的内存空间在分配后支持原地变更(In-place Mutation)。无论是追加元素、删除节点还是调整内容,变量所指向的内存地址(即
id())保持恒定,底层直接通过重分配或调整内置缓冲区指针来完成修改。
# 示例:通过 id() 观察修改前后的内存地址变化
# 1. 不可变类型 str
text = "hello"
addr_text_before = id(text)
text += " world"
addr_text_after = id(text)
print(addr_text_before == addr_text_after)  # 示例输出: False (地址已变,生成了新对象)

# 2. 可变类型 list
items = [1, 2]
addr_items_before = id(items)
items.append(3)
addr_items_after = id(items)
print(addr_items_before == addr_items_after)  # 示例输出: True (地址未变,原地修改)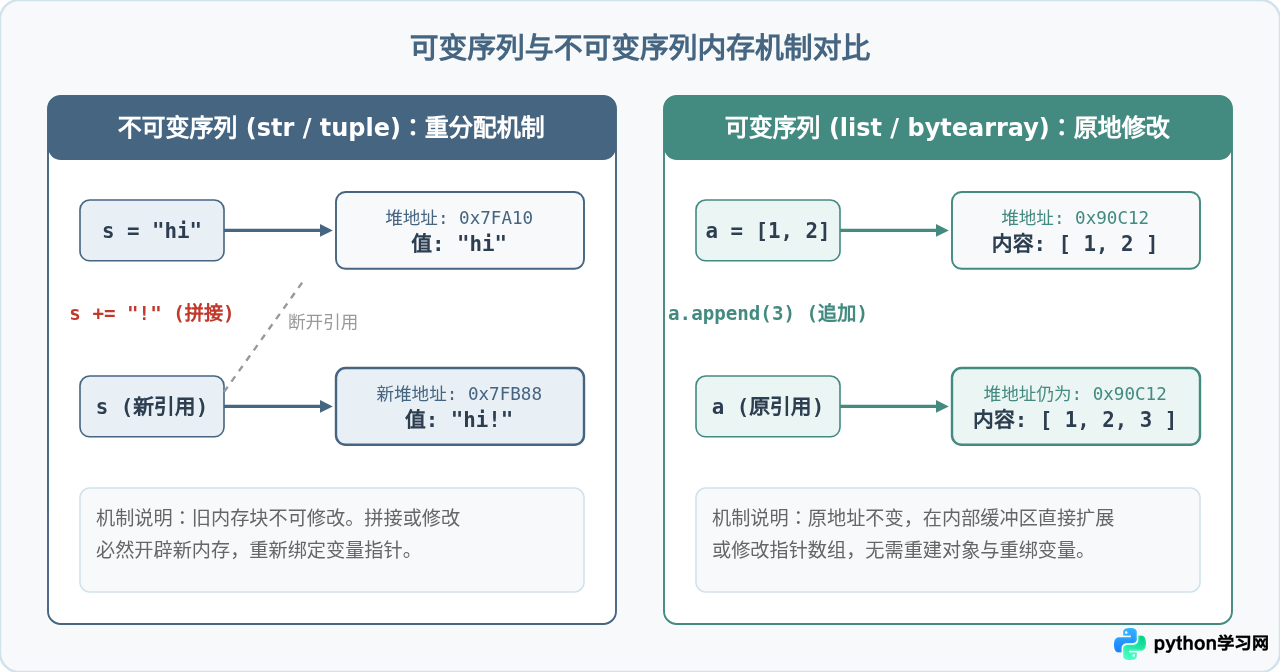
二、通用对象容器对比:list 与 tuple
list 与 tuple 均属于可以存放任意类型对象的通用序列容器,两者的核心功能对照如下:
1. 内存分配策略与性能开销
tuple 的长度固定,解释器在初始化时会分配恰好容纳指定元素数量的连续指针数组,没有冗余槽位。对于小型元组,Python 还内置了快速缓冲池(Free list),创建与销毁速度极快。
而 list 是动态数组。为了使 append() 操作具备均摊 $O(1)$ 的时间复杂度,Python 采用了过度分配(Over-allocation)机制。当容量不足时,会成倍或阶梯式多申请空闲槽位。这意味着相同元素数量下,list 总是比 tuple 占用更多的堆内存。
import sys

tup = (1, 2, 3)
lst = [1, 2, 3]

print("tuple 内存字节:", sys.getsizeof(tup))  # 示例输出: 64
print("list  内存字节:", sys.getsizeof(lst))  # 示例输出: 88 (包含动态槽位指针)
2. 哈希性(Hashable)与字典键规则
Python 字典的键(Key)和集合(Set)的元素必须是可哈希(Hashable)对象。只有不可变对象才能保证其哈希值在生命周期内恒定不变:
tuple默认实现了__hash__(),可以作为字典的键。例如:cache[(x, y)] = result。list是可变对象,其实例没有实现哈希方法,若作为字典键会抛出TypeError: unhashable type: 'list'。
不可变元组“不可哈希”的特例:如果一个元组内部包含了可变对象(如 t = (1, [2, 3])),虽然元组本身引用不可变,但由于其引用的列表内容随时可能被修改,导致整体哈希值无法确定。此时尝试调用 hash(t) 依然会抛出 TypeError: unhashable type: 'list'。
三、字节处理与文本编码对比:bytearray 与 str
在涉及二进制 I/O、文件协议及文本处理时,str 与 bytearray 分别代表了不可变文本与可变原始字节的典型实现。
1. 设计意图差异
- str(不可变 Unicode 序列):用于表示人类可读的自然语言文本。由于字符串在程序中被高频用作变量名、字典键及模块标识,不可变性保障了 Python 运行时的字符串驻留(String Interning)优化及哈希安全性。
- bytearray(可变 8 位字节数组):元素必须是
0 <= x <= 255的无符号整型数值。专为网络传输拆包、硬件串口通信、多媒体流式拼接设计,支持与list完全一致的原地修改方法(如append、extend、切片赋值)。
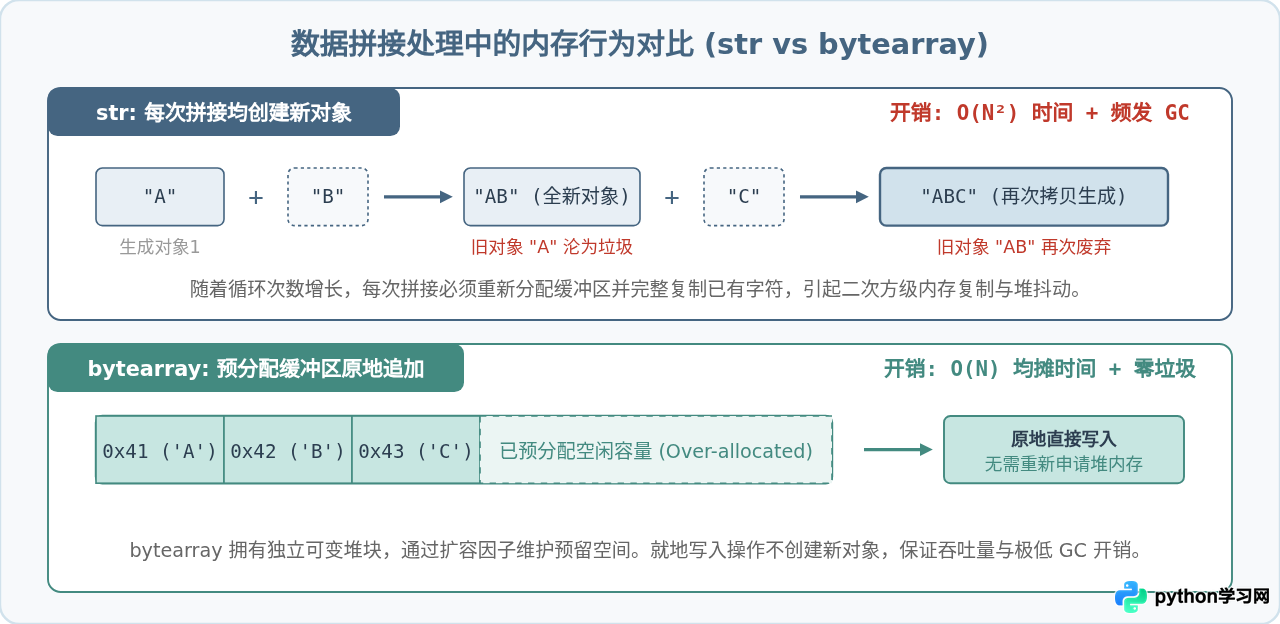
2. 循环拼接性能瓶颈对比
在网络数据包接收或流式文件读取场景中,如果使用不可变的 str 或 bytes 进行循环追加:data += chunk,每次循环都伴随着内存申请、旧内容全量拷贝及垃圾对象产生,算法复杂度为 $O(N^2)$。而使用 bytearray 进行原地扩展,则可以在预分配的连续内存块中直接追加,算法均摊复杂度降至 $O(N)$。
四、序列类型选型决策与推导步骤
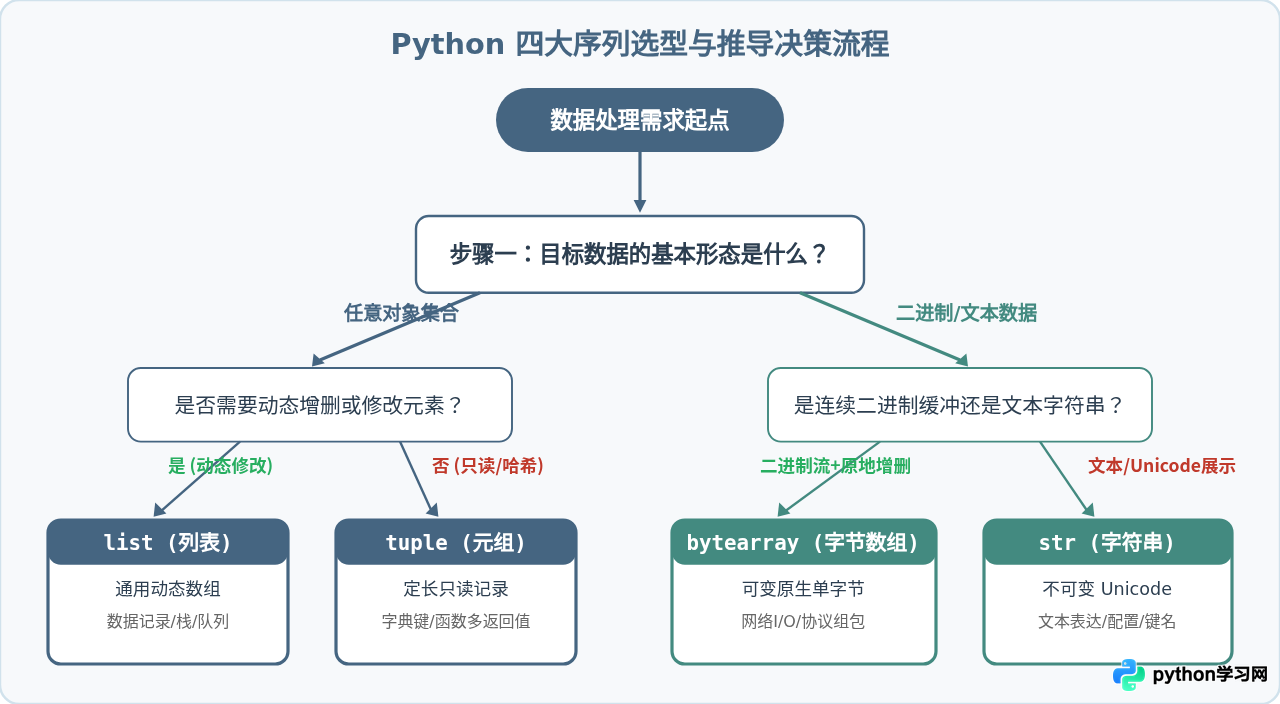
面对具体业务需求,选择序列类型时应遵循明确的推导流程:
- 识别数据内容形态:如果目标是自然语言文本,选用
str;如果是网络数据包、加密摘要、二进制图片流,进入二进制判断;如果是混合多样化的 Python 数据项集合,进入通用对象判断。 - 判断可变性需求:数据是否需要在生命周期内原地增删、插值或批量修改?
- 通用对象且需要动态变更:选
list; - 通用对象且只读、用作数据记录或字典键:选
tuple; - 二进制流且需要原位就地修剪、追加:选
bytearray; - 二进制流且作为固化协议包发送或哈希签名:选不可变的
bytes。
- 通用对象且需要动态变更:选
- 评估并发与安全限制:在多线程环境下,不可变序列(
str、tuple)天然具备线程安全特性,无需互斥锁保护即可安全共享;而可变序列在多线程并发读写时必须引入并发控制。
五、四大序列核心特性矩阵与对比总结
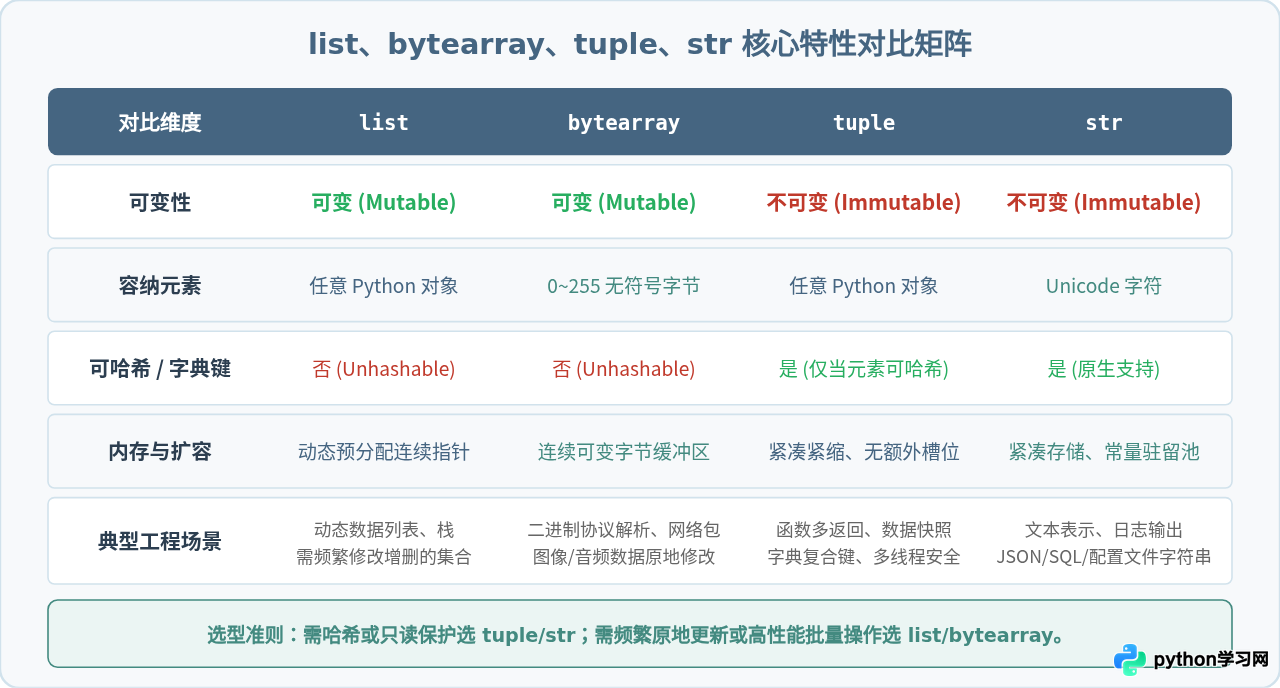
为了在工程开发中快速查验各序列的核心差异,下表归纳了四大序列在方法集、哈希性及内存特征上的详细对比:
| 类型 | 可变性 | 元素限制 | 哈希支持 | 特有核心方法 | 典型适用场景 |
|---|---|---|---|---|---|
| list | 可变 | 任意 Python 对象 | 不可哈希 | append(), pop(), extend(), sort() |
常规动态集合、数据收集栈/队列 |
| bytearray | 可变 | 0~255 无符号整数 | 不可哈希 | extend(), decode(), hex(), 原地切片修改 |
网络协议解包、二进制缓冲池、加解密中间态 |
| tuple | 不可变 | 任意 Python 对象 | 若元素均可哈希则支持 | count(), index()(仅只读检索方法) |
只读记录、函数多项返回、字典复合主键 |
| str | 不可变 | Unicode 字符 | 原生支持 | join(), split(), replace(), encode() |
用户界面文本、SQL/JSON 格式化、标识符 |
六、常见开发陷阱与最佳实践
由于可变与不可变对象在行为模式上的差异,实际编码中极易出现以下两类典型错误:
1. 函数默认参数使用可变序列
在 Python 中,函数定义语句 def 在模块加载时只执行一次,默认参数作为函数对象的内部属性存储。如果使用 list 作为默认值,该列表在多次函数调用之间被持久共享:
# 错误示范:列表默认参数累积
def add_item(item, target_list=[]):
    target_list.append(item)
    return target_list

print(add_item(1))  # 示例输出: [1]
print(add_item(2))  # 示例输出: [1, 2] (非预期!默认列表被污染)

# 正确做法:使用 None 哨兵
def add_item_safe(item, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(item)
    return target_list
2. 元组内嵌套列表时的增量赋值混淆
思考如下操作:t = (1, [2, 3]); t[1] += [4]。该语句会抛出 TypeError: 'tuple' object does not support item assignment,但在异常抛出后,列表内容却真实地变成了 [2, 3, 4]!
底层原因:t[1] += [4] 分为两步字节码操作:第一步执行原位追加(INPLACE_ADD),由于列表支持原地修改,列表本身成功扩展;第二步尝试将修改后的列表赋值回元组(STORE_SUBSCR),此时元组拒绝索引赋值并抛出异常。因此,应严格避免在不可变元组中存储可变对象并对其执行复合赋值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















