


爬虫技术是啥意思:通俗解释网络爬虫的工作原理

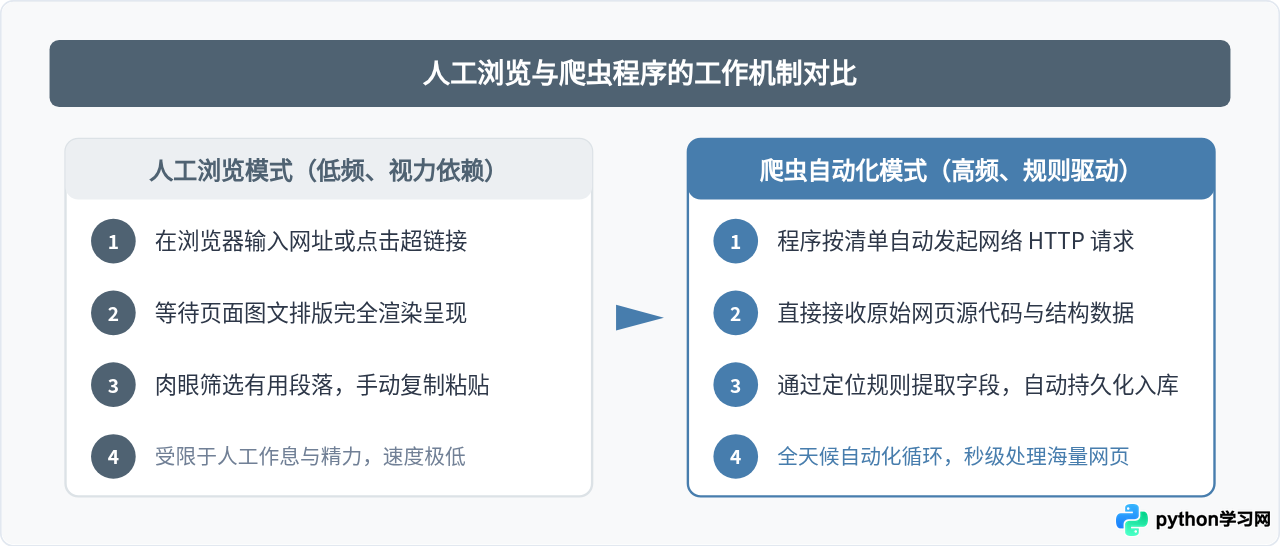
网络爬虫(Web Crawler)本质上是一种自动按照预设规则访问互联网并提取信息的程序。平时我们用浏览器查看网页,需要手动输入网址、点击链接、浏览文字并将有用的信息复制下来;而网络爬虫则是把这套“访问—浏览—复制”的过程转化为计算机代码,以毫秒级的速度不知疲倦地重复执行。本文将避开晦涩的学术定义,用生活化的比喻、清晰的运作流程图与代码示例,带你彻底看清网络爬虫的核心工作原理。
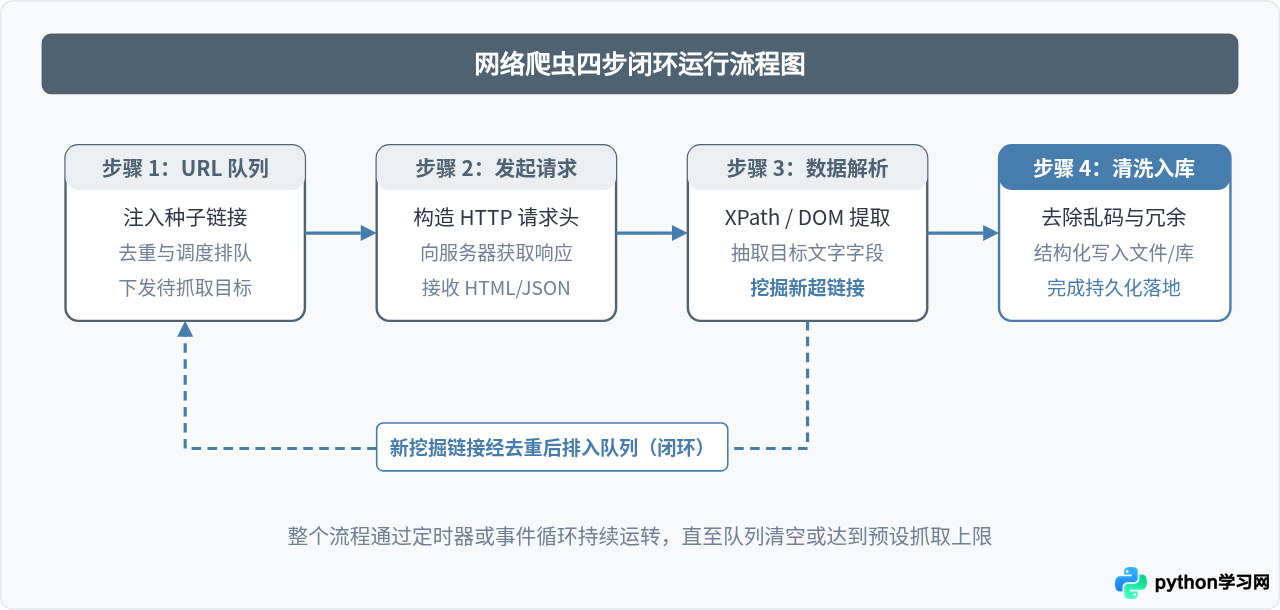
网络爬虫的核心四步工作链路
无论爬虫的规模是一个仅有几十行代码的小脚本,还是像搜索引擎那样分布式部署的巨型集群,它们底层的工作链路都可以归纳为四个连贯的步骤:构建链接队列、发起网络请求、解析提取内容、保存数据并发现新链接。
1. 维护 URL 待抓取队列
爬虫在开始运行前,必须知道“第一步该去哪”。工程师会预先给爬虫提供一批初始网址,这些网址在技术上被称为“种子 URL”(Seed URLs)。爬虫维护着一个 URL 队列,调度器会按照优先级和排队规则,源源不断地从队列里取出尚未访问的网址,指派给网络请求模块。
2. 发送网络请求并接收网页源码
拿到目标网址后,爬虫会利用网络通信库向存放该网页的服务器发送 HTTP 或 HTTPS 请求。服务器接收到请求并确认无误后,会返回相应的状态码(如 200 表示成功)以及页面的原始数据。在绝大多数情况下,这些原始数据就是 HTML 文本、JSON 格式字符串或 XML 文件。
3. 解析源码并定位有效信息
返回的 HTML 源码包含了整个网页的骨架,但混杂着大量的布局标签、样式代码与脚本。此时,爬虫会利用解析工具(例如 XPath、CSS 选择器或正则表达式)直接穿透无用代码,精准定位我们需要的字段——例如文章的发布时间、作者名称、正文文本或商品标价。与此同时,解析器还会提取页面中所有的超链接(<a href="...">),并将未抓取过的新链接重新放入待抓取队列。
4. 清洗、存储与闭环反馈
提取出的字段在保存前通常需要进行简单清洗,例如剔除多余的空格换行符、统一日期格式。处理完毕后,数据会被写入本地文件(如 CSV、JSON)或存入数据库(如 MySQL、MongoDB)。与此同时,新发现的有效链接经过排重处理,重新进入 URL 队列,驱动爬虫继续抓取下一页,形成自动循环的闭环。
看一段最基础的 Python 爬虫代码
在实际工程中,Python 是编写爬虫最常用的语言。下面这段仅有十几行的示例展示了爬虫如何向一个模拟网页发起请求并提取其中的标题和首段文本。这能帮助你建立具体的技术直觉:
import requests
from bs4 import BeautifulSoup

# 1. 确定目标网址并设置客户端标识(User-Agent)
target_url = "https://example.com"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

# 2. 发起 HTTP GET 请求获取网页源码
response = requests.get(target_url, headers=headers, timeout=5)

# 3. 检查通信状态(200 代表成功)
if response.status_code == 200:
    # 4. 解析 HTML 结构树
    soup = BeautifulSoup(response.text, "html.parser")

    # 5. 精准提取标题标签 <h1> 与段落标签 <p>
    page_title = soup.find("h1").get_text(strip=True)
    first_paragraph = soup.find("p").get_text(strip=True)

    print(f"提取到的标题: {page_title}")
    print(f"提取到的段落: {first_paragraph}")
else:
    print(f"请求失败,HTTP 状态码: {response.status_code}")
提取到的标题: Example Domain
提取到的段落: This domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.
爬虫与目标网站的交互规则与边界
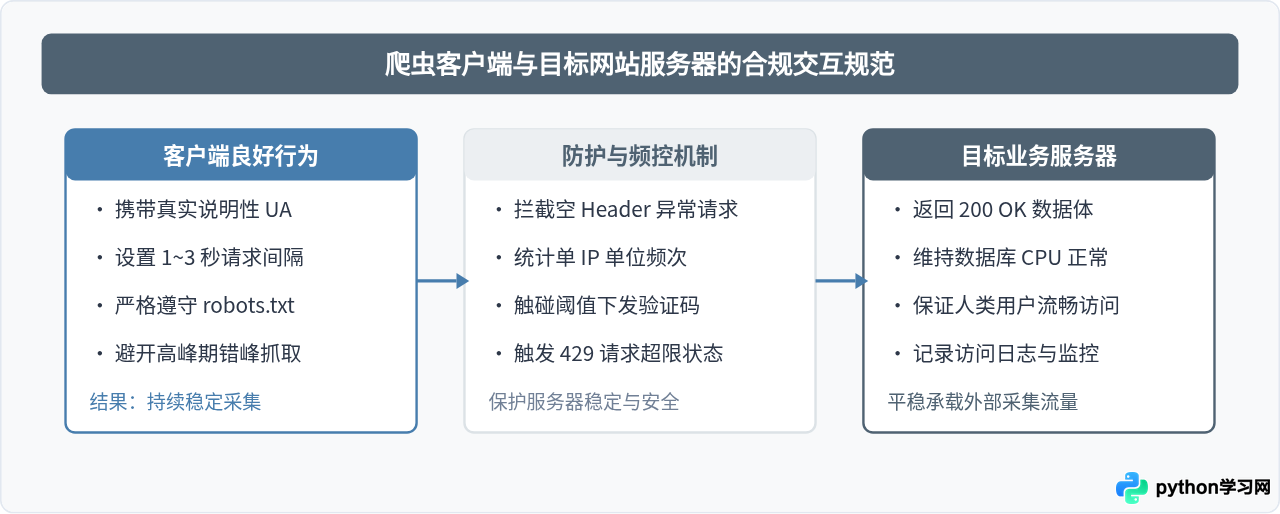
爬虫在互联网上抓取数据,绝非可以无节制地进行。目标网站的服务器资源是有限的,如果爬虫无限制地高频并发访问,就会占用过量带宽和 CPU,导致正常人类用户无法打开网页,甚至造成服务器崩溃。因此,规范的爬虫技术高度重视交互规则与安全合规。
1. Robots 协议(君子协定)
大多数网站都在根目录下放置了一个名为 robots.txt 的纯文本文件(例如 https://example.com/robots.txt)。它是网站管理者向爬虫发布的“告示牌”,明确规定了哪些目录允许爬取,哪些目录禁止访问。合规的搜索引擎与商业爬虫在抓取前,都会首先阅读该文件并主动避开禁止区域。
2. 网站常见的反爬虫机制
为了保障服务器性能和商业数据资产,网站通常会设置多种防护策略。常见反爬手段包括:
- User-Agent 校验:拦截没有设置浏览器身份标识的默认脚本请求。
- IP 访问频率限制:若检测到某个 IP 在一分钟内发送数百次请求,立即封禁该 IP 一段时间。
- 图形或行为验证码:弹出滑块验证码或字符验证码,阻断程序自动执行。
- 动态 JavaScript 渲染:网页初始源码仅为空白框架,具体数据通过前端异步请求动态拼装,普通基础爬虫无法直接拿到数据。
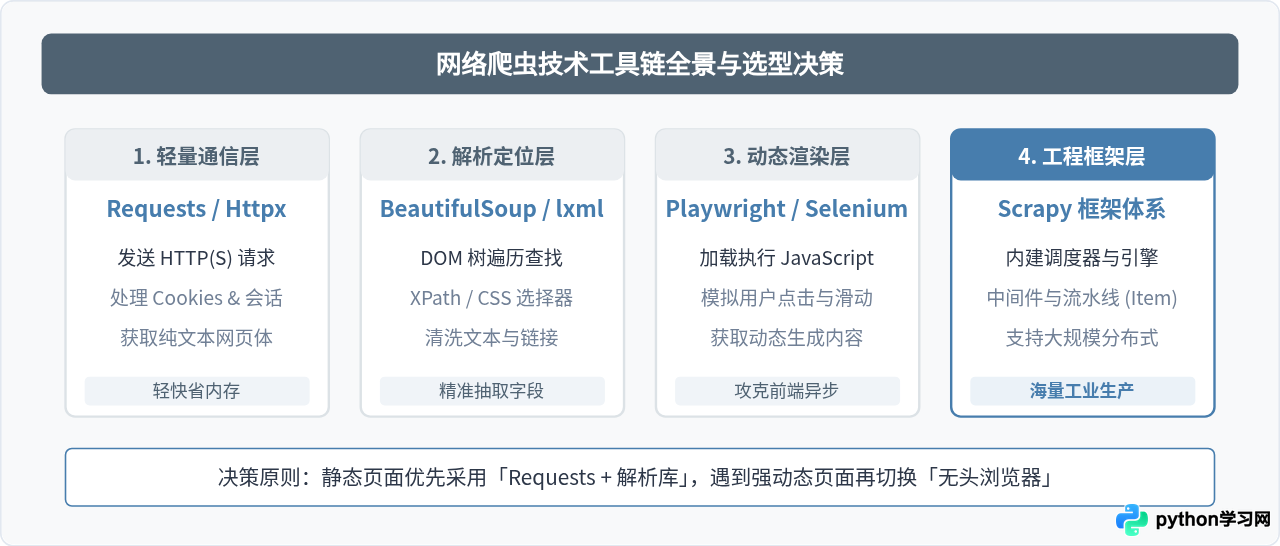
常见爬虫技术选型与工具全景
根据数据抓取难度和业务规模的不同,开发者通常会采用不同层级的工具组合。初学者不必一上来就追求复杂的工业框架,而是应当根据具体场景选择合适的解法:
| 技术层级 | 典型代表工具 | 适用核心场景 | 运行特征 |
|---|---|---|---|
| 静态网络请求 | Requests, Httpx, urllib | 纯静态 HTML 页面、公开 RESTful API | 速度极快、资源消耗低,无法执行 JavaScript 脚本 |
| DOM 解析定位 | BeautifulSoup, lxml, Parsel | 从返回的 HTML 文本中提取指定标签字段 | 语法直观,支持 CSS 选择器与 XPath 精准切片 |
| 无头浏览器驱动 | Playwright, Selenium, Puppeteer | 高度依赖 JS 动态渲染的单页应用(SPA)、需登录页面 | 真机模拟、支持点击滚动,但运行速度慢、内存消耗大 |
| 工业工程级框架 | Scrapy, Feapder | 全站百万级数据采集、多机分布式抓取 | 内建去重、多线程并发、中间件管道,工程体系完备 |
总结
网络爬虫在本质上并不神秘,它就是一段模拟网络通信并按规则筛选信息的自动化程序。从搜索引擎日常构建万亿级网页索引,到电商平台跟踪市场价格动态,再到科研机构聚合公共学术文献,网络爬虫早已成为数字世界信息流通的关键基石。理解“队列分发—发送请求—数据解析—持久入库”这套基本运转模型,并在实践中恪守版权规范与频率控制,就能安全、高效地发挥数据采集技术的实际价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















