


Python中urllib和requests访问网址有什么区别

urllib 与 requests 最根本的区别在于定位与封装层级。urllib 是 Python 自带的标准库,无需安装任何依赖即可使用,但其 API 偏底层,处理参数编码、Cookie 保持、JSON 交互与异常捕获时需要组装多个子模块;而 requests 是高度面向开发者的第三方库,基于 urllib3 构建,提供了符合直觉的高层接口,开箱即支持参数自动序列化、连接池复用与会话管理。简而言之:受限环境或纯标准库脚本用 urllib,常规开发与工程实践首选 requests。
一、架构定位与生态依赖层级
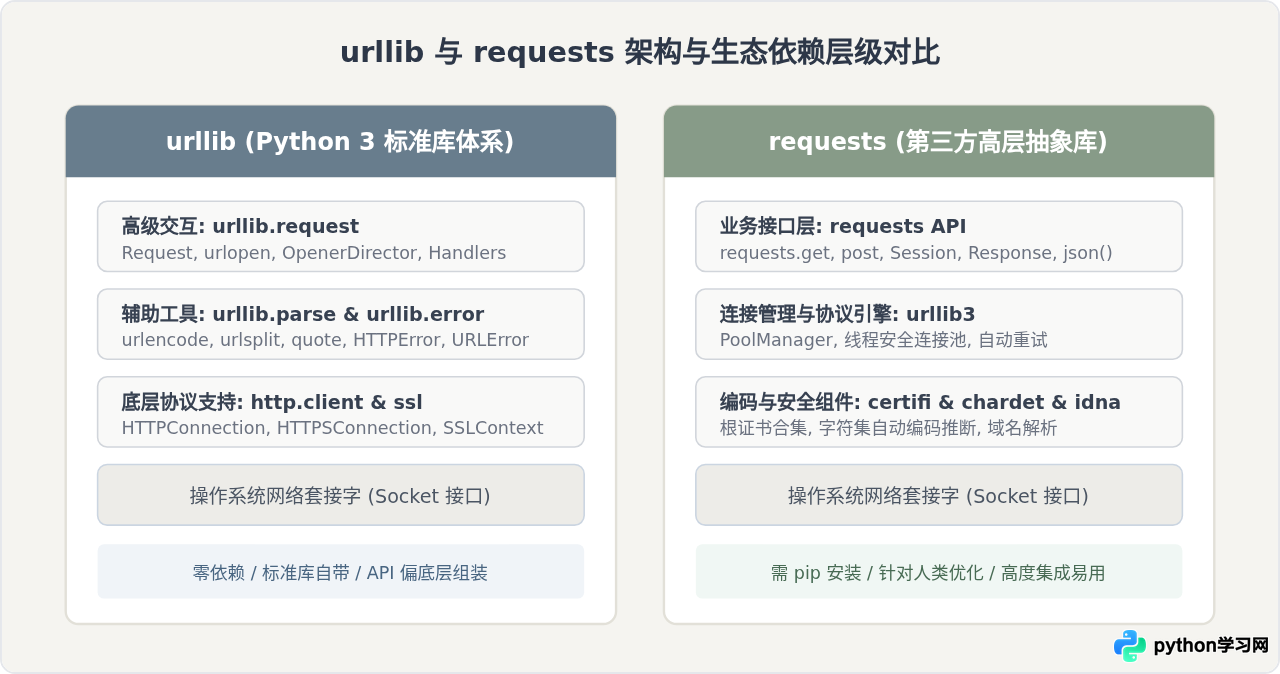
要理解两者的差异,首先需要厘清它们在 Python 网络技术栈中所处的位置。
urllib 并非单一的函数,而是 Python 3 标准库中一系列模块的集合,主要拆分为四个子模块:urllib.request(用于发送请求与打开 URL)、urllib.parse(用于解析和拼接 URL 参数)、urllib.error(定义异常体系)以及 urllib.response(内部响应对象)。它的底层直接构建在 http.client 与 socket 之上,遵循较为严格的底层协议规范。
requests 则是一个独立的第三方开源库,需要通过 pip install requests 安装。它的核心口号是“HTTP for Humans”(为人类设计的 HTTP 客户端)。requests 并不是重复发明轮子去直接操作 socket,而是站在成熟协议库 urllib3 的肩膀上,并深度集成了 certifi(安全根证书)、chardet/charset_normalizer(编码智能推断)与 idna(国际化域名解析)。
二、基础 GET 与 POST 请求编写对比
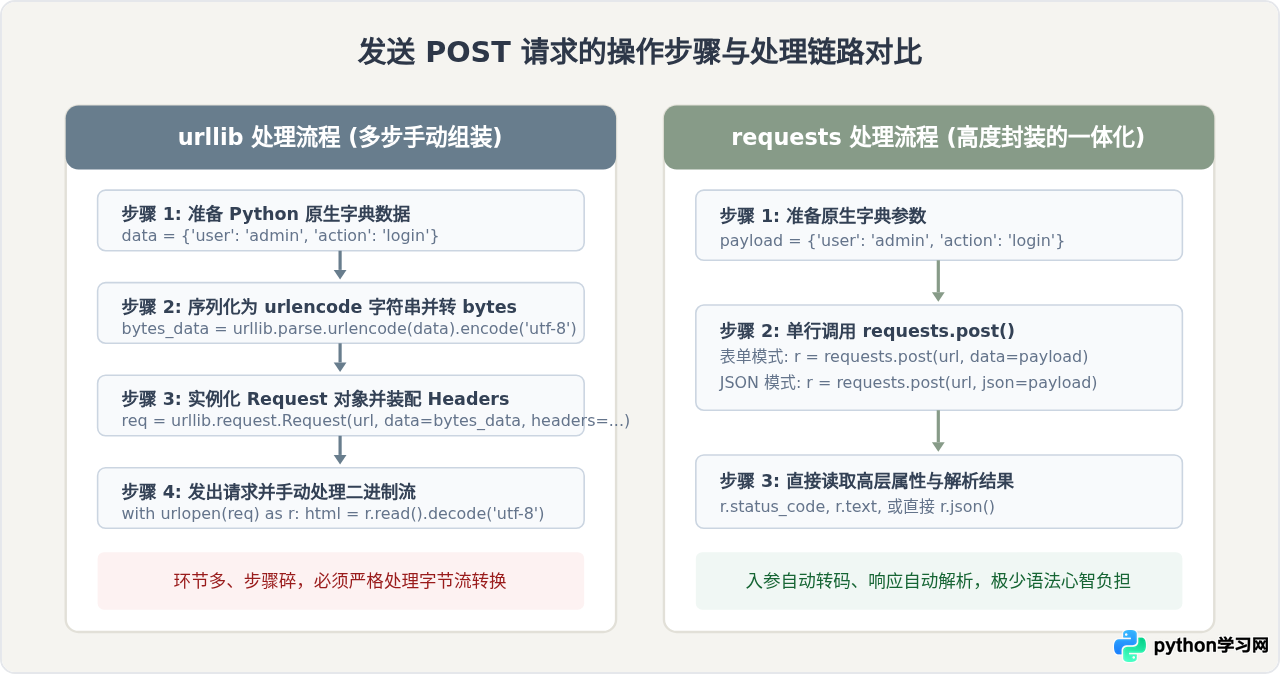
在实际编写代码时,两者的差异体现得尤为直观。我们通过最常见的带参数 GET 请求和 POST 表单请求来进行具体对照。
1. 发起带参数的 GET 请求
当向目标 URL 传递查询参数时,urllib 无法直接在主请求方法中接收字典类型的参数,开发者必须手动引入 urllib.parse 进行编码,并手动拼接问号字符串。此外,urlopen 返回的是原始二进制流,必须手动读取并指定字符集解码。
# 使用 urllib 发送 GET 请求
import urllib.request
import urllib.parse

params = {'keyword': 'python', 'page': 1}
query_string = urllib.parse.urlencode(params)
url = f"https://httpbin.org/get?{query_string}"

headers = {'User-Agent': 'Mozilla/5.0'}
req = urllib.request.Request(url, headers=headers)

with urllib.request.urlopen(req) as response:
    status_code = response.status
    content_bytes = response.read()
    content_text = content_bytes.decode('utf-8')
    print(status_code, content_text[:60])
换用 requests,代码量明显减少,逻辑也更加平铺直叙:参数直接通过 params 参数传入,返回的 Response 对象自动根据响应头推断字符编码,通过 .text 即可直接获取字符串。
# 使用 requests 发送 GET 请求
import requests

params = {'keyword': 'python', 'page': 1}
headers = {'User-Agent': 'Mozilla/5.0'}

response = requests.get("https://httpbin.org/get", params=params, headers=headers)
print(response.status_code, response.text[:60])
2. 发送 POST 表单或数据
在 POST 请求中,两者的处理流程差异更为显著。使用 urllib 发送数据时,必须确保传入 data 参数的是经过编码的 bytes 对象,而不能是字符串或字典。如果需要指定 Content-Type,也必须在构造 Request 对象时精确声明。
三、进阶网络功能处理机制差异
当业务需求超出单一请求,延伸到 Cookie 保持、JSON 数据反序列化或网络异常容错时,两者的架构设计差异体现得更加深刻。
1. Cookie 维护与会话保持(Session)
在模拟登录或连续访问需要身份凭据的网站时,服务端通常依靠 Set-Cookie 维持客户端状态。
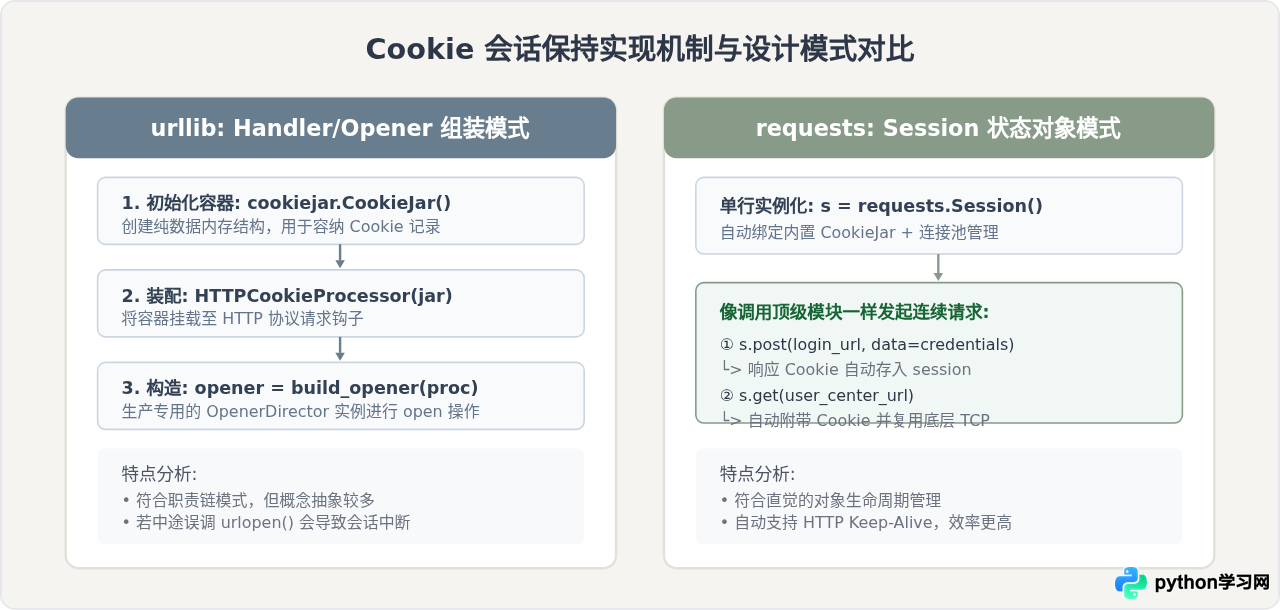
在 urllib 中,默认的 urlopen 每次调用都是完全独立的,不会保留任何 Cookie。如果需要保持会话,开发者必须引入 http.cookiejar 模块,实例化一个 CookieJar 容器,创建一个 HTTPCookieProcessor 处理器,再通过 urllib.request.build_opener 构造一个定制的 OpenerDirector 对象。后续所有的网络请求都必须通过该 opener 发送。
而在 requests 中,会话保持是第一公民。只需实例化一个 session = requests.Session(),后续调用 session.get() 或 session.post(),Cookie 将在内存中自动跨请求传递,无需手动管理。
2. JSON 数据交互支持
在当今的前后端分离及微服务架构中,大部分 API 通信都采用 JSON 格式。
-
在 urllib 中:发送 JSON 需手动调用
json.dumps()并在编码为字节流后传入,且必须显式声明请求头{'Content-Type': 'application/json'}。接收响应时,需手动json.loads(response.read().decode('utf-8'))。 -
在 requests 中:发送直接使用
requests.post(url, json=dict_data),底层会自动完成序列化并设置正确的请求头;解析响应直接调用response.json(),如果响应格式不符合 JSON 规范,则抛出明确的异常。
3. 异常捕获与响应状态码校验
urllib 将网络错误严格拆分为 urllib.error.HTTPError(服务器返回了 4xx/5xx 等错误状态码)与 urllib.error.URLError(断网、DNS 解析失败等网络传输层故障)。捕获时通常需要按继承关系由子到父分别编写 except 分支。
requests 则提供了一个根异常 requests.exceptions.RequestException,所有连接异常、超时异常与 HTTP 错误均派生于此。此外,requests 默认不会在遇到 404 或 500 时直接抛出异常,而是让开发者通过 response.status_code 判断,或者通过调用 response.raise_for_status() 主动将失败状态码转换为异常,这在编写流水线任务时极其灵活。
四、底层连接性能与超时机制
除了代码语法的繁简,两者在生产环境中的性能与网络连接策略也存在关键不同:
-
TCP 连接复用 (HTTP Keep-Alive):
urllib.request.urlopen默认倾向于“单次请求打开-关闭”模式,处理大量高并发或连续请求时,频繁的 TCP 三次握手和 TLS 握手会带来可观的时延;requests在 Session 级别天然具备基于urllib3.PoolManager的连接池复用能力,能自动保持长连接,显著降低高频请求下的网络开销。 -
超时颗粒度 (Timeout):在
urllib中,timeout参数是一个全局秒数;而requests允许传递元组timeout=(3.05, 10),分别精确控制“TCP 建立连接超时”与“服务器数据读取超时”,有助于防止在弱网环境中由于连接挂起而耗尽工作线程。
五、全维度选型决策参考
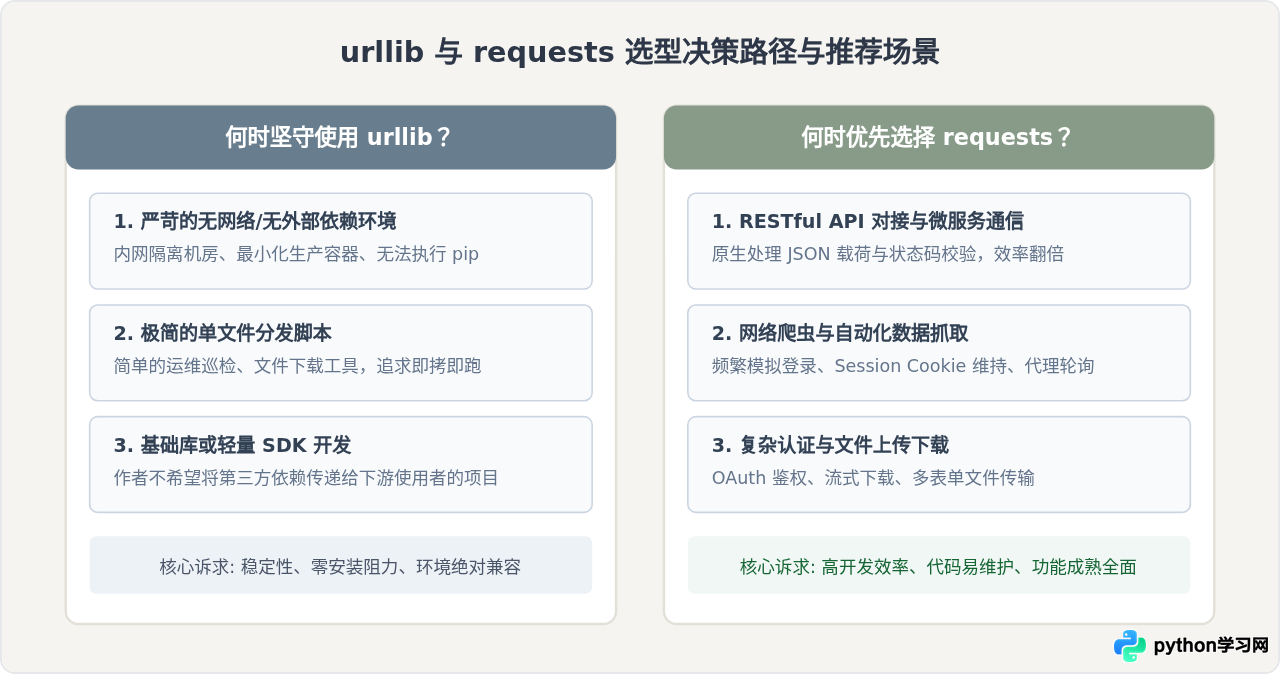
根据以上分析,我们可以从多个工程维度对两个工具进行系统总结,帮助你在实际开发中做出准确选择:
| 对比维度 | urllib (Python 标准库) | requests (第三方库) |
|---|---|---|
| 依赖情况 | Python 原生自带,零依赖 | 需额外执行 pip install requests |
| 接口友好度 | 偏向底层协议,组装繁琐 | 高度面向开发者设计,极简优雅 |
| POST / GET 参数 | 需手动 urlencode 并显式转为 bytes |
原生接收字典参数,自动序列化 |
| Cookie / 会话管理 | 需组合 CookieJar、处理器与 Opener |
requests.Session() 开箱即用 |
| JSON 交互 | 需手动 json.dumps() 与 loads() |
内置 json=... 与 .json() 方法 |
| 连接复用 | 默认不开启连接池复用 | 依托 urllib3 自动支持长连接复用 |
| 字符集编码推断 | 需手动从响应头提取或默认 utf-8 | 集成字符集探测,自动填充 .text |
六、日常使用中的关键注意事项
在实际编写网络请求程序时,无论选用哪一个库,都有两个极易出现疏漏的技术点需要特别留心:
在
urllib.request.urlopen 与 requests.get/post 中,如果不主动指定 timeout 参数,默认情况下网络套接字可能会处于永久阻塞状态。一旦目标服务器宕机或链路丢包,程序将永远卡在当前行,无法继续运行或释放资源。在生产代码中,必须始终设置明确的超时时间(例如 timeout=10)。
urllib 返回的字节流需要手动调用 .decode(),如果目标网站是 GBK 或 GB2312 编码而直接使用 utf-8 解码,会抛出 UnicodeDecodeError。而在 requests 中,如果发现 response.text 出现中文字符乱码,通常是因为服务器未在 Header 中声明 charset,导致其推断使用了 ISO-8859-1。此时可以通过在读取前指定 response.encoding = response.apparent_encoding,让底层 chardet 模块重新识别页面实际编码。
总结来说,urllib 与 requests 并不是水火不容的替代关系。urllib 保证了 Python 在任何纯净环境下都具备基础的 HTTP 通信能力,而 requests 则以精妙的高层抽象将复杂的网络交互变成了简单明了的几行代码。理解了两者的底层差别,便能根据手头的项目要求和部署约束,选择最合适的开发工具。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















