


为什么Python是写爬虫的首选语言?开发效率与生态优势解析

Python 成为网络爬虫开发首选语言的核心原因,在于其将极低的原型编写成本与高度特化的采集工具生态紧密结合。网络数据采集面对的是变动频繁、结构不一的异构网页,开发者的主要瓶颈通常不是计算机 CPU 的算力,而是分析目标结构、应对页面变动并快速提取有效字段的人力时间。从基础的网络请求、DOM 容错解析,到动态 JavaScript 渲染处理与工业级分布式爬虫框架,Python 拥有各阶段成熟且开箱即用的技术栈,使开发者仅需数行代码即可跑通全套数据提取流程。
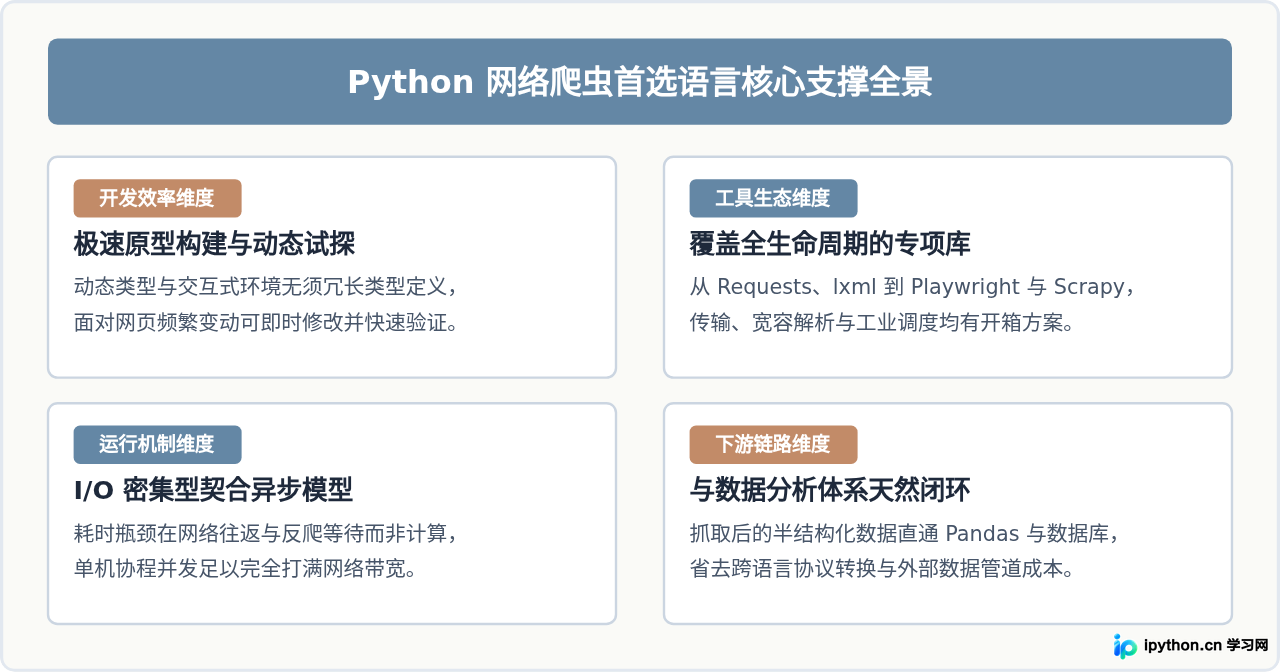
一、开发效率优先:为什么敏捷度决定爬虫工程的成败
网络爬虫区别于传统后台系统的最大特征在于其宿主环境的不可控性。目标网站随时可能重构前端结构、修改样式类名或增加反爬防护策略。在强类型静态编译语言(如 C++ 或 Java)中,开发者往往需要预先声明严格嵌套的数据模型类,并在编译阶段通过类型检查;一旦目标页面微调了层级,整个数据模型的重构成本极高。
Python 具备动态类型特性与灵活的内置数据结构(字典、列表与切片)。结合交互式编程环境(如 IPython 或 Jupyter Notebook),开发者可以在保持网络会话的同时,实时在控制台内探测 DOM 节点与接口返回值。字段提取规则从尝试到最终确认往往仅需数秒,这种试探性开发体验是编译型语言难以比拟的。
极简抓取实现示例
完成一个基础的静态网页抓取任务,在 Python 中只需安装 requests 与 beautifulsoup4 库:
# 依赖安装命令
pip install requests beautifulsoup4
以下代码展示了从目标页面获取 HTML 并提取指定列表字段的完整过程:
import requests
from bs4 import BeautifulSoup

url = "https://example.com/news"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

# 1. 发起网络请求
response = requests.get(url, headers=headers, timeout=10)
response.encoding = response.apparent_encoding

# 2. 宽容解析 HTML
soup = BeautifulSoup(response.text, "html.parser")
articles = []

# 3. 定位节点并清洗提取字段
for item in soup.find_all("div", class_="news-card"):
    title_tag = item.find("h2")
    link_tag = item.find("a")
    if title_tag and link_tag:
        articles.append({
            "title": title_tag.get_text(strip=True),
            "link": link_tag.get("href")
        })

print(f"提取完成,共获取 {len(articles)} 条数据。")
该脚本的执行输出明确如下(示例输出):
提取完成,共获取 12 条数据。
[示例数据条目: {'title': 'Python 数据分析核心指南', 'link': '/news/101'}]
在上述代码中,没有冗余的类型样板代码,复杂的 HTTP 协议握手、连接池重用与重定向均被封装在底层,代码重心完全集中在数据抽取业务本身。
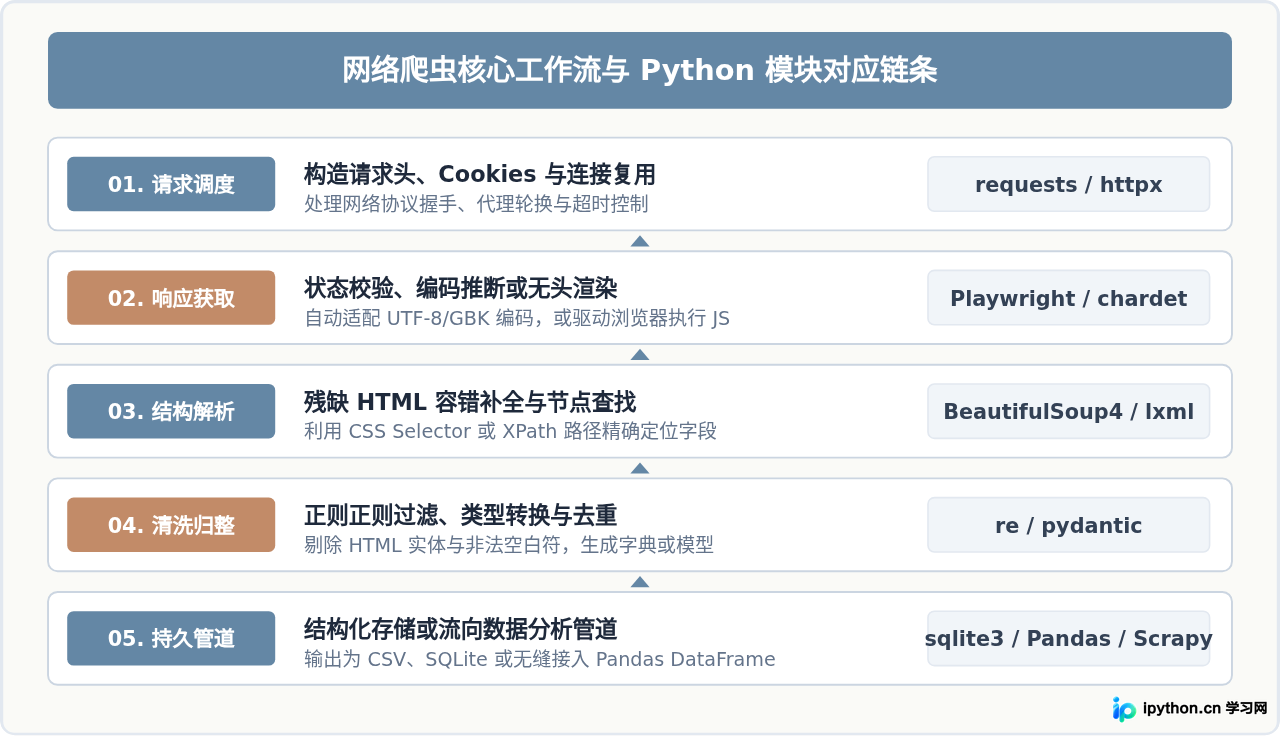
二、全生命周期工具生态:从简单脚本到工业级框架
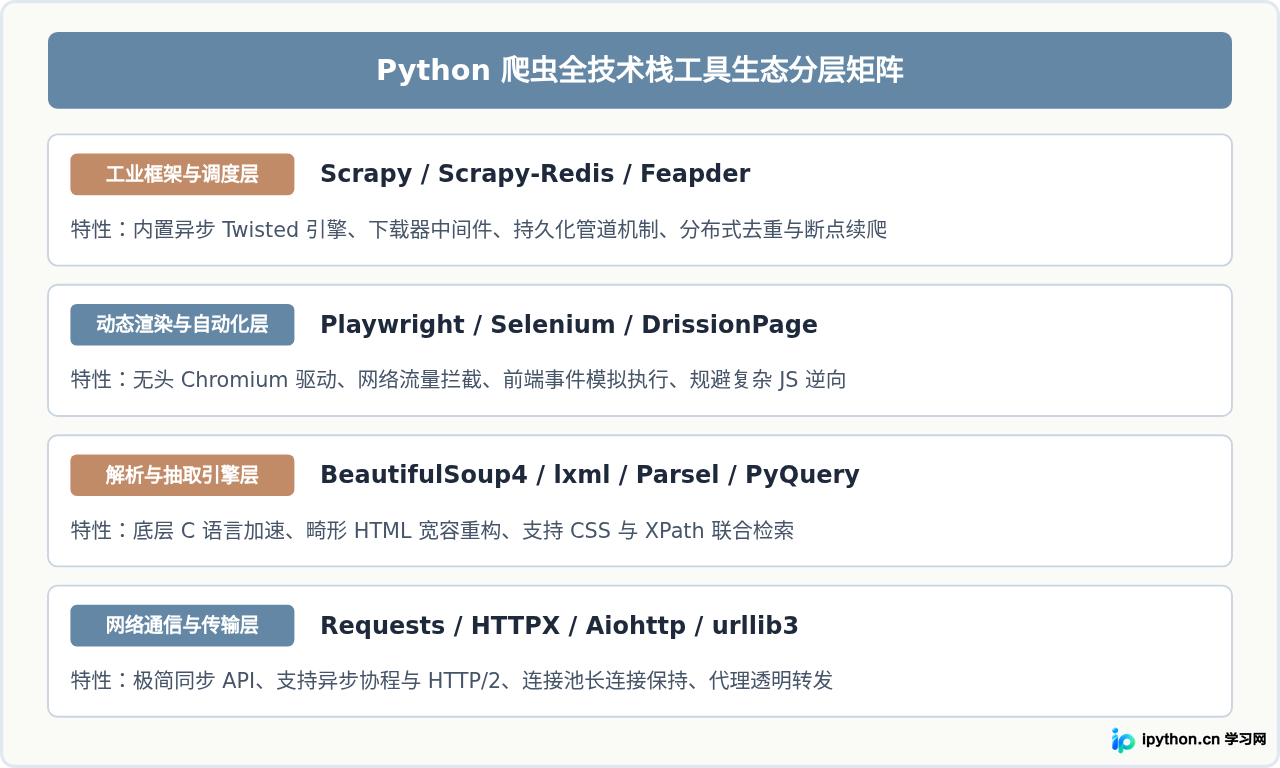
许多编程语言在网络请求或字符串匹配上表现不俗,但唯独 Python 在爬虫任务的每一个细分阶段都形成了兼顾易用性与极致性能的成熟工具生态:
1. 网络通信层:Requests、HTTPX 与 aiohttp
在基础 HTTP 通信方面,requests 凭借人性化的 API 事实性地定义了网络请求的标准规范。针对现代高并发场景,httpx 同时提供了同步与异步协程接口,并原生支持 HTTP/2 协议;而在纯粹的高吞吐异步采集场景下,aiohttp 能够以单线程事件循环轻松并发数千个长连接,且资源开销微乎其微。
2. 数据解析层:lxml、BeautifulSoup4 与 Parsel
真实生产环境中的网页通常存在大量不合法的 HTML 标签嵌套或闭合缺失。BeautifulSoup4 能够挂载 html5lib 或 lxml 解析内核,以极高的容错率重构 DOM 树。而基于底层 C 语言库编写的 lxml 则提供了纳秒级的 XPath 与 CSS 选择器检索速度,使得单机解析百万节点树形结构毫无卡顿。
3. 动态渲染与前端仿真:Playwright 与 Selenium
面对由 React、Vue 构建的单页应用(SPA)以及高频加密混淆的参数,传统逆向接口成本较高。Python 生态下的 playwright-python 提供了简洁可靠的现代无头浏览器驱动支持,具备智能等待、网络请求拦截、环境指纹伪装等能力,极大地降低了复杂动态网页的数据抓取门槛。
4. 工业级爬虫框架:Scrapy 与分布式扩展
当任务规模从单个网页扩展至全站亿级抓取时,手工管理调度队列和并发线程往往容易引发内存泄漏。Scrapy 提供了完整的事件驱动爬虫架构,内置请求调度器、去重指纹过滤器、下载器中间件(用于自动切换代理与请求头)以及存储管道(Pipeline)。结合 Scrapy-Redis 组件,可以分钟级搭建跨节点的分布式集群。
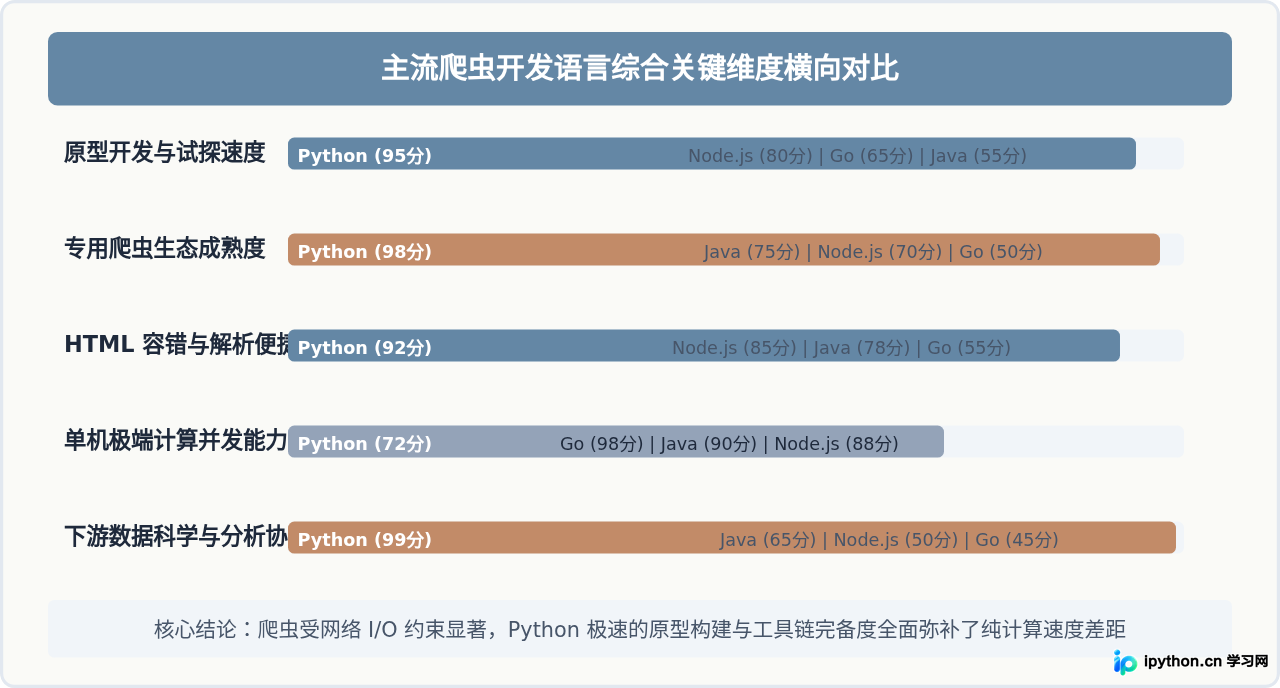
三、关键认知辨析:I/O 密集型任务与执行性能真相
在技术选型讨论中,常有观点提出:“Go 或 C++ 的运行性能远超 Python,为何不优先采用编译型语言开发爬虫?”这种观点混淆了 CPU 密集型任务与 I/O 密集型任务的本质区别。
网络爬虫在整个生命周期中,超过 90% 的耗时都消耗在网络传输往返(Round Trip Time, RTT)、DNS 查询以及目标服务器的人工延迟控制与反爬等待上。本地进行 DOM 解析与字符串提取通常仅需数毫秒。在这种业务场景下,纯 CPU 运算速度对整体总耗时的影响微乎其微。
借助 Python 的 asyncio 协程模型或多线程机制,单个 Python 进程即可维持数千个挂起的网络 I/O 状态。决定单机抓取吞吐上限的往往是出口带宽和代理 IP 的轮换速度,而非语言层面的计算性能。
| 对比维度 | Python | Node.js (JavaScript) | Go (Golang) | Java |
|---|---|---|---|---|
| 原型迭代速度 | 极高(动态语言、交互式调试) | 较高(事件驱动、JSON 友好) | 中等(强类型编译、样板多) | 偏低(代码冗长、重构较重) |
| 爬虫专用生态 | 完备成熟(各层级均有标杆库) | 良好(无头浏览器与接口抓取) | 偏弱(缺乏全能级工业框架) | 较好(WebMagic 等,更新放缓) |
| DOM 容错解析 | 极强(BS4 容错、lxml 高性能) | 优秀(Cheerio 语法同前端) | 一般(goquery 容错度有限) | 优秀(Jsoup 表现稳定) |
| 单机并发性能 | 良好(协程与多进程足够 I/O) | 极强(原生非阻塞事件循环) | 极强(原生 Goroutine 轻量高效) | 极强(线程池与虚拟线程完善) |
| 下游数据流转 | 绝对统治(Pandas/NumPy 无缝衔接) | 较弱(缺少系统级数据科学库) | 较弱(数据分析生态较单一) | 中等(偏向大数据架构中转) |
四、下游生态协同:从网页抓取到业务闭环的天然优势
网络爬虫从来不是孤立运行的软件,抓取本身只是数据链路的起点。数据入库之后的去重清洗、结构化规整、统计分析以及自然语言处理(NLP)才是产生业务价值的核心。
在 Python 中,通过爬虫提取到的字段字典,只需一行 import pandas as pd; df = pd.DataFrame(data) 即可直接转化为数据帧对象,随后可以无缝使用向量化计算、异常值过滤与统计聚合;若需要进行中文分词与命名实体识别,可以直接接入 jieba 或 spaCy。而在其他语言中,开发者往往需要将抓取数据以 JSON 或文件格式落盘,再通过管道中转给 Python 环境进行下游处理,这无疑凭空增加了架构复杂度与维护成本。
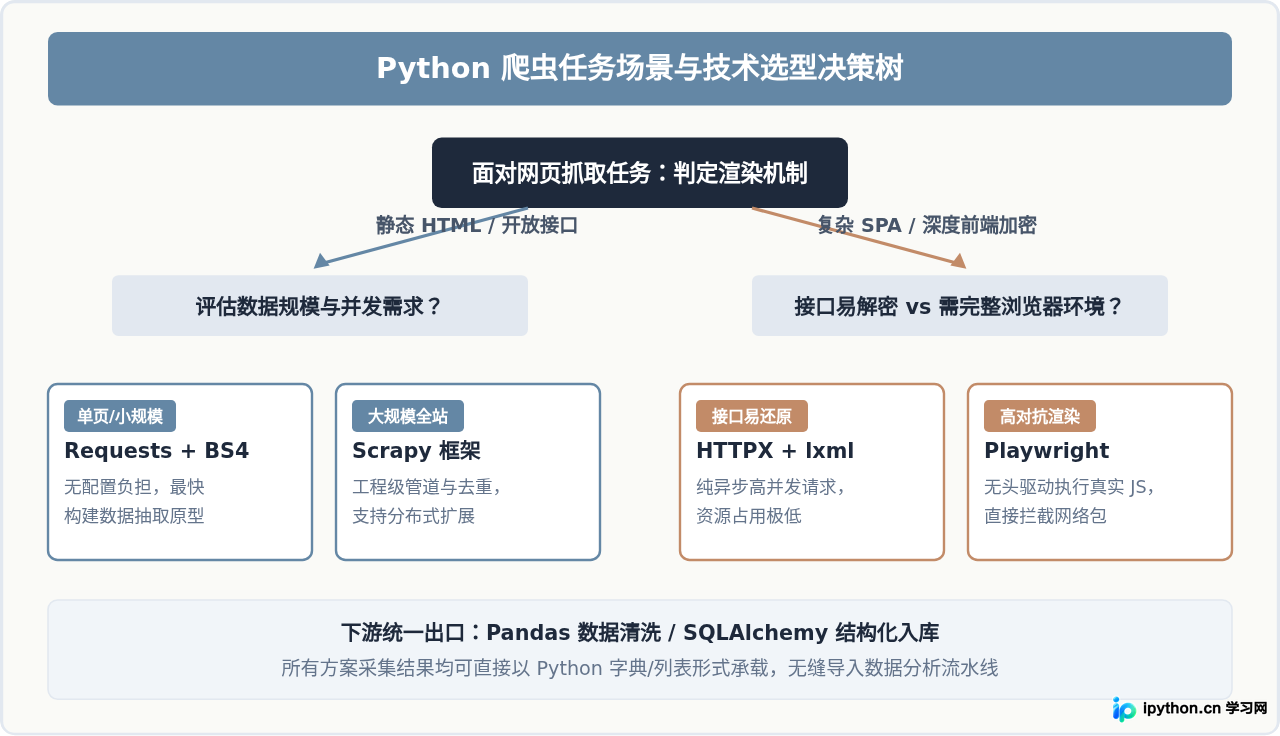
五、场景选型指南与高频注意要点
在实际项目落地时,应根据目标网站的渲染形态与数据吞吐规模,选择匹配的 Python 爬虫技术方案:
- 轻量级静态采集(小微项目/一次性任务):优先使用
Requests + BeautifulSoup4。学习曲线平缓,编写简易,10 分钟内即可完成原型上线。 - 重度动态渲染与高交互页面:采用
Playwright-Python。利用现代无头浏览器的网络监听功能,直接捕获页面底层 XHR/Fetch 的 JSON 响应,通常无需逆向混淆的前端 JS 代码。 - 千万级工业级全网抓取:直接选型
Scrapy + Scrapy-Redis。利用其成熟的非阻塞调度管道、连接重用机制与状态持久化架构,确保长时间无人值守运行的稳定性。
- 编码问题识别:使用
requests时,优先使用response.apparent_encoding替代默认的response.encoding,以防中文字符因 HTTP 头部标头遗漏而产生乱码。 - 必须设置连接超时:调用网络请求时务必显式传入
timeout=(3.05, 10)(连接超时与读取超时),避免因远程目标端口假死而导致单线程永久挂起。 - Session 连接池复用:循环发起连续请求时必须使用
requests.Session(),复用底层 TCP 握手连接,可提升 30% 以上的网络传输效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















