


Python词频统计中怎么用正则去除标点和统一大小写

在进行文本词频统计时,标点符号和大小写差异是导致统计数据失真的主要原因。例如,未清洗文本中的“Python”、“python”和“python,”会被计算机识别为三个互不相同的独立词项。解决这一问题的标准路径分为两步:首先调用字符串原生的 .lower() 方法将所有字符转换为统一小写,随后使用 Python 的 re 正则表达式模块,通过模式替换或直接词符提取剥离标点符号,从而得到干净整洁的词汇序列供后续统计。
一、文本预处理的标准处理顺序
词频统计的基础是保证词项标识的一致性。如果不对文本进行归一化,高频关键词的频次会被分散在各种大小写形式以及带有句号、逗号、感叹号的变体中。这就要求我们在将文本切分为单词列表之前,必须完成统一大小写与标点清洗两道工序。
在实际编码中,处理顺序直接影响效率和代码复杂度。常规做法是在整段字符串状态下先执行统一小写,然后再应用正则表达式进行标点剥离。整段字符串小写仅需一次方法调用,避免了分词后对列表中成千上万个独立单词逐个执行转换的开销。
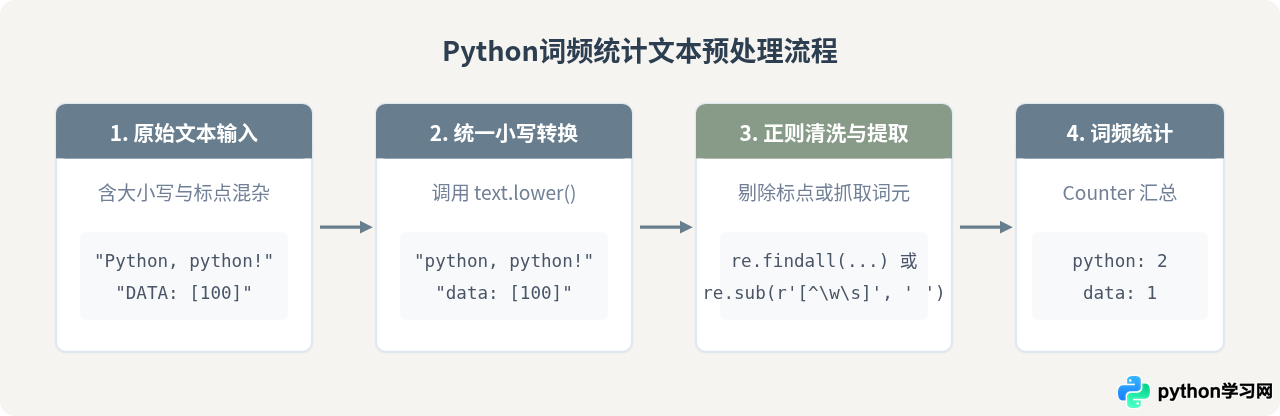
二、统一大小写的方法与关键要点
在 Python 中,统一大小写主要有两个原生方法可选:lower() 与 casefold()。对于绝大多数英语及常见西方语言文本,直接使用 str.lower() 即可满足需求;如果文本包含德语双 s(ß)等特殊西欧字符,casefold() 能提供更激进且符合 Unicode 标准的无大小写映射。
# 统一大小写示例
raw_text = "Natural Language Processing with Python is Fun!"
clean_text = raw_text.lower()
# 输出: "natural language processing with python is fun!"
统一大小写应放在正则清洗的前置阶段。将文本全部转为小写后,后续编写正则表达式时无需再额外指定 [a-zA-Z] 这样的大写范围,也无需附带 re.IGNORECASE 标志,能够显著降低正则匹配器的状态回溯与解析开销。
三、正则去除标点的两类核心实现路径
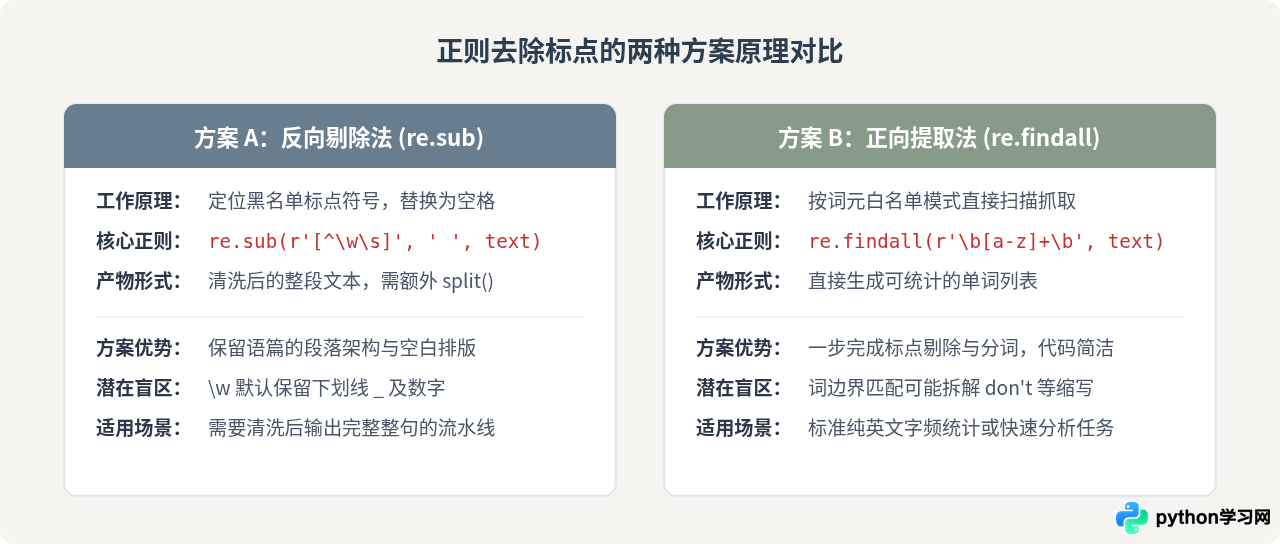
在 Python 正则表达式应用中,去除标点符号并获取单词通常有两种截然不同的技术思路:一种是基于 re.sub() 的“反向剔除法”,另一种是基于 re.findall() 的“正向提取法”。二者在工作机制和输出结果上存在关键差异。
1. 方案 A:使用 re.sub 进行反向剔除
该方案将所有非字母、非数字、非空白字符替换为空格,随后利用 str.split() 按空白切分出单词:
import re

text = "Hello, world! Welcome to Python 3.9: data-science is great."
# 先转小写
text_lower = text.lower()
# 将非字母数字及非空白字符替换为空格
cleaned_text = re.sub(r'[^\w\s]', ' ', text_lower)
# 按空白符切分成列表
words = cleaned_text.split()
# 结果: ['hello', 'world', 'welcome', 'to', 'python', '3', '9', 'data', 'science', 'is', 'great']这里的关键细节在于:必须替换为单个空格 ' ',而不能替换为空字符串 ''。如果直接替换为空,像 data-science 会被粘连成 datascience,改变了原本两个词的词义。
2. 方案 B:使用 re.findall 进行正向提取
该方案不再考虑文本中有哪些杂乱的标点,而是直接定义“合法单词”的模式特征,通过一次扫描直接提取出全部符合条件的单词列表:
import re

text = "Hello, world! Welcome to Python 3.9: data-science is great."
# 正向抓取所有纯英文字符组成的词元
words = re.findall(r'\b[a-zA-Z]+\b', text.lower())
# 结果: ['hello', 'world', 'welcome', 'to', 'python', 'data', 'science', 'is', 'great']
如果业务需求允许包含数字(例如技术名词 win10、utf8),可以将模式扩展为 r'\b[a-zA-Z0-9]+\b' 或使用单词边界 r'\b\w+\b'。
四、边界情况与容易忽视的细节
在真实业务文本中,标点往往不仅承担句子断句功能,还会参与词汇构词。如果使用过于粗糙的正则匹配,可能会破坏词汇本身的语义完整性。
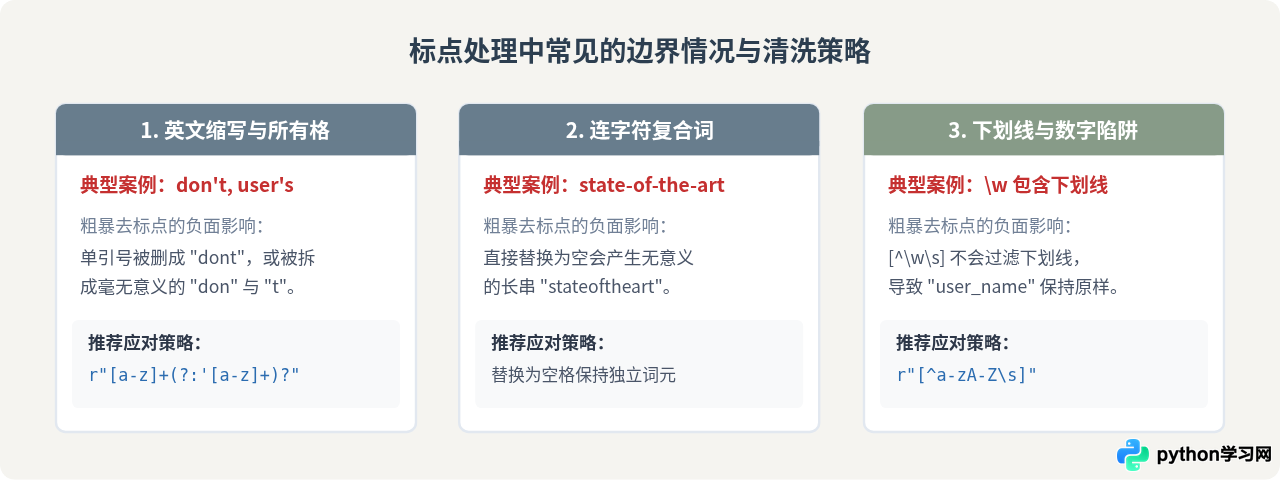
在设计正则表达式时,读者需要格外关注以下三个细节:
- 下划线不属于标点: 在正则标准中,元字符
\w等价于[a-zA-Z0-9_]。若使用[^\w\s]过滤标点,变量名或文本中的下划线_不会被清除。若要彻底去除下划线,应显式写入排除式,如[^\w\s]|_或直接声明白名单[^a-zA-Z\s]。 - 英文连字符的处理: 像
state-of-the-art这类复合词,若替换为空白则统计为 4 个单词;若作为专业术语整体保留,则需使用匹配内部连字符的规则(如r'\b[a-z]+(?:-[a-z]+)*\b')。 - 中英文标点混杂: 如果文本中出现中文句号(
。)、全角逗号(,)或破折号(——),ASCII 范围的string.punctuation无法处理它们,而正则的 Unicode 属性或明确指定字符范围则能完整覆盖。
五、完整实战示例与词频统计
下面是一个完整的可执行 Python 脚本,涵盖了原始文本读取、统一小写、正则清洗以及结合标准库 collections.Counter 的词频统计全流程:
import re
from collections import Counter

# 1. 模拟包含大小写混杂、标点混杂的输入文本
sample_text = """
Python is an amazing language! With Python, you can build web apps,
data pipelines, and AI models. Data analysis with python is powerful;
is it easy? Yes, Python's syntax is clean and pythonic.
"""

def extract_clean_words(text: str) -> list[str]:
    """统一小写并用正则提取单词"""
    # 步骤一:统一转为小写
    lower_text = text.lower()

    # 步骤二:使用正则提取纯单词序列(支持常见英文单引号所有格如 python's)
    # 如果不需要保留所有格单引号,可改用 r'\b[a-z]+\b'
    word_pattern = re.compile(r"\b[a-z]+(?:'[a-z]+)?\b")
    words = word_pattern.findall(lower_text)
    return words

# 2. 执行清洗与提取
words_list = extract_clean_words(sample_text)

# 3. 统计词频
word_counts = Counter(words_list)

# 4. 打印高频词结果(示例输出)
print(f"总计提取单词数: {len(words_list)}")
print("词频最高的前 5 个词项:")
for word, freq in word_counts.most_common(5):
    print(f"  {word:<10} : {freq} 次")
代码示例运行输出:
总计提取单词数: 27

词频最高的前 5 个词项:

  python     : 4 次

  is         : 4 次

  and        : 2 次

  an         : 1 次

  amazing    : 1 次
通过清洗,首字母大写的 Python、句末带感叹号的 language! 以及分号后的 powerful; 都被准确解构,python 和 is 均被精准汇总统计出 4 次,证明了预处理清洗的有效性。
六、词频统计预处理架构总结
构建稳健的词频统计管道时,应将文本处理划分为标准清晰的职责模块:首先是文本规范化层(小写化与字符编码对齐),接着是模式清洗与切分层(基于正则表达式执行规则过滤),随后进入统计聚合引擎(使用高效率的哈希计数结构),最后根据业务需要进行停用词过滤与排序呈现。
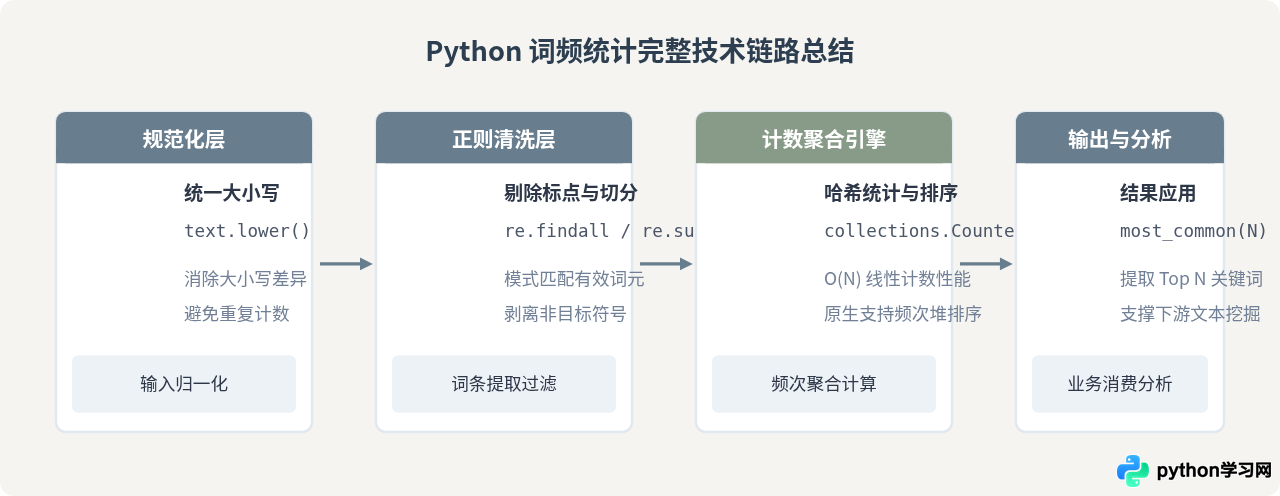
总结而言,在日常处理大多数英语文本或中英混排文本时,优先选用 text.lower() 配合精准的 re.findall() 正则模式,能以极高代码可读性与优异运行性能完成词频统计的前置清洗工作;若面对长文本结构清洗或多阶段流式处理,则可采用 re.sub() 搭配空格填充方案,稳妥规避词元粘连问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















