


Python可视化编程常见误区:为什么没有真正的“拖拽生成复杂业务”平台?

在日常技术讨论或项目规划中,一个高频出现的设想是:“既然少儿编程能拖积木生成Python脚本,大数据分析有拖拽式ETL工具,为什么业内至今没有一个纯拖拽的开发平台,能够完整生成电商核心交易、多租户ERP或高并发金融结算这类复杂业务系统?”
核心原因在于:业务系统的本质复杂度来自状态管理、异常容错、分支组合与团队协作,而非语法符号的输入方式。图形化节点在表达确定性、单向流转的管道任务时极其直观,但一旦引入环状分支、异步回调、动态多态和分布式锁,可视化的图元与连线就会在短时间内演变成认知负荷巨大的“意大利面条图”(Spaghetti Graph)。真正的工程瓶颈不在于“能不能用图形连出来”,而在于“连出来之后系统如何调试、如何合并代码,以及如何长期维护”。
误区一:混淆“工作流编排”与“通用业务逻辑”
初学者容易将 Apache Airflow、Prefect、Node-RED 这类可视化工具的成功,误判为“所有业务都可以拖拽完成”。这两者所处理的问题模型有着根本差异:
- 工作流编排(Pipeline / DAG):节点本身是封装好的黑盒功能模块(如“读取S3文件”、“执行SQL脚本”、“发送HTTP请求”)。数据沿有向无环图单向流动,节点内部没有细粒度的跨分支交互,状态只存在于输入和输出。
- 通用复杂业务(Business Logic):逻辑由密集的条件判断、闭包嵌套、数据结构映射和跨事务回滚构成。同一个实体对象在不同流转节点中可能存在数十种瞬时状态与边界拦截。
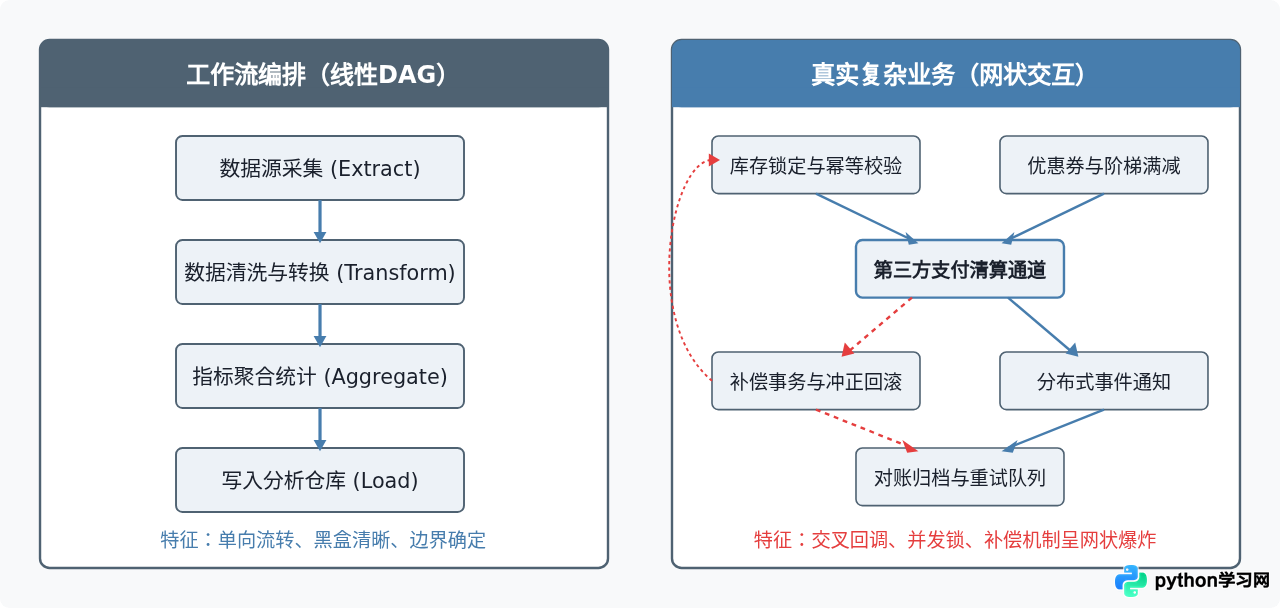
当开发者试图用“连线”去表达“若超时未响应则触发局部冲正,但若冲正失败需打上审计标签并挂起状态机”这一逻辑时,几条交叉的虚线就足以让图形编辑区彻底丧失可读性。代码语言使用条件语句、异常捕获块和装饰器,可以在一屏文本中建立高度精确、层级严密的控制流,这正是纯图元连线无法比拟的高信息密度特性。
误区二:低估了代码在“版本控制与团队协作”中的统治地位
现代工程开发不是单兵作战,一个成熟业务系统通常由多名工程师同时迭代。基于纯文本的 Python 代码与 Git 体系配合时,每一次变更都有明确的文件、行号、上下文 Diff 以及 blame 溯源记录。
而几乎所有的可视化拖拽平台,其背后的保存产物都是大型的 JSON 或 XML 元数据树结构。当两个人分别在画布上拖拽节点、修改连线或微调属性时,底层生成的结构体可能发生整块树重构:
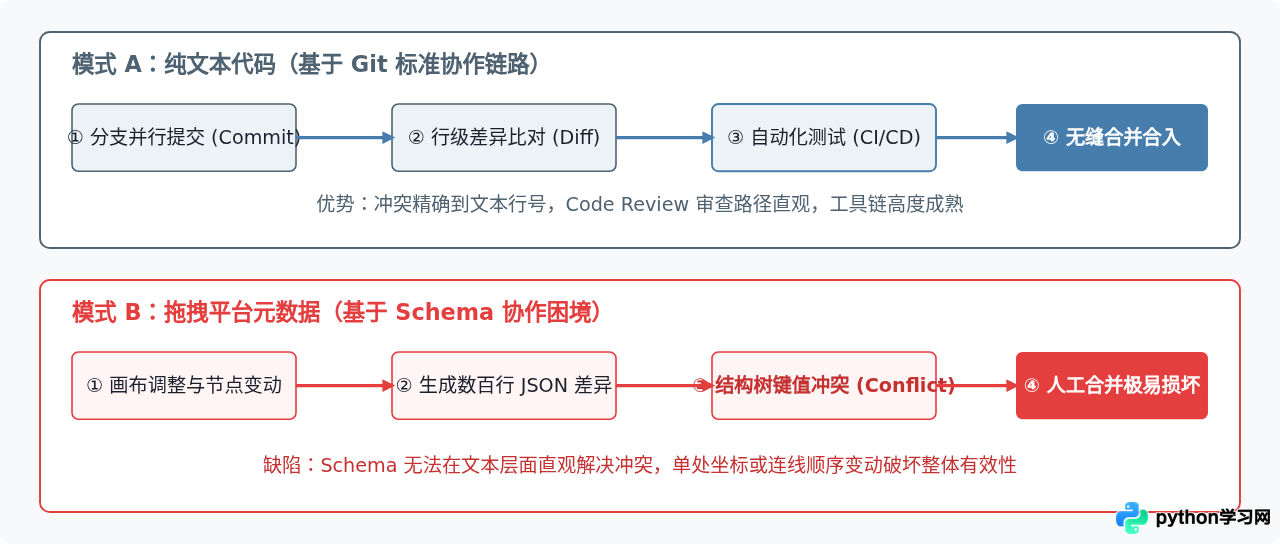
在拖拽平台中,一旦出现合并冲突,Git 无法告诉工程师“这一段连线在逻辑上代表什么”,只留下数千行毫无语义可读性的坐标和节点ID变更。解决这种冲突往往需要推翻画布重新拖拽,协作成本呈几何倍数增加。
误区三:认为“拖拽”能免去“系统调试与边界处理”
软件工程中有一条著名经验法则:编写初版功能只占 20% 的时间,剩下 80% 的精力都在处理异常、脏数据、边界测试和生产故障排查。可视化拖拽工具表面上消除了语法错误,却给运行时排查制造了巨大的“黑盒隔离”。
在 Python 原生开发中,出现错误时解释器会提供完整的堆栈追踪信息(Stack Trace):
Traceback (most recent call last):
  File "orders/settlement.py", line 84, in calculate_tax
    return amount * user.profile.tax_rate
AttributeError: 'NoneType' object has no attribute 'tax_rate'
工程师能在一秒内定位到具体的模块、函数、精确行号以及变量状态。而在拖拽平台中,底层运行时由引擎动态解释执行,报错往往退化为统一的包装异常:
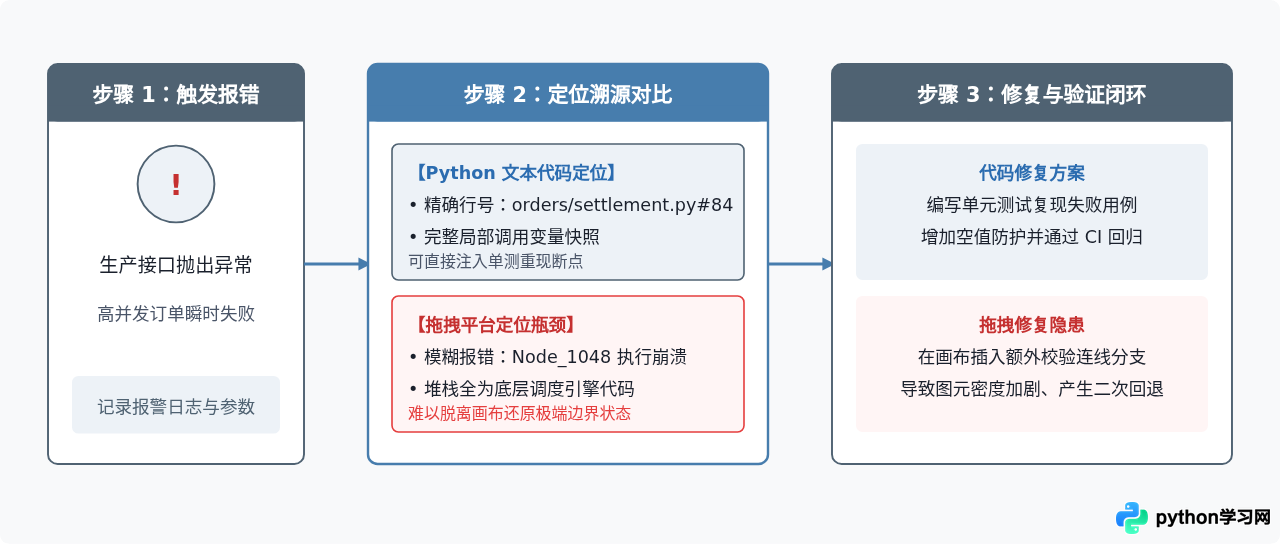
在没有单元测试框架(如 pytest)深度契合的情况下,拖拽平台的每一次“热修复”都像是在盲盒里换零件,极易在修补一个边界条件时引发另一处隐蔽的空指针或死锁。
务实的工程解法:代码驱动核心,可视化服务边缘
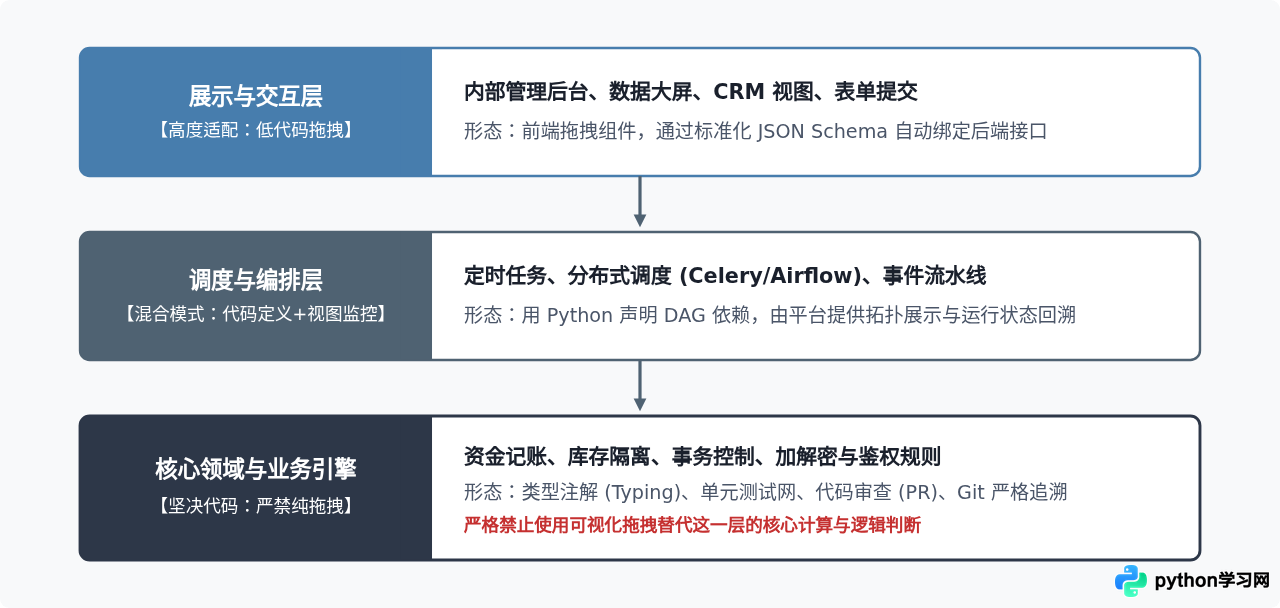
既然“纯拖拽生成复杂业务”是一个违背软件工程规律的伪命题,那是否意味着可视化在企业开发中毫无价值?并不是。现代技术架构普遍采纳的是“分层解耦”模型,让代码和可视化各自在擅长的领域发挥最大价值:
- 核心领域层(Domain Core):坚决采用 Python 原生代码。包含数据模型(如 SQLAlchemy / Pydantic)、事务边界、状态机流转与底层算法。利用面向对象或函数式编程的高密度语法,确保业务规则严谨、测试覆盖率达标。
- 流程协同层(Orchestration):采用“代码定义,界面呈现”(Code-as-Configuration)。例如 Airflow 或 Celery 任务,逻辑是用纯 Python 代码编写的 DAG,但平台提供极其清晰的可视化监控看板,方便运维人员查看执行进度与重试失败任务。
- 运营交互层(Admin & UI):采用低代码表单与报表工具。对于内部人员使用的增删改查(CRUD)后台、数据统计图表,使用可视化拖拽工具快速搭建界面,直接与后端暴露的 RESTful / GraphQL API 对接。
总结
软件工程发展的几十年间,“让非技术人员通过画图生成系统”的愿景被反复提及,但从早期的 UML 图形代码生成器,到如今的各类无代码方案,这一构想在面对真实生产环境的复杂业务时始终受阻。这并非因为工具开发者的实现能力不足,而是因为软件的复杂度具有不可压缩性。
可视化工具的真正价值在于降低展示与简单流转的门槛,而 Python 文本代码则是人类精确表达严密逻辑、应对边界异常与实施工程协作的最成熟载体。认清两者的适用边界,不盲目追求“全拖拽开发”,才是务实高效的技术决策。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















