


Python序列类型有哪些:list、tuple、str等内置类型详解

在 Python 中,序列(Sequence)是一类非常基础且核心的数据结构。序列的本质是支持通过非负整数索引按位访问元素、具有明确先后顺序的有序集合。Python 标准库内置了丰富的序列类型,涵盖了日常开发所需的绝大多数场景:最常见的包括可变列表 list、不可变元组 tuple、文本字符串 str、数值区间 range,以及用于底层二进制数据交互的 bytes 与 bytearray。本文将系统拆解这些内置序列类型的分类维度、通用操作、底层机制与选型依据,帮助读者建立清晰完备的序列知识体系。
一、Python 内置序列全景与核心分类
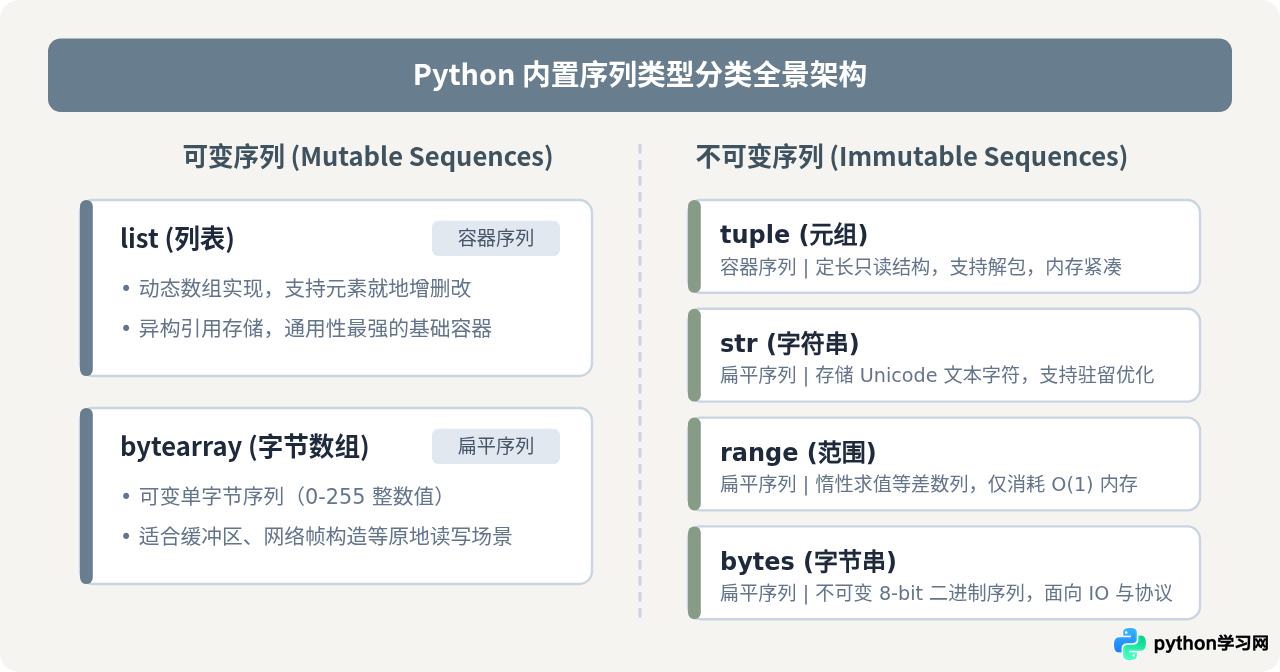
理解 Python 序列类型的最佳切入点不是死记每个类型的 API,而是掌握两个关键分类维度:可变性(Mutability)与元素存储机制(Container vs Flat)。
- 按可变性划分:
- 可变序列(Mutable Sequences):创建后可以就地修改其内容、扩充或缩减长度。内置核心代表是
list和bytearray。 - 不可变序列(Immutable Sequences):一旦在内存中初始化完成,其长度和每个位置上的引用均不可改变。内置代表为
tuple、str、range和bytes。不可变性不仅带来了数据安全性,也使得不可变序列(若其包含元素亦不可变)能够参与哈希计算,从而作为字典的键或集合的元素。
- 可变序列(Mutable Sequences):创建后可以就地修改其内容、扩充或缩减长度。内置核心代表是
- 按存储机制划分:
- 容器序列(Container Sequences):存放的是对象的内存引用(指针)。容器序列内部可以容纳任意不同类型的 Python 对象,甚至可以嵌套自身。典型代表是
list和tuple。 - 扁平序列(Flat Sequences):在连续内存块中直接存放值本身的紧凑字节或字符,而不是对象指针。扁平序列仅能保存特定单一类型(如字符、机器级字节)。典型代表包括
str、bytes和bytearray。这种结构大幅降低了内存开销,连续读取速度极快。
- 容器序列(Container Sequences):存放的是对象的内存引用(指针)。容器序列内部可以容纳任意不同类型的 Python 对象,甚至可以嵌套自身。典型代表是
二、序列通用的基础语法与索引切片机制
所有 Python 序列都遵循通用的接口协议,这意味着无论面对的是字符串、列表还是元组,一套标准的访问和计算语法都能通用无阻。
1. 核心通用操作
- 成员检测:使用
item in seq或item not in seq判断元素是否存在,返回布尔值。 - 序列连接与复制:使用
seq1 + seq2实现连接合并,使用seq * n实现内容浅复制倍增。 - 聚合与查询函数:
len(seq):在 $O(1)$ 时间复杂度下直接返回序列长度(Python 在序列头部维护了元素计数)。min(seq)与max(seq):检索序列中的最小或最大值。seq.index(x):定位目标元素x第一次出现的索引位置;若不存在则抛出ValueError。seq.count(x):统计目标元素x在序列中出现的总次数。
2. 索引与切片的步进机制
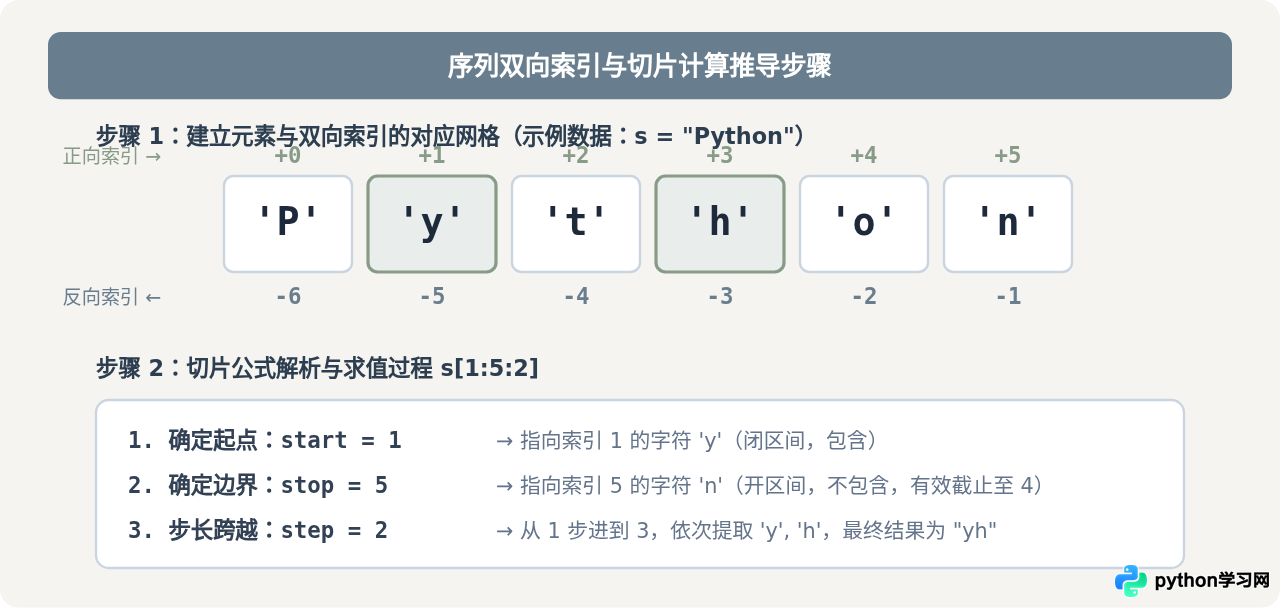
Python 序列支持双向索引:正向索引从 0 开始递增至 len - 1;反向负索引从 -1(最后一个元素)递减至 -len。
切片语法统一为 seq[start:stop:step],其核心计算原则是左闭右开区间(包含 start,但不包含 stop)。当 step 为正数时,从左向右提取;当 step 为负数时,从右向左反向提取。
三、核心三大主流序列:list、tuple、str
1. 列表(list):动态数组容器
list 是 Python 中使用频率最高的序列。其底层实现为连续的指针数组,具备动态扩容机制。当列表容量饱和时,Python 会以超额分配因子分配一块更大的内存,并将旧指针拷贝过去,这使得 list.append() 具备摊还 $O(1)$ 的优异性能。
# 列表初始化与基础就地修改
fruits = ["apple", "banana", "cherry"]
fruits.append("date")        # 尾部添加,时间复杂度 O(1)
fruits.insert(1, "mango")    # 指定位置插入,涉及后续元素指针搬移,时间复杂度 O(n)
fruits[0] = "avocado"        # 按索引更新元素引用,时间复杂度 O(1)
print(fruits)                # 示例输出: ['avocado', 'mango', 'banana', 'cherry', 'date']
2. 元组(tuple):不可变记录集合
tuple 常被初学者简单当成“只读的 list”,但其设计初衷具有更丰富的语义:元组非常适合作为无字段名的轻量级记录(Record),例如表示坐标 (x, y)、RGB 颜色值 (255, 255, 0) 或数据库单行结果。
由于元组的不可变性,Python 会对其进行内存优化:长度小于 20 的元组在被回收时,其结构体可能被缓存进空闲列表,免除重复申请内存的开销。元组同时天然支持优雅的解包操作(Unpacking):
# 元组打包与解包
point = (10, 20, 30)
x, y, z = point             # 基础解包
first, *rest = point        # 带星号的扩展解包: first=10, rest=[20, 30]
3. 字符串(str):Unicode 文本的扁平序列
Python 3 中的 str 是定长的 Unicode 字符序列。为了兼顾国际化字符与紧凑内存,CPython 采用了 PEP 393 灵活字符串表示机制:根据字符串内最大的字符码点,自动选择使用 1 字节(Latin-1)、2 字节(UCS-2)或 4 字节(UCS-4)来均匀存储每个字符。这既确保了所有字符按索引定位均为 $O(1)$ 常数时间,又杜绝了西文字符占用 4 字节的浪费。
str 是不可变的,任何修改、拼接操作都会生成全新的字符串对象。在大量拼接字符时,应优先使用 str.join() 而不是循环使用 +:
# 高效字符串构建
words = ["Python", "Sequence", "Guide"]
sentence = " ".join(words)   # 预先计算总长度后一次性分配内存,性能 O(N)
四、常被忽略但关键的序列:range、bytes 与 bytearray
1. 范围(range):空间复杂度为 O(1) 的数字序列
range 对象是一个纯粹的算术级数不可变序列。与生成实际数字列表不同,range 对象无论范围涵盖 10 个数字还是 10 亿个数字,其内存占用永远恒定且极小。它仅在内部记录 start、stop 和 step 三个整数属性,当被索引或遍历时才动态计算出对应位置的值。
# range 的惰性计算特性与内存常数级表现
r = range(0, 1000000000, 5)
print(r[2])      # 示例输出: 10 (直接通过数学公式 start + index * step 计算,耗时 O(1))
print(15 in r)   # 示例输出: True (依据算术规律直接取模判定,耗时 O(1))
2. 二进制序列:bytes 与 bytearray
在网络套接字通信、文件二进制读写、加密散列及图像媒体处理中,字符概念退化为底层的连续字节(0~255 的整数序列)。Python 为此提供了两个专门的序列类型:
bytes(不可变字节序列):语法前缀以b''声明,如b"hello"。内容固化,线程安全且可哈希。bytearray(可变字节数组):支持像list一样进行切片赋值、append和extend,专门用于高性能内存缓冲区(Buffer),能够避免频繁的内存重新分配与数据拷贝。
# bytes 与 bytearray 对照使用
raw_bytes = b"\x00\x0f\x20"         # 不可变字节序列
buffer = bytearray(raw_bytes)      # 转换为可变字节数组
buffer[0] = 0xff                   # 就地修改单字节
print(bytes(buffer))               # 示例输出: b'\xff\x0f '
五、深度解析:list 与 tuple 的底层内存与引用机制差异
许多开发者好奇:既然 tuple 能做的事情 list 几乎都能做,为什么 Python 还要单独设计 tuple?核心原因就在于内存布局差异与哈希安全性。
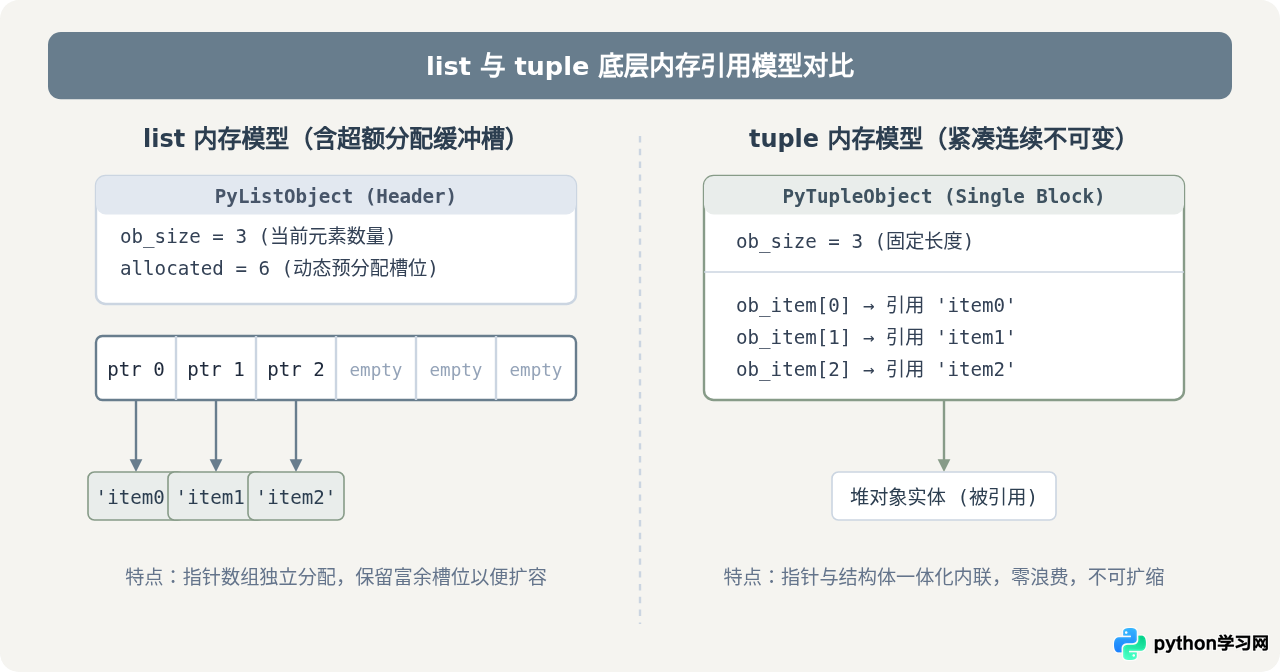
在 CPython 底层:
PyListObject包含一个头部(引用计数、类型、元素计数)以及一个指向指针数组的指针ob_item,另外还必须维护allocated字段记录当前的动态分配容量。因此,列表会预先超量申请空位以应对后续追加。PyTupleObject的元素数组直接内联紧随在元组结构体后方,没有额外的间接指针,也没有预留冗余空间。同等元素数量下,元组的内存开销明显小于列表。
避坑要点:元组的不可变性是指“引用的不可变”,而非“引用对象的不可变”。
如果元组中包含了一个列表(例如 t = (1, [2, 3])),元组对该列表的指针无法修改,但列表自身作为可变对象,其内部元素依然能够被修改(t[1].append(4))。此时该元组由于包含了不可哈希的列表,无法作为字典的键使用,否则将直接引发 TypeError: unhashable type: 'list'。
六、序列类型选型对比与决策指南
在工程实践中,根据数据特点与业务场景选择恰当的序列类型,能够直接提升程序的运行性能并降低 Bug 率。下表梳理了各序列类型的核心特征对照:
| 序列类型 | 可变性 | 元素存储方式 | 是否可哈希 | 典型适用场景 |
|---|---|---|---|---|
list |
可变 | 容器(任意对象指针) | 否 | 动态数据收集、频繁追加修改、排序筛选 |
tuple |
不可变 | 容器(任意对象指针) | 元素均可哈希时可 | 函数多返回值、轻量记录结构、字典只读复合键 |
str |
不可变 | 扁平(Unicode 字符) | 是 | 人类可读文本表现、文本解析、正则表达式处理 |
range |
不可变 | 扁平(生成整数序列) | 是 | 大跨度循环控制、数学等差步进计算 |
bytes |
不可变 | 扁平(8-bit 字节) | 是 | 网络传输包、文件流持久化、加密摘要 |
bytearray |
可变 | 扁平(8-bit 字节) | 否 | 大文件底层原地读写、网络数据协议解析缓冲池 |
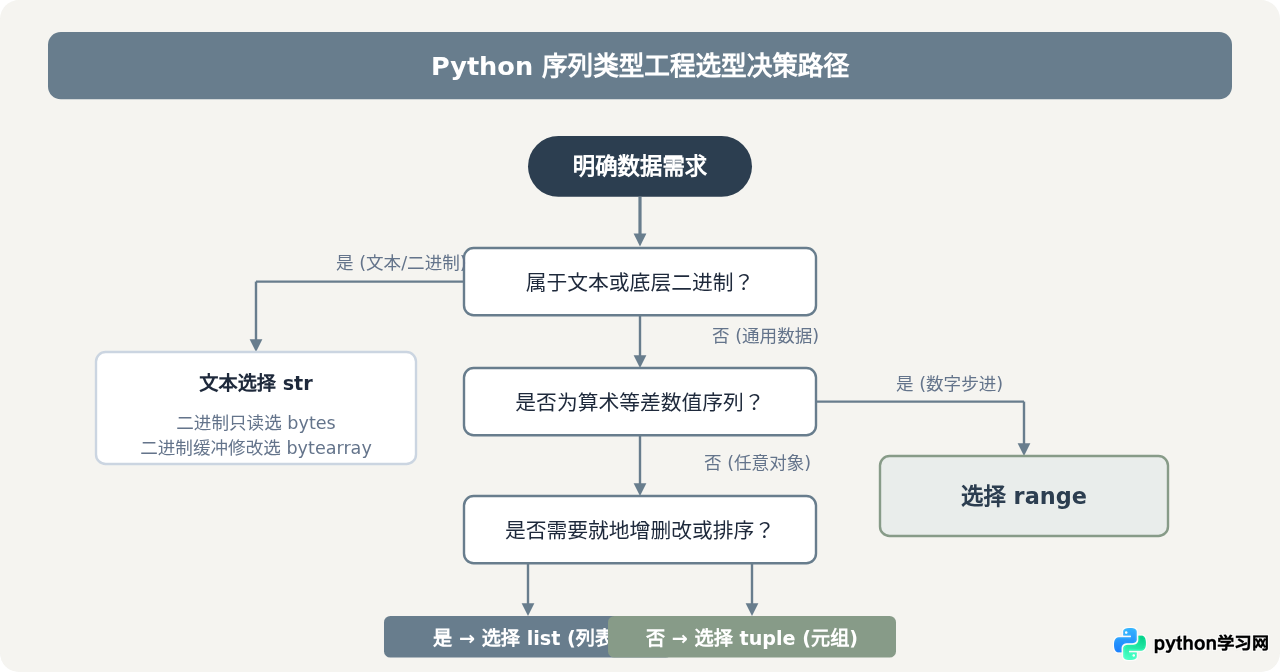
面对具体的数据存储需求时,可参考以下决策路径进行选择:
总结
掌握 Python 序列的关键在于厘清其分类边界与底层模型:
- 日常面对通用集合数据,若需要动态增删或原地重排,使用
list;若数据维度固定、追求轻量且希望防范意外篡改,使用tuple。 - 处理文本一律使用
str;处理大跨度数值循环使用几乎零内存损耗的range。 - 涉及到网络通信与底层文件字节流,使用只读且哈希安全的
bytes,或者选择支持高效原地修改缓冲区的bytearray。
借助 Python 统一的索引与切片协议,结合对各类序列内存开销与可变性的精准理解,便能在编写代码时做出兼具优雅性与高性能的架构决策。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















