


Python bytes与bytearray序列类型解析及适用场景
深入解析 Python 中 bytes 与 bytearray 两种二进制序列类型的内部构造、操作差异与性能表现,提供清晰的选型标准与实用工程场景指南。
在 Python 中处理二进制数据时,bytes 和 bytearray 是两个核心内置序列类型。它们各自代表无符号 8 位整数(取值范围 0 至 255)构成的序列,但设计目的和行为特征有着本质区别:bytes 是不可变的定长字节序列,提供安全的只读视图与可哈希保证;bytearray 是可变的高效字节数组,支持就地增删改与动态缓冲区扩容。理解两者的底层布局与操作开销,是编写高吞吐网络传输、文件编解码以及二进制协议解析程序的关键基石。
一、底层结构与内存模型解析
虽然 bytes 与 bytearray 在 Python 代码中均以字节为基本单元展现,但 CPython 底层对二者的内存组织方式存在显著不同。
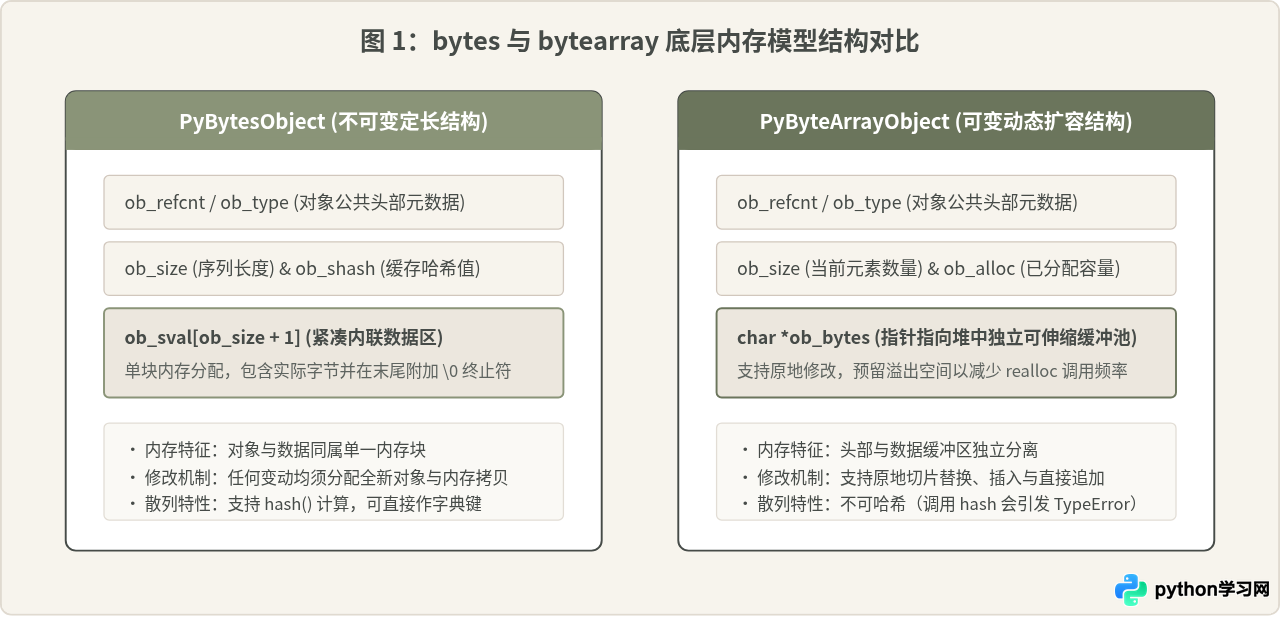
bytes 在 CPython 内部对应 PyBytesObject 结构体。它由对象头信息(引用计数、类型指针)、序列长度、预先计算并缓存的哈希值,以及紧随其后的固定长度字节数组 ob_sval 构成。整个对象在分配时一次性向堆申请连续内存空间,并在尾部保留一个空字符 \0 方便 C 语言兼容。由于它是完全不可变的,一旦创建,其尺寸和内存地址便永久固定,因此支持计算哈希值(Hashable),能够直接作为字典的键(dict key)或集合的成员(set element)。
bytearray 对应 PyByteArrayObject 结构体。它除了对象头和长度 ob_size 外,还维护了容量字段 ob_alloc 以及指向堆内存的独立字节指针 ob_bytes。这种分离结构类似于 Python 的 list:为了降低连续追加字节带来的重分配开销,底层会采用超额分配(Over-allocation)策略维护一段可伸缩的连续缓冲池。因为其内容可在原地修改,bytearray 是不可哈希的(Unhashable)。
二、创建方式与基础操作流转
在日常开发中,构建与转换这两个序列类型通常涉及字符串编解码、十六进制文本解析或数值序列灌入。以下是基础创建与常见形态:
# 1. 创建 bytes
b1 = b"Python"                  # 字节串字面量(仅限 ASCII 字符)
b2 = "你好".encode("utf-8")     # 字符串编码
b3 = bytes([0x48, 0x69])        # 传入 0~255 整数可迭代对象 -> b'Hi'
b4 = bytes.fromhex("e4 bd a0")   # 十六进制解析

# 2. 创建 bytearray
ba1 = bytearray(b"Python")
ba2 = bytearray("你好", "utf-8")
ba3 = bytearray([65, 66, 67])   # 对应 ASCII 的 A, B, C
ba4 = bytearray.fromhex("41 42 43")
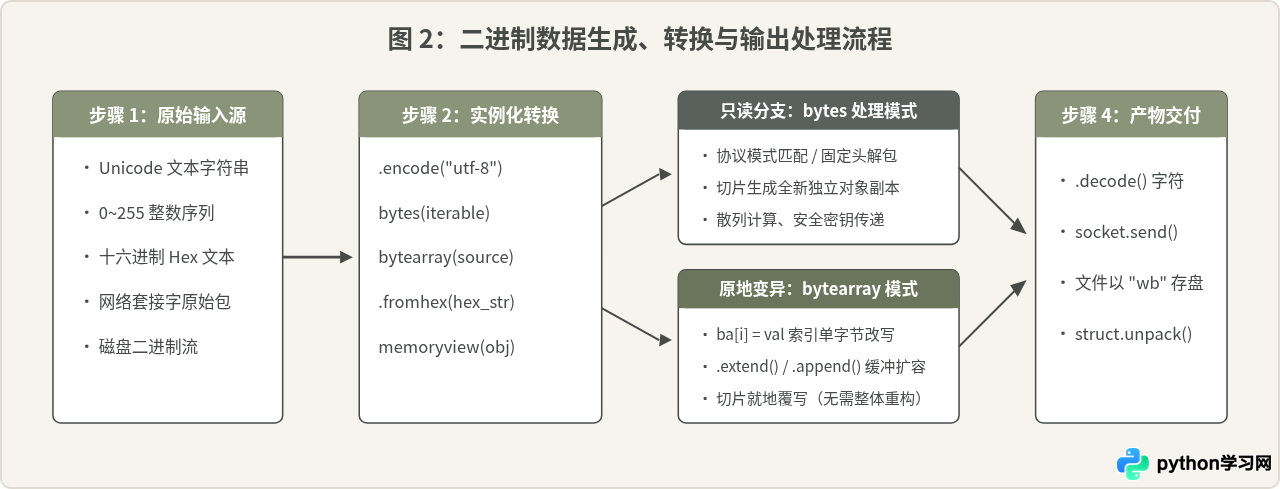
为了让数据在不同处理阶段平滑流动,开发者需要掌握两者的操作转换步骤。如图 2 所示,从原始数据输入到最终输出,序列类型的选择直接决定了处理管道的结构。
三、核心操作行为与变异差异
虽然两者共享大量类似于 str 的检索和切分接口(如 .find()、.split()、.replace()、.startswith()),但在索引访问与修改方面存在不可忽视的差异。
1. 索引单字节访问与切片行为
对 bytes 或 bytearray 进行单下标索引时,返回的并不是单字符字符串或单字节序列,而是该字节对应的 int 整数(0~255);但如果使用切片语法,返回的则是包含对应长度的同类型新序列。
data = b"ABC"
print(data[0])     # 得到整数 65,而不是 b'A'
print(data[0:1])   # 得到 bytes 对象 b'A'

# bytearray 同样如此
ba = bytearray(b"ABC")
print(ba[0])       # 得到整数 65
print(ba[0:1])     # 得到 bytearray 对象 bytearray(b'A')
2. 原地增删改功能(bytearray 专属)
bytearray 具备类似 Python 列表的修改方法。如果试图对 bytes 执行赋值,解释器将抛出 TypeError: 'bytes' object does not support item assignment。
buf = bytearray(b"hello world")

# 1. 单字节赋值(必须传入 0~255 整数)
buf[0] = 72         # 将首字母 'h'(104) 替换为 'H'(72) -> b'Hello world'

# 2. 切片替换(长度不必严格相等)
buf[6:11] = b"Python"  # 扩展为 b'Hello Python'

# 3. 类似列表的方法
buf.append(33)         # 追加感叹号 '!'
buf.extend(b" enjoy")  # 批量追加
buf.pop()              # 弹出尾部字节
四、常见误区与深度辨析
许多初学者或从纯文本处理转入二进制操作的开发者,容易对这两个类型的行为产生误解。以下对三个典型问题进行辨析:
辨析一:“只要处理二进制数据,无脑选 bytes 总是更安全?”
看似合理的理由:不可变对象在多线程读、函数传参时天生具备防御性拷贝优势,不易出现意外的跨模块污染,且能作为字典键或放入集合中。
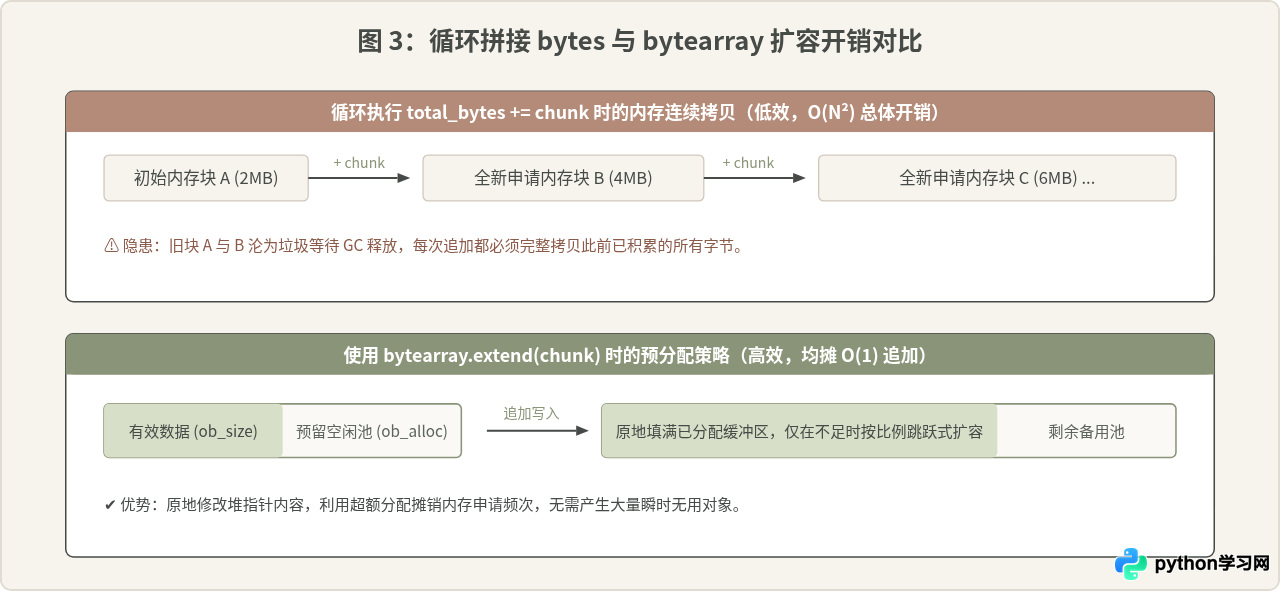
需要修正的地方:如果业务场景包含大量的动态片段拼接(例如循环分块接收网络数据包),每次使用 += 操作符拼接 bytes,都会导致 Python 申请一块全新的连续内存,将旧字节和新字节完整复制过去,随后废弃旧内存。当数据量上升到几十兆甚至几百兆时,这会产生灾难性的 $O(N^2)$ 内存拷贝与垃圾回收负担。此时应当采用预分配或动态追加的 bytearray。
辨析二:“bytes(10) 会生成包含数字 10 的单字节?”
看似合理的理由:在许多强类型语言中,向类型转换器传入整数往往代表将该数值转为对应的单字节。
需要修正的地方:在 Python 中,bytes(n) 或 bytearray(n) 传入单一正整数 $n$ 时,含义是创建一个长度为 $n$、初始内容全由空字节 \x00 填充的序列。例如 bytes(3) 输出 b'\x00\x00\x00',而非含有数值 3 的字节。
# 错误预期:
# b = bytes(10) -> 期待得到 ASCII 换行符 10 对应的字节

# 实际结果:
print(bytes(10))        # 得到 10 个空字节:b'\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00'

# 正确转换方式:
# 方法 1:传入整数列表
b_correct1 = bytes([10])          # b'\n'

# 方法 2:使用 int.to_bytes()
b_correct2 = (10).to_bytes(1, byteorder="big")  # b'\n'
辨析三:“bytearray 处处可变,性能必然全方位超越 bytes?”
看似合理的理由:可变意味着无需频繁重新分配,操作更灵活自由。
需要修正的地方:如果数据仅需在初始化后进行多次检索、模式匹配或安全传递,不可变的 bytes 更加轻量且更加安全。bytes 的内存模型更紧凑,没有多余的预分配空闲区开销;在单线程下可安全作为缓存键,在多线程环境下无需加锁即可自由共享读取。可变性本身带来的是灵活与就地写入效率,而不是无条件的整体性能优势。
五、适用场景与选型指南
在工程实践中,根据数据生命周期的读写特征进行选型,可以避免绝大多数性能瓶颈与类型错误。
| 对比维度 | bytes | bytearray |
|---|---|---|
| 核心可变性 | 完全不可变(Immutable) | 可变(Mutable,支持原地增删改) |
| 是否可哈希 | 是(支持作为字典键、放入集合) | 否(不可哈希,调用引发 TypeError) |
| 内存分布形态 | 头部与数据合一的紧凑单一内存块 | 对象头与可伸缩数据堆缓冲区两层结构 |
| 切片操作代价 | 复制指定区间并分配新 bytes 对象 | 切片赋值可原地覆写;切片读取仍复制新对象 |
| 高频追加效率 | 低(循环拼接 $O(N^2)$ 开销) | 高(预分配容量机制,均摊 $O(1)$) |
| 典型工程场景 | 配置常量、加密密钥、定长通信帧协议头、缓存键 | 网络分包接收缓冲、音视频帧原地滤镜、大文件切片拼装 |
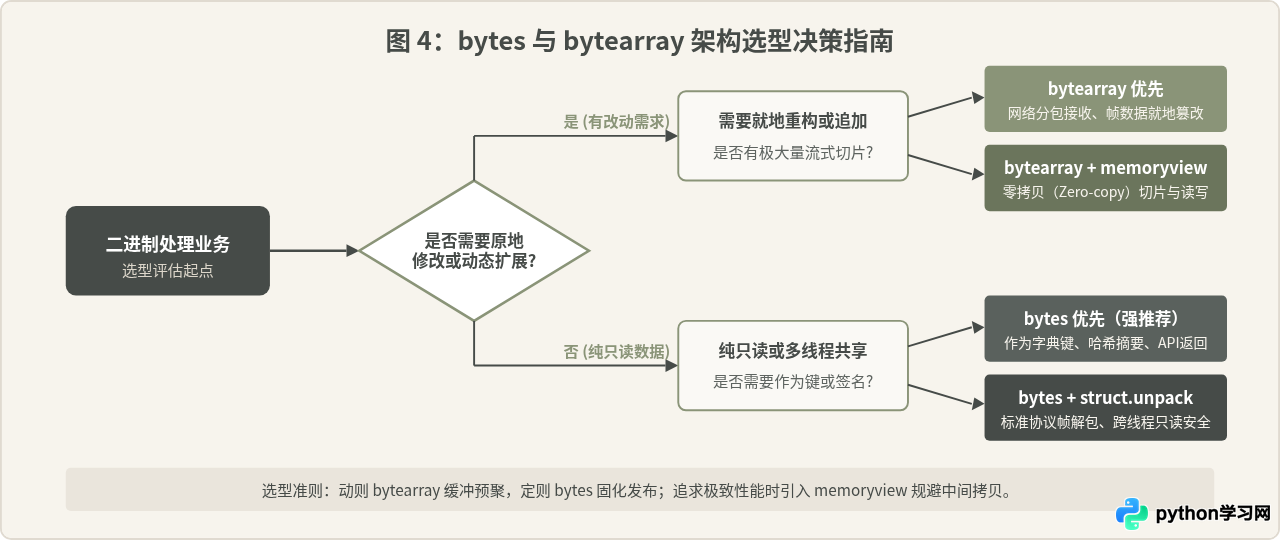
为了直观评估项目中的选型路径,图 4 提供了完整的技术选型决策树:
六、进阶技巧:配合 memoryview 消除切片复制
在性能敏感的大数据流处理中,即使使用了 bytearray,普通的切片操作(例如 chunk = buffer[1024:2048])依然会产生指定区间的全量内存拷贝。要消除这部分额外的 CPU 与内存开销,可以配合 memoryview(内存视图)技术实现零拷贝(Zero-copy)。
memoryview 能够包装 bytes 或 bytearray,在不复制底层物理内存的前提下,通过暴露 C 语言层级的缓冲区协议(Buffer Protocol)直接对指定切片进行寻址操作:
# 创建一块 10MB 的可变缓冲区
raw_data = bytearray(10 * 1024 * 1024)

# 包装为内存视图对象
view = memoryview(raw_data)

# 进行切片操作:此时完全没有发生内存数据复制,仅生成一个极轻量的视图指针
slice_view = view[1024:2048]

# 可以通过视图原地覆写底层 bytearray 的对应单元
slice_view[0] = 255

print(raw_data[1024]) # 输出 255,底层缓冲区已被就地修改工程注意点:当 bytearray 被 memoryview 引用时,该 bytearray 将被临时施加大小锁定(Buffer export lock)。在此期间不能对其调用改变总容量的方法(如 .append() 或 .extend()),否则会引发 BufferError: Existing exports of data: object cannot be re-sized。在视图处理完毕并释放(调用 view.release())后,容量操作限制才会解除。
七、总结
bytes 与 bytearray 并非简单的“谁替代谁”的关系,而是各有专精的协同设计:
bytes是只读事实的固化表达:适用于协议常量、解包只读报文、散列签名、多线程只读共享以及字典键索引,安全稳固且内存结构极为紧凑。bytearray是动态生产的施工平台:适用于套接字分包接收、流式报文解析重组、音视频矩阵数据原地更新与图像滤镜处理,大幅降低频繁内存申请的系统损耗。
在实际系统开发中,标准范式往往是:“在 bytearray 中完成高频收集、拼接与就地修饰,处理完成后调用 bytes(ba) 或直接对外输出”,兼顾处理阶段的高性能与交付阶段的稳固安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















