


Python中rb前缀与r前缀有什么区别

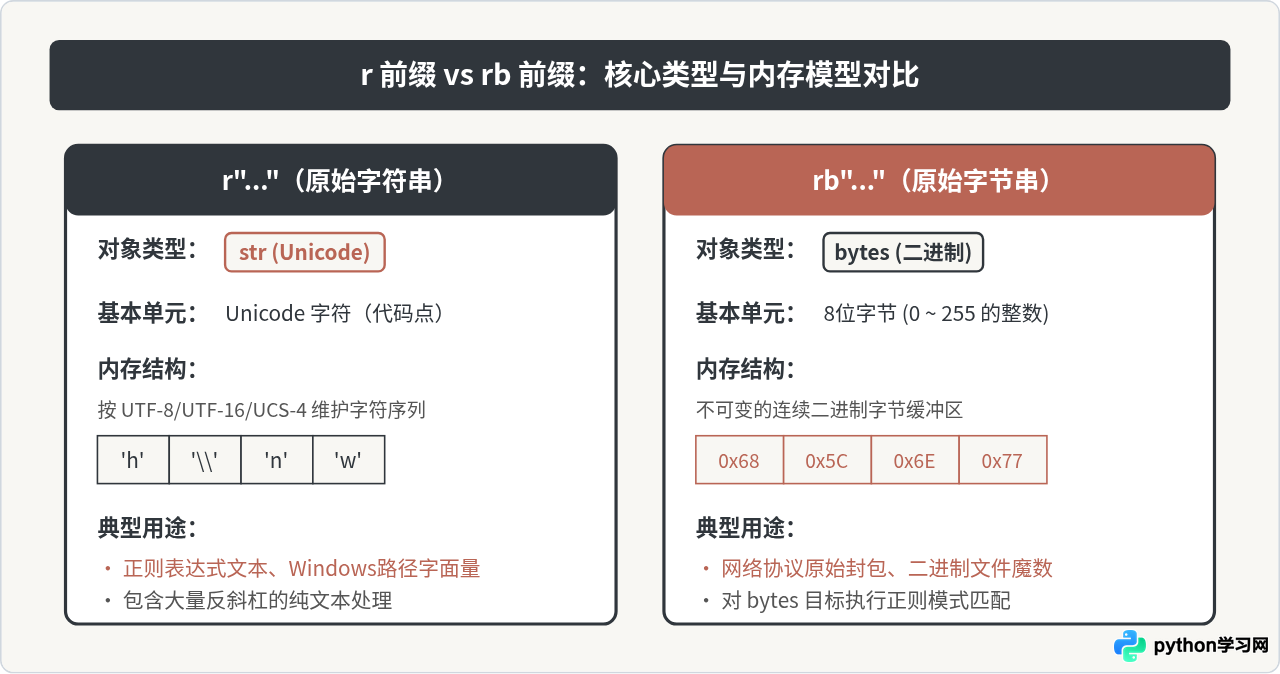
在 Python 中,r 前缀与 rb 前缀的核心区别在于它们构造的数据类型不同:r 前缀生成的是原始文本字符串(Unicode str),而 rb(或 br)前缀生成的则是原始二进制字节串(bytes)。两者的共同之处在于都启用了“原始字面量(Raw)”解析规则,即不对反斜杠(\)做转义解析;但两者的载体和内存语义完全不同,分别对应 Python 中两个相互独立的数据世界——文本与字节。
一、基础定义与本质区别
理解这两个前缀的关键在于拆解它们的字母构成。Python 字面量的前缀允许组合使用,其中:
r代表 Raw(原始):通知解释器按字面字符对待反斜杠,不把\n解释为换行,也不把\t解释为制表符。b代表 Bytes(字节):通知解释器将内容构造为bytes实例,每个单元是 0 到 255 的 8 位无符号整数,而非字符。rb是r与b的组合(书写为br效果完全一致):表示它既是bytes类型,又在语法层面禁用反斜杠转义。
通过简单的交互式终端代码,可以直接查看两者的类型差异与输出表现:
# 1. 使用 r 前缀
s_raw = r"hello\nworld"
print(type(s_raw))    # 输出: <class 'str'>
print(s_raw)          # 输出: hello\nworld(包含反斜杠与字母n,不换行)
print(len(s_raw))      # 输出: 12

# 2. 使用 rb 前缀
b_raw = rb"hello\nworld"
print(type(b_raw))    # 输出: <class 'bytes'>
print(b_raw)          # 输出: b'hello\\nworld'(字节流输出形式)
print(len(b_raw))      # 输出: 12(由12个ASCII字节组成)
尽管上面两个对象的长度都是 12,且都保留了 \ 和 n,但 s_raw 是由 Unicode 码点构成的字符容器,而 b_raw 是计算机底层的连续物理字节块。
二、反斜杠转义机制的运作过程
在默认情况下,无论是字符串字面量 "..." 还是字节串字面量 b"...",Python 的词法分析器都会扫描反斜杠 \ 并执行转义替换。例如,字符序列 \ 和 n 会被折叠成单一的 ASCII 换行符(数值为 10)。
当添加 r 前缀后,词法分析器会改变对反斜杠的处理策略:它不再将反斜杠视为转义起始符,而是直接将反斜杠作为独立的字符或字节保留在最终对象中。
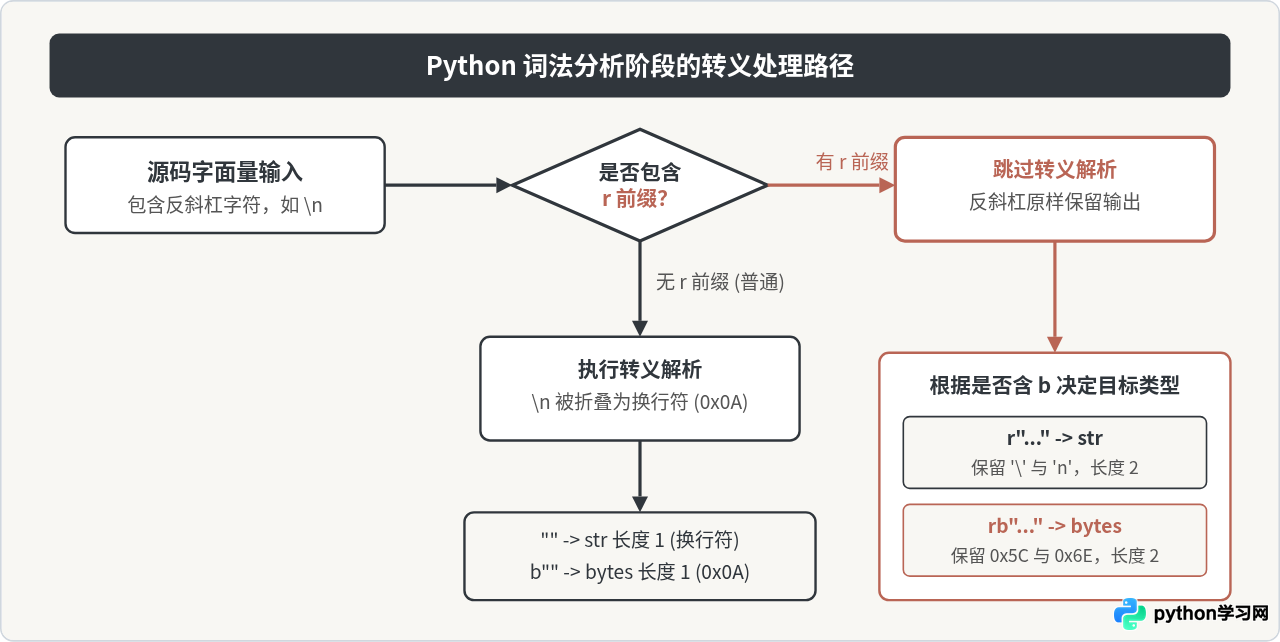
需要注意的是:Raw 前缀并不能完全消除反斜杠的所有语法限制。在 Python 规范中,即使是 r 或 rb 字面量,反斜杠依然具有“转义紧随其后的引号”的作用。这意味着:
- 原始字面量不能以奇数个反斜杠结尾。例如,
r"C:\test\"会直接报SyntaxError: unterminated string literal,因为末尾的反斜杠把结束的双引号转义了。 - 转义双引号后,反斜杠自身仍会保留在结果中。例如
r"\""的结果是长度为 2 的字符串\"。
三、实际应用场景对比
既然 r 与 rb 都具备不转义反斜杠的特性,那么在实际项目中何时选用哪一个?我们可以通过三个常见业务场景进行对照。
场景 1:正则表达式匹配(re 模块)
正则表达式内部大量使用反斜杠来表示元字符(如 \d、\s、\w)。如果不使用 r 前缀,开发者就必须在 Python 字符串层写两个反斜杠(\\d),在正则引擎层才能收到一个反斜杠。
- 当被匹配的目标对象是普通文本(str)时,必须使用
r前缀定义正则模式; - 当被匹配的目标对象是二进制数据(bytes)时,必须使用
rb前缀定义正则模式。
import re

# 目标 1:文本数据
text_data = "user_id: 1024, status: ok"
pattern_str = r"\d+"                    # 使用 r 前缀
match_str = re.search(pattern_str, text_data)
print(match_str.group())                # 匹配成功: '1024'

# 目标 2:字节流数据(如网络报文或二进制协议头)
raw_stream = b"GET /index.html HTTP/1.1\r\nContent-Length: 42\r\n"
pattern_bytes = rb"Content-Length:\s*(\d+)"  # 必须使用 rb 前缀
match_bytes = re.search(pattern_bytes, raw_stream)
print(match_bytes.group(1)) # 匹配成功: b'42're 模块对类型极其严格。如果使用 r 模式去搜索 bytes 数据,或者使用 rb 模式去搜索 str 数据,解释器会立即抛出 TypeError: cannot use a string pattern on a bytes-like object。
场景 2:Windows 文件路径处理
Windows 系统的目录分隔符是反斜杠(如 C:\Users\name\new_folder)。其中 \n 很容易触发换行转义导致路径损坏。此时开发者应该使用 r 前缀:
# 错误示例:\n 被转义为换行
wrong_path = "C:\Users\name\new_folder"

# 正确做法:使用 r 原始字符串表达文件路径
safe_path = r"C:\Users\name\new_folder"

with open(safe_path, "r", encoding="utf-8") as f:
    content = f.read()
这里绝不能使用 rb 前缀。因为文件路径在现代 Python 中是以字符串或 Path 对象传递给操作系统的;传入 bytes 虽然在某些底层系统调用被允许,但在混合路径拼接时极易引发类型不匹配问题。
场景 3:网络数据包与二进制文件解析
在编写网络协议测试、解析特定格式文件(如 ELF 文件、PNG 图片头、ZIP 压缩包头)时,经常需要直接构造或匹配包含特定 ASCII 字符的固定字节序列:
# 构造包含反斜杠控制字符的原始字节流
# 假设某设备协议规定终止指令为带有反斜杠与字母0的原始字节
device_cmd = rb"RESET\0\r\n"
print(list(device_cmd))
# 输出各字节的十进制值:[82, 69, 83, 69, 84, 92, 48, 92, 114, 92, 110]
# 可以看到每个反斜杠(92)和字符都被原封不动保留
四、选型决策指南
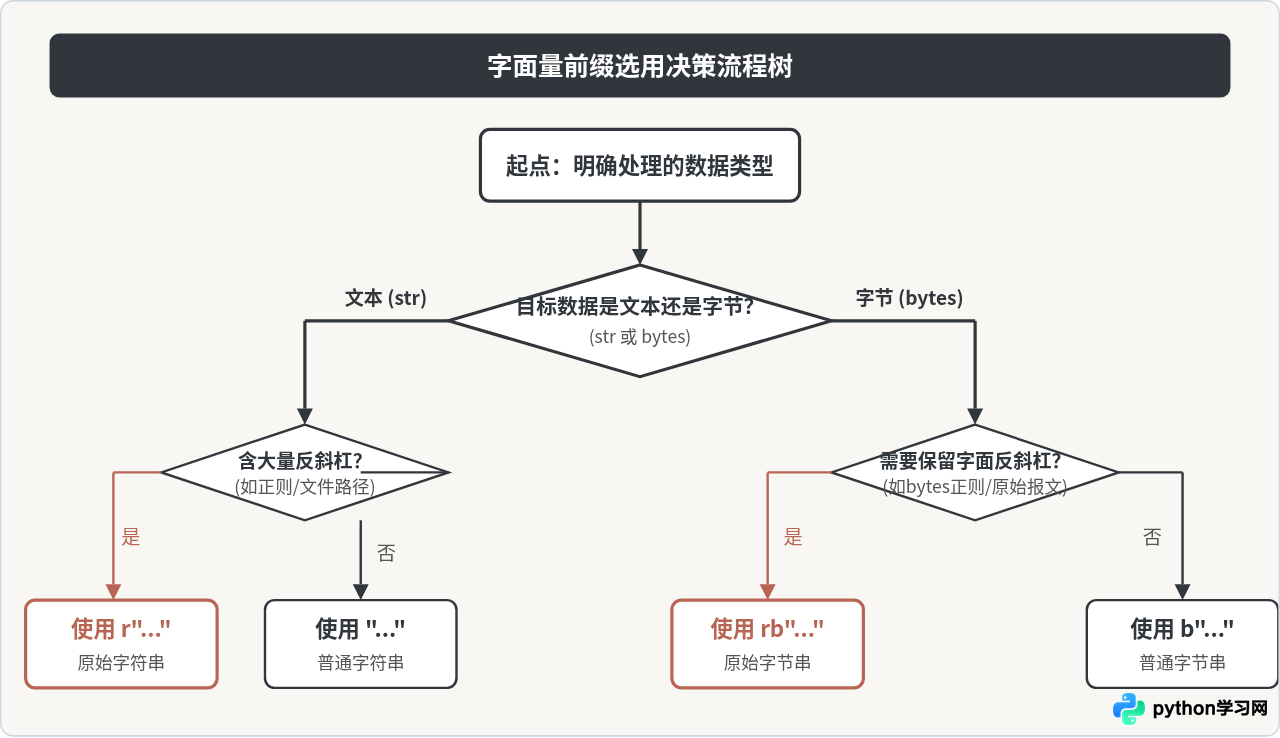
为了帮助读者在日常编码中快速、准确地选择正确的字面量语法,下方的决策流程图梳理了从业务需求到代码前缀的完整推导路径:
五、常见易混淆点与避坑速查
在学习和使用这两个前缀时,初学者经常会在以下几个地方出现认知偏差或编码失误:
1. 混淆“字面量前缀”与“open() 模式参数”
这是最常见的一种混淆。很多初学者误以为 open('file.txt', 'r') 中的 'r' 和字符串前缀 r"..." 是一回事。实际上:
r""是语法前缀,指示 Python 编译器如何构造该字符串对象;open(file, 'rb')中的'rb'是函数参数字符串,指示操作系统以二进制读取模式打开文件流。
在 open(r"C:\data\test.bin", "rb") 中,第一个参数使用了 r 语法前缀保护 Windows 路径反斜杠,第二个参数是普通的 "rb" 字符串告诉 open 函数读取原始字节。两者分属语言的不同维度。
2. 不能直接将 r 字符串与 rb 字节串拼接
由于 str 与 bytes 在 Python 3 中完全隔离,任何形式的隐式拼接或对比都会失败:
s = r"hello"
b = rb"world"

# 错误:TypeError: can only concatenate str (not "bytes") to str
result = s + b

# 正确:必须先编码为同一类型
result_bytes = s.encode("utf-8") + b
result_str = s + b.decode("utf-8")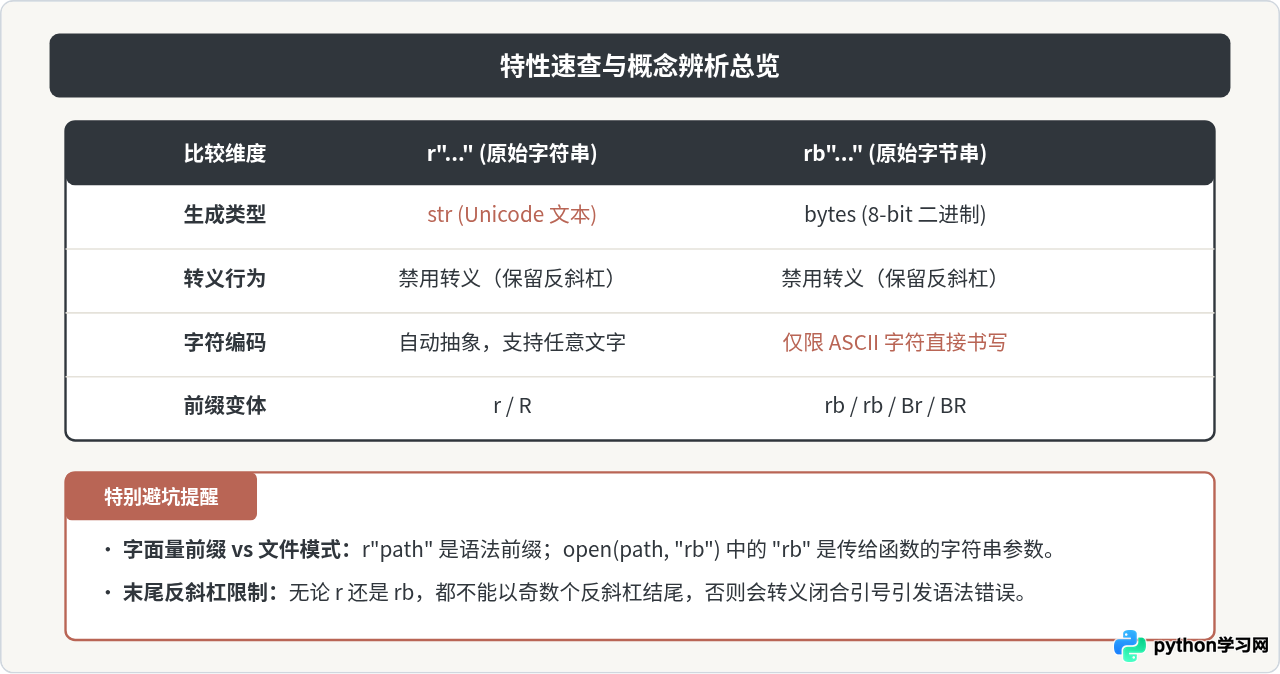
六、总结
归纳起来,r 前缀与 rb 前缀的核心异同可以概括为两句话:
- 相同点在于语法表现:它们都属于“原始(Raw)”字面量语法,使词法分析器跳过对反斜杠的常规转义,让反斜杠作为独立字符/字节输出。
- 根本点在于数据本质:
r产出的是处理文本逻辑的str对象,面向人可读的自然语言、路径与正则文本;而rb产出的是直接面向硬件与协议的底层bytes对象,面向二进制封包与字节流操作。
在编写代码时,只需首先确认目标受体期望接收的是文本字符串还是二进制字节序列,再决定是否搭配 r 或 rb 前缀,即可清晰、稳健地完成各类转义与二进制相关开发任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















