


Python原始字符串(r-string)与转义字符的正确表示方法

\ 是触发转义序列的特殊字符。使用原始字符串前缀 r 或 R 可以让反斜杠保持字面意义而不解释为换行或制表符,但它并没有改变 Python 词法分析器对引号匹配的基本规则。理解原始字符串在解释器底层的词法处理逻辑,明确反斜杠在不同上下文中的解析层级,是编写可靠文件路径和正则表达式的必备基础。
一、原始字符串的核心机制与本质误区
初学者接触 Python 时,通常会把普通字符串开头的 r 简单理解为“完全关闭转义功能”。这种直觉在绝大多数读取 Windows 目录或编写正则模式的场景下能够正常工作,但也容易让人形成一个致命的误解:误以为原始字符串内的所有字符都会像文本文件里的纯纯字符一样被 100% 原样接收。
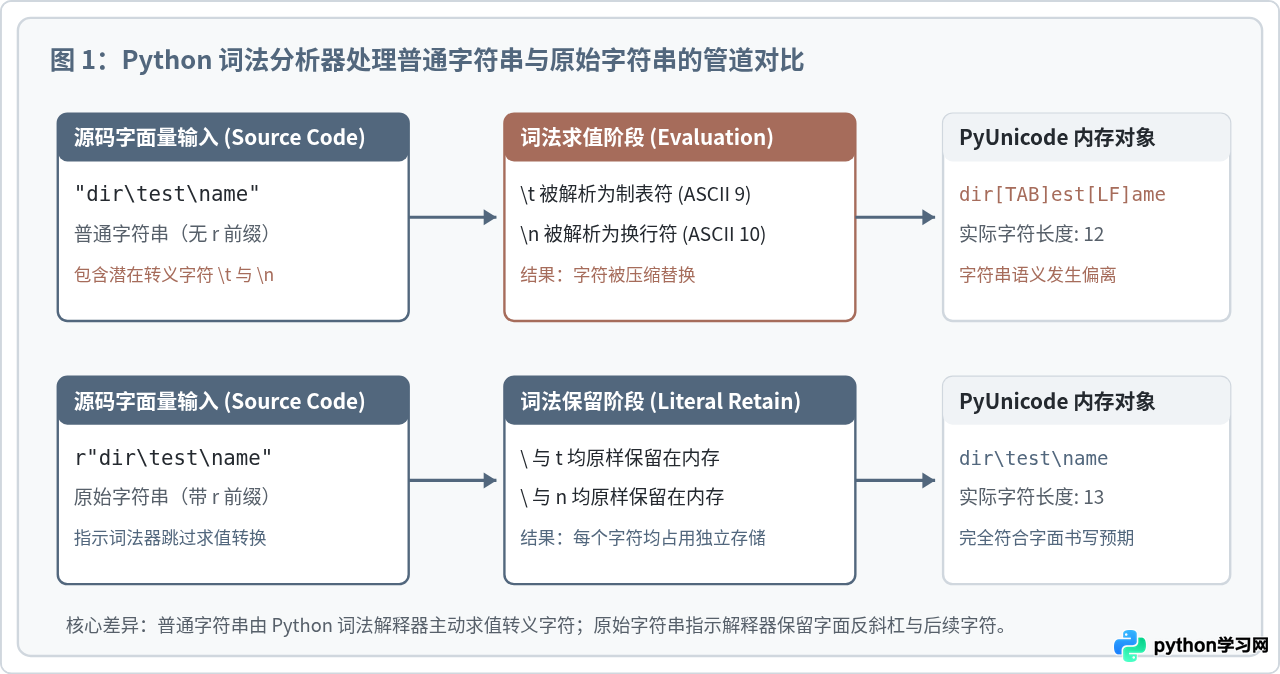
从 Python 官方词法规范来看,带有 r 或 R 前缀的字符串被称为“原始字符串字面量”(Raw String Literals)。它的真正作用是:抑制通用转义序列的求值。在普通字符串中,字符序列 \n 会被解释为一个 ASCII 值为 10 的换行符,\t 会被解释为制表符,而 \x41 会被求值为字母 A。而在原始字符串中,反斜杠与紧跟其后的字符均保留在字符串内存表示中,不会发生求值转换。
# 普通字符串:反斜杠参与转义计算
s_normal = "data\new_file.txt"
print(len(s_normal))
print(repr(s_normal))

# 原始字符串:反斜杠保留为独立字符
s_raw = r"data\new_file.txt"
print(len(s_raw))
print(repr(s_raw))17
'data\new_file.txt' (注:s_normal 中实际包含了换行符,其长度为17,因为 \n 被合并为单个字符)
18
'data\\new_file.txt' (注:s_raw 长度为18,内存中保留了独立的反斜杠)
我们可以通过下面的原理解析图清晰地看到 Python 词法分析器(Lexer)在构建字符串对象时,对普通字符串与原始字符串采取的不同处理路径。
二、末尾反斜杠语法错误与词法边界陷阱
既然原始字符串保留反斜杠,许多开发者在编写 Windows 路径时自然会写出如下代码:
# 试图表示以反斜杠结尾的 Windows 目录
path = r"C:\Windows\System32\"
然而,Python 解释器在读取这行代码时会直接中断,并抛出语法错误:
为什么带了 r 还会报错?要弄清楚这个原因,必须了解 Python 源码的分词规则:在词法扫描过程中,反斜杠依旧承担着转义下一个字符的职责。
当词法分析器遇到 r"..." 时,它必须确定字符串何时结束。当它扫描到字符 \ 时,无论是否为原始字符串,它都会无条件地将反斜杠和其紧随其后的字符打包读取。在上述代码中,末尾的反斜杠 \ 把结尾的双引号 " 转义成了“字面双引号”,导致该双引号丧失了“作为字符串闭合定界符”的功能。词法分析器认为字符串尚未关闭,继续向后扫描,直到换行或文件末尾也找不到闭合的双引号,从而报出未闭合字符串的错误。
Python 中任何字符串(包括单引号、双引号、三引号定义的原始字符串),都不能以奇数个反斜杠结尾。例如 r"\"" 虽然合法(其内容为反斜杠和引号两个字符),但该字符串必须由后续没有被转义的引号闭合。
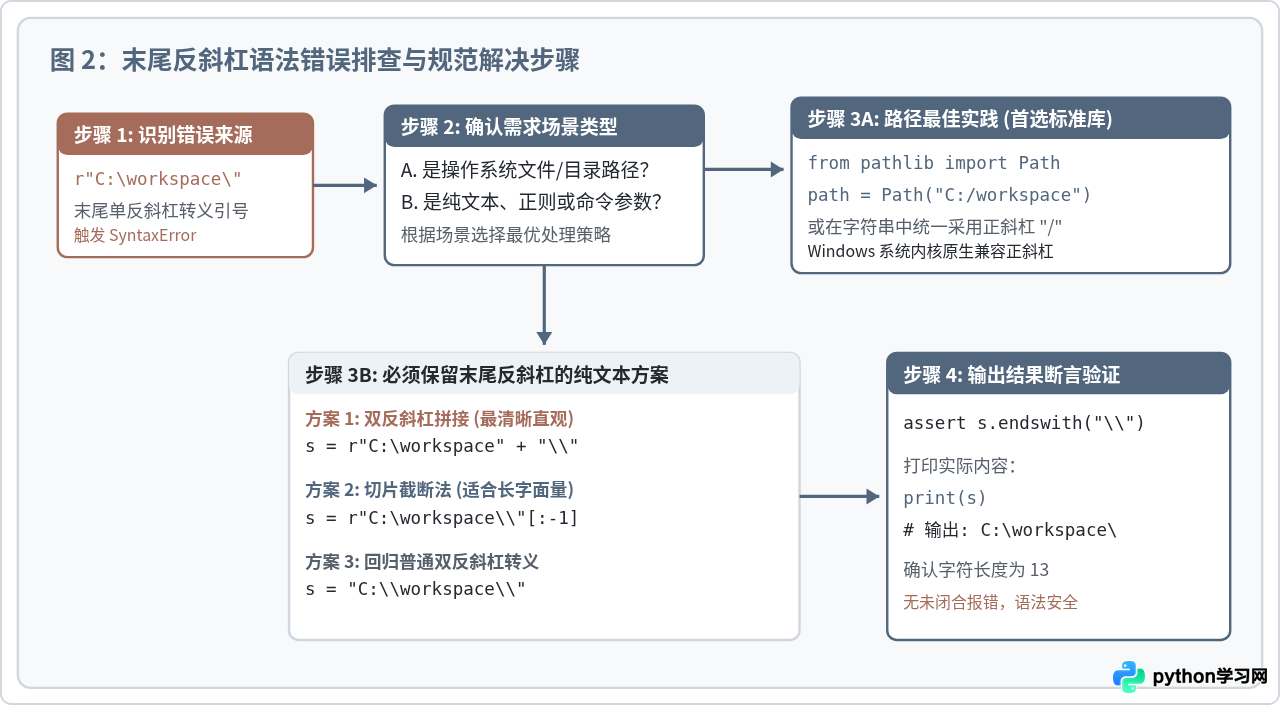
解决末尾反斜杠问题的正确操作步骤可以分为四种路径。下面的流程图展示了在不同业务场景下的推荐解决步骤与选型策略。
具体解决方案的代码实现
以下是解决末尾反斜杠问题的四种规范代码示例:
# 方法 1:字符串显式拼接(推荐用于简单字符串拼接场景)
path_concat = r"C:\Windows\System32" + "\\"

# 方法 2:偶数反斜杠切片法(输入两个反斜杠,保留一个)
path_sliced = r"C:\Windows\System32\\"[:-1]

# 方法 3:使用现代面向对象路径库 pathlib(推荐用于工程文件操作)
from pathlib import Path
path_obj = Path(r"C:\Windows\System32")
path_with_slash = str(path_obj) + "\\"

# 方法 4:统一使用正斜杠(Windows 系统级原生支持)
path_posix = "C:/Windows/System32/"
三、正则表达式中的“双重转义”与 r-string 的正确运用
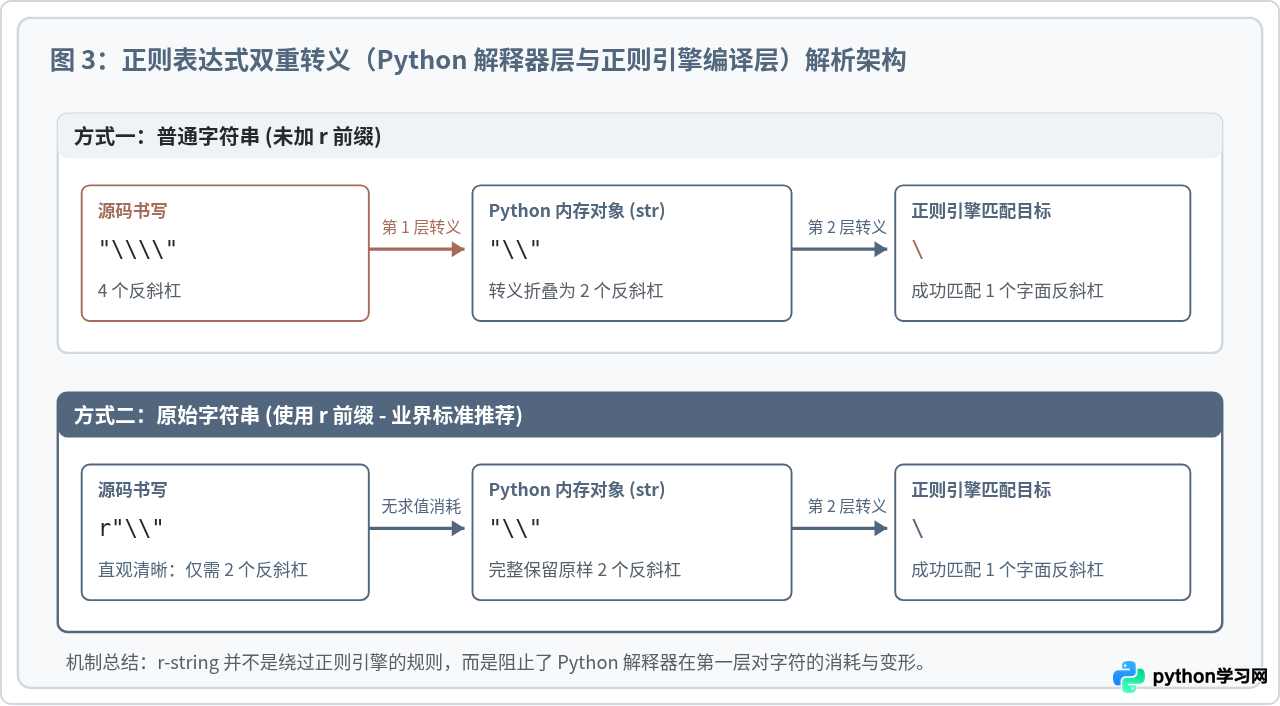
除了文件路径,正则表达式(Regex)是原始字符串最核心的用武之地。在处理正则时,开发者经常会遭遇“双重转义灾难”(Leaning Toothpick Syndrome)。这是因为从 Python 源码到最终正则模式生效,必须经历两次完全独立的转义解析过程:
- 第一层(Python 解释器层):词法分析器读取代码,把源码字面量解释为内存中的
str对象; - 第二层(re 正则编译引擎层):
re.compile()函数将内存中的str解释为正则表达式模式。
假设我们需要匹配文本中的一个字面量字符 .(句点)。在正则语法中,. 是一个代表任意字符的元字符,因此正则引擎必须接收到 \.。
如果不使用原始字符串,我们必须在第一层让 Python 生成一个反斜杠和一个点,而 Python 本身又要求反斜杠转义,所以必须书写 "\\."。更极端的情况是:如果我们要在文本中匹配一个字面量反斜杠 \:
- 正则引擎要求接收到
\\(两个反斜杠才能表示一个字面量反斜杠); - 为了让 Python 解释器在内存中构造出两个连续反斜杠,源码中每个反斜杠都要再写一次;
- 最终普通字符串必须写成整整四个反斜杠:
"\\\\"。
使用原始字符串 r"\\",直接切断了第一层 Python 解释器的转义消耗,使我们在源码中写出的字符能够 1:1 完整传递给第二层的正则引擎。
正则表达式实战对比代码
import re

text = "item_code: \\1024\\_v1"

# 需求:提取两个反斜杠之间的数字 1024
# 错误写法:没有使用 r 前缀,转义被 Python 吃掉导致正则报错或不匹配
# pattern_bad = "\\(\d+)\\"  # 语法混淆

# 正确做法 A:使用原始字符串 r-string(强烈推荐,可读性高)
pattern_r = r"\\(\d+)\\"
match_r = re.search(pattern_r, text)
if match_r:
    print(f"r-string 匹配成功: {match_r.group(1)}")

# 正确做法 B:使用普通字符串(必须写 4 个反斜杠)
pattern_normal = "\\\\(\\d+)\\\\"
match_normal = re.search(pattern_normal, text)
if match_normal:
print(f"普通字符串匹配成功: {match_normal.group(1)}")r-string 匹配成功: 1024
普通字符串匹配成功: 1024
四、常见场景中的转义处理与组合用法
1. 格式化原始字符串:fr-string 的使用规则
在 Python 3.6+ 中引入了 f-string,Python 允许前缀叠加使用。你可以将格式化字符串与原始字符串结合为 fr"..." 或 rf"..."。这在需要将动态变量插入到 Windows 路径或正则模板时极为实用。
filename = "report_2026.csv"
dir_name = "monthly_records"

# 结合使用:既支持 {变量} 插值,又阻止 \m 和 \r 被转义为回车制表符
full_path = fr"D:\{dir_name}\{filename}"
print(full_path)D:\monthly_records\report_2026.csv
2. 双引号与单引号的嵌套转义
在原始字符串中,如果你需要输入引号本身,依然可以通过反斜杠对引号进行标记,例如 r"He said: \"Hello\""。此时内存中的字符串会完整保留反斜杠与引号:He said: \"Hello\"。
如果你的业务目标是得到纯净的 He said: "Hello"(不希望反斜杠进入字符串内部),则不应使用反斜杠转义引号,而应采用 Python 提供的单双引号交替包含方式:
# 包含双引号且不产生反斜杠字符:外部使用单引号界定
clean_quote = r'He said: "Hello"'
print(clean_quote)
print(len(clean_quote))He said: "Hello"
16
五、Python 字符串表示与转义选型矩阵
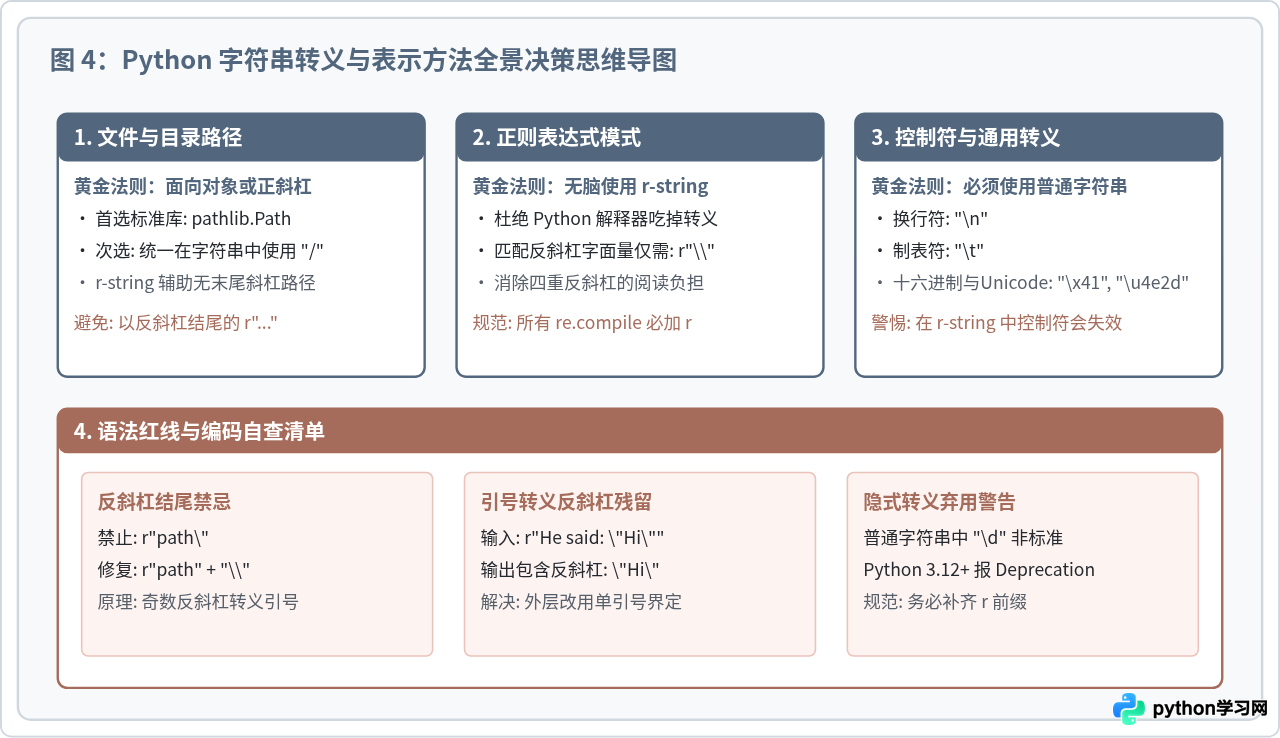
为了帮助读者在不同业务场景中做出最清晰、不易出错的选型判断,我们将常用方案与避坑准则梳理成如下决策体系:
| 应用场景 | 推荐方案 | 替代/次选方案 | 严格禁止的危险写法 |
|---|---|---|---|
| Windows 本地文件路径 | pathlib.Path("C:/dir") |
r"C:\dir\subdir" |
r"C:\dir\"(末尾斜杠语法错误) |
| 正则表达式匹配 (re) | r"\d+\.\d+" |
"\\d+\\.\\d+" |
"\d+\.\d+"(依赖过时的隐式转义) |
| 匹配单个反斜杠 | r"\\" |
"\\\\" |
r"\" 或 "\\"(无法通过语法校验) |
| 含引号的短文本 | 交替定界符 r'{"k": "v"}' |
三引号 r"""{"k": "v"}""" |
r"{\"k\": \"v\"}"(反斜杠会残留在字符串中) |
| 动态路径拼接 | Path(base) / name |
fr"{base}\{name}" |
使用加号随意拼接且不处理末尾斜杠 |
六、总结
Python 原始字符串(r-string)是解决转义字符书写繁琐问题的利器,但它并非超越 Python 语法解析规则的“纯原始通道”。其核心要义在于:
- 原始字符串在词法阶段仅抑制转义字符的求值转换,让反斜杠在内存中作为字面字符保留下来;
- 反斜杠依旧会转义紧跟其后的定界引号,因此原始字符串绝对不能以奇数个反斜杠结尾;
- 处理文件路径时,优先采用面向对象的
pathlib.Path或统一的正斜杠/; - 处理正则表达式时,始终坚持使用
r"..."以斩断 Python 解释器层对反斜杠的消耗,使代码兼具可读性与健壮性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















