


Python学习路线图:从基础语法到进阶开发的完整路径

学习Python的核心目标不是死记硬背语法规则,而是建立符合语言特性的心智模型,并逐步掌握编写健壮、可维护生产级代码的工程能力。许多学习者在掌握变量、循环和函数后,往往卡在“能写小脚本,但做不出完整项目”的瓶颈期。本文将整个成长路径系统拆解为四个衔接紧密的阶段:从语法基石、高级机制、工程规范到复杂系统实战,帮助你建立明确的进阶坐标。
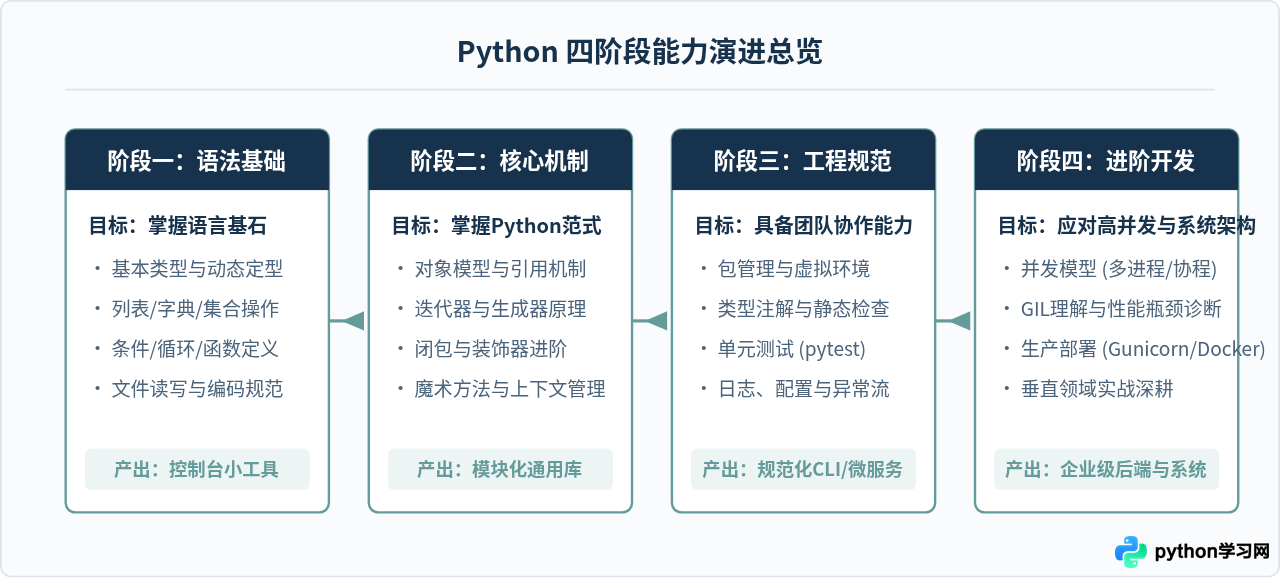
一、第一阶段:基础语法的关键突破点
很多初学者在基础阶段投入了几个月时间,把条件分支和基本数据类型看了好几遍,但在实际写逻辑时依然无从下手。基础语法阶段的核心在于掌握内置容器的使用边界,并养成结构化表达逻辑的习惯。
1. 容器选择与时间复杂度意识
Python内置的列表(list)、字典(dict)和集合(set)在底层实现上有根本区别。列表基于连续动态数组实现,按索引访问是 O(1),但在列表头部插入或使用 in 成员检查则是 O(n)。字典和集合基于哈希表实现,键查找与存在性检查平均时间复杂度为 O(1)。
当你的数据量达到上万级别时,在循环内部使用 if item in my_list: 会迅速导致程序卡顿;将其改为 my_set = set(my_list) 之后再检查,耗时会呈现数量级的下降。基础阶段就要建立起“依据操作频次选容器”的本能反应。
2. 编写健壮的基础代码习惯
在基础阶段务必掌握上下文管理器进行资源释放,避免文件句柄泄漏:
# 规范的文件读取示范
def read_configuration(file_path: str) -> dict:
    import json
    try:
        with open(file_path, "r", encoding="utf-8") as f:
            return json.load(f)
    except FileNotFoundError:
        return {}
    except json.JSONDecodeError as err:
raise ValueError(f"配置文件解析错误: {file_path}") from errencoding="utf-8"。在Windows操作系统上,open() 默认采用系统区域编码(如GBK),在读取UTF-8格式的源文件或数据时极易触发 UnicodeDecodeError。
二、第二阶段:进阶核心机制与Python特性的心智模型
从“语法书写”迈向“进阶开发”的真正分水岭,在于是否理解Python运行时的底层对象模型。如果带着C/C++或Java的指针/值传递旧经验看Python,会在变量赋值、默认参数和作用域上频繁遭遇隐蔽Bug。
1. 一切皆对象与变量绑定机制
在Python中,“变量名”不是承载数据的内存盒子,而是一张贴在对象上的“标签”(引用)。赋值语句 a = [1, 2] 的真实含义是:在堆内存中创建一个列表对象,并将名字 a 绑定(bind)到该对象。当执行 b = a 时,并没有发生数据复制,而是名字 b 也指向同一个内存对象。
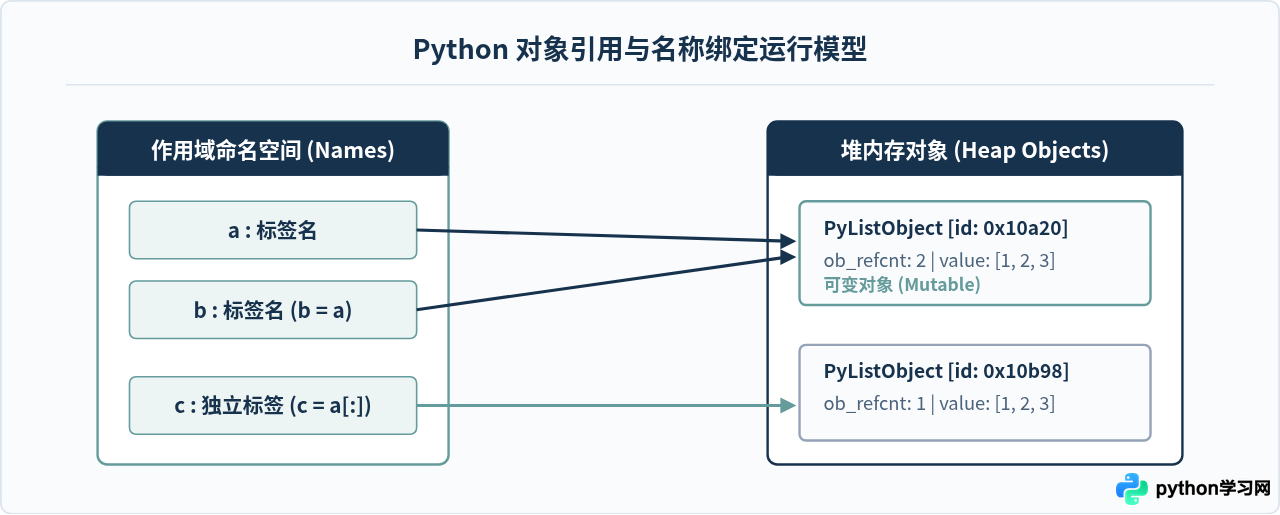
这种机制最经典的陷阱是默认可变参数。函数定义在模块被加载时执行一次,其默认参数对象只会被初始化一次:
# 错误示范:所有调用共享同一个列表对象
def append_item(val, target=[]):
    target.append(val)
    return target

# 正确做法:使用 None 作为占位符并在运行时初始化
def append_item(val, target=None):
    if target is None:
        target = []
    target.append(val)
    return target
2. 迭代器、生成器与内存友好型流处理
当你需要处理几十万行日志或大型CSV文件时,若直接使用 lines = f.readlines(),系统会将整个文件加载到内存中,极易触发系统的OOM(Out Of Memory)。
掌握 yield 关键字与生成器表达式,是编写生产代码的必备技能。生成器实现了惰性求值(Lazy Evaluation),每次迭代只在调用 next() 时计算并返回一个元素,使内存占用始终保持在常数级别 O(1)。
3. 装饰器的本质与面向切面编程
装饰器是高阶函数的典型应用,其本质是接收一个函数作为输入,并返回包装后的新函数。在进阶开发中,装饰器被广泛应用于请求重试、权限校验、性能耗时打点与缓存(如 functools.lru_cache)。编写装饰器时,切记使用 @functools.wraps(func) 保护原函数的元信息(如 __name__ 和 __doc__)。
三、第三阶段:工程化规范与工业级项目骨架
在个人学习阶段,单个 .py 脚本足以运行。但在团队协作和生产交付中,代码必须满足可测试、可维护和易配置的要求。第三阶段的核心是掌握标准的Python工程架构。
1. 现代化项目结构布局(src layout)
推荐采用 src/ 目录隔离源码。这种布局能够防止在开发环境中因当前工作目录直接暴露,导致本地未安装的包被意外静默导入,掩盖实际打包时的缺失依赖。
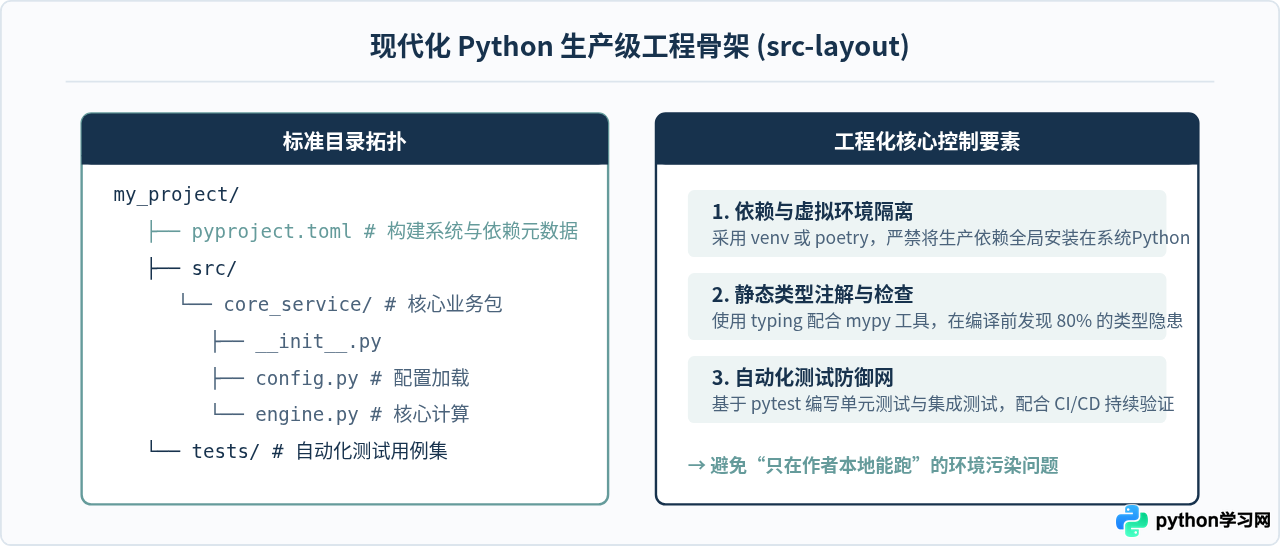
2. 类型注解(Type Hints)与静态检查
动态语言在项目规模扩大后容易产生维护恶梦。从Python 3.5引入并在现代版本中广泛普及的类型注解,能极大提升大型项目的可读性和重构安全性:
from typing import Optional, List
from dataclasses import dataclass

@dataclass
class UserSession:
    user_id: int
    token: str
    roles: List[str]
    expires_at: Optional[float] = None

def validate_access(session: UserSession, required_role: str) -> bool:
    if required_role not in session.roles:
        return False
    return True
四、第四阶段:进阶开发实战与系统性能进阶
当项目需要处理高吞吐网络请求或大规模并行计算时,你就必须直面Python的并发模型与底层运行时限制。
1. 全局解释器锁(GIL)与并发模型选型
CPython解释器包含全局解释器锁(Global Interpreter Lock,简称GIL),它确保在任何时刻只有一个原生线程在执行Python字节码。这意味着:
- CPU密集型任务(如图像处理、矩阵计算、加解密):多线程无法利用多核CPU,此时必须使用
multiprocessing模块启动独立进程,或调用C/Rust扩展绕过GIL。 - I/O密集型任务(如API请求、网络爬虫、微服务间调用):线程或协程在等待网络/磁盘IO时会主动释放GIL。推荐使用基于单线程事件循环的
asyncio方案,以极低的内存开销支撑数千并发连接。
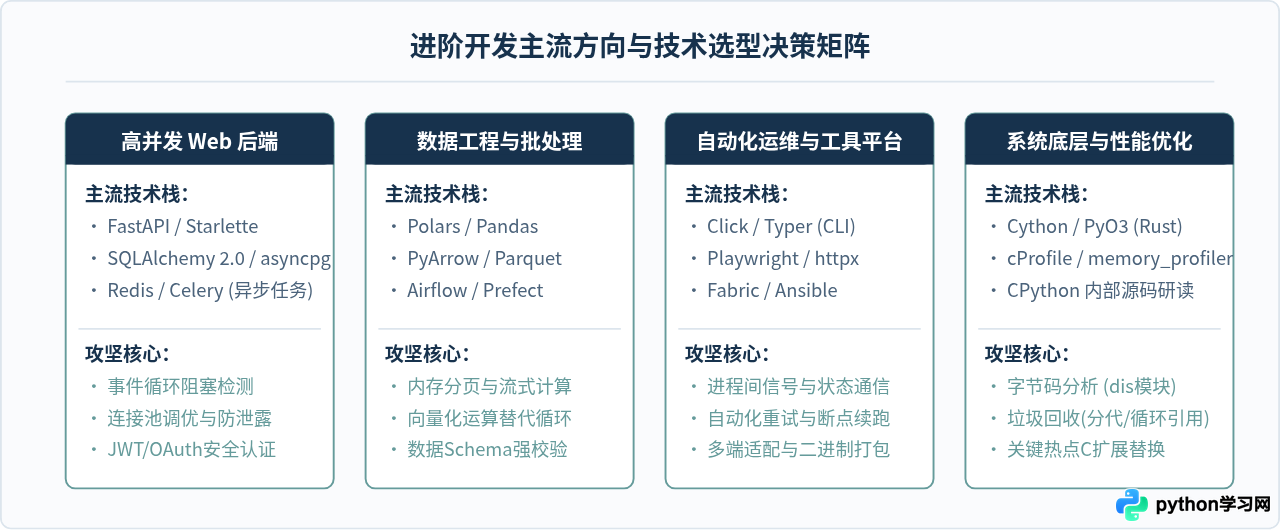
2. 异步协程典型范式
编写 asyncio 应用程序时,最严重的失误是在异步协程中调用了传统的同步阻塞函数(例如 time.sleep() 或未异步化的 requests.get())。这会导致整个线程的事件循环被完全卡死,所有并发协程同时停滞:
import asyncio
import httpx

async def fetch_endpoint_status(url: str) -> dict:
    # 使用原生支持异步的 HTTP 客户端
    async with httpx.AsyncClient(timeout=5.0) as client:
        response = await client.get(url)
        return {"url": url, "status_code": response.status_code}

async def check_all_services(urls: list[str]) -> list[dict]:
    # 并发触发多个请求,等待全部完成
    tasks = [fetch_endpoint_status(u) for u in urls]
    return await asyncio.gather(*tasks)
五、总结:从学习到交付的演进闭环
完成从初学者到进阶开发者的转变,关键不在于读了多少本书,而在于每一次写代码时是否有意识地以工程标准要求自己:
- 拒绝写单文件脚本:用模块包和清晰的职责划分组织代码,将业务逻辑与命令行入口解耦。
- 警惕引用陷阱与内存开销:时刻清楚当前处理的数据是值还是对象引用,在海量数据处理中优先采用流式迭代与生成器。
- 防御性编程与类型系统:善用静态类型检查与单元测试防御回归缺陷,让错误尽可能在运行前暴露。
- 依据负载特征精准选型:分清CPU密集与IO密集场景,合理运用多进程、异步IO与成熟第三方组件,构建稳定可靠的应用服务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















