


Python零基础学习路线:先学语法还是直接做项目?
针对Python零基础学习者经常困惑的“先学语法还是直接做项目”问题,详细解析纯语法与纯项目路线的痛点,提出最小必要语法(MVS)加微任务驱动的渐进式闭环学习路线,提供具体阶段规划与实操步骤。
一、核心矛盾:为什么两种极端路线都会半途而废?
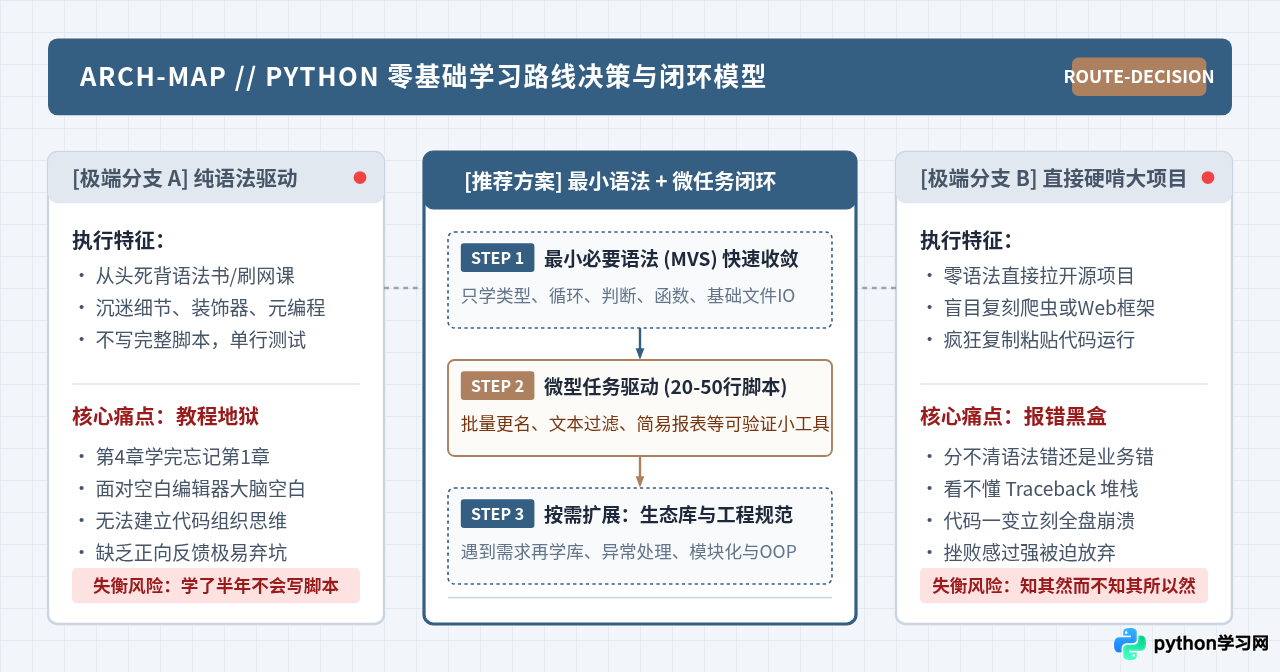
初学者在开启编程学习时,往往容易走向两个截然不同的极端:一派主张“打牢基础,把厚厚的语法书读透再动手”;另一派则主张“项目驱动,从第一天起就照着开源项目抄代码”。然而从认知规律和编程学习的实际结果来看,这两条路线的放弃率都居高不下。
1. 纯语法路线的陷阱:教程地狱与认知断裂
纯语法路线的最大问题在于正向反馈匮乏与抽象脱节。Python 的基础语法并不算少,如果目标是“全部掌握”,初学者就需要逐一学习变量、数据类型、列表字典、条件循环、函数定义、高阶函数、闭包、类与对象、多重继承、魔术方法、元类、迭代器与生成器、异常体系、多线程并发等。
在没有实际工程场景的支撑下,这种学习本质上是在死记硬背抽象规则。当学到第 8 章面向对象时,第 2 章字符串切片的细节早已遗忘。更为致命的是,即便在交互式命令行中能正确计算 1 + 1,一旦面对空白的代码编辑器,读者依然无法将一个具体的现实需求(例如“把桌面上的全部表格合并为一个文件”)拆解为代码结构。这种现象在技术教育中被称为“教程地狱(Tutorial Hell)”。
2. 直接硬啃大项目的阻碍:报错黑盒与认知过载
另一派倡导“纯项目驱动”的方案往往选择爬虫、Web 框架(如 Django)或自动化办公作为起点。对于完全零基础的读者而言,这类项目包含大量隐含的前提知识:HTTP 协议、HTML DOM 树、异步机制、包依赖管理、文件系统路径等。
当读者连 list 与 dict 的索引取值差异、None 的含义或缩进规则都未建立直觉时,直接运行成百上千行的工程代码,其结果只能是机械地复制与粘贴。代码一旦出现一个最简单的拼写错误,控制台就会抛出长达数十行的调用栈报错(Traceback)。读者由于无法分辨这是语法错误(SyntaxError)、类型错误(TypeError)还是网络连通性问题,便陷入完全无法独立排查的“报错黑盒”,最终在挫败感中放弃。
二、破局解法:最小必要语法(MVS)的收敛标准
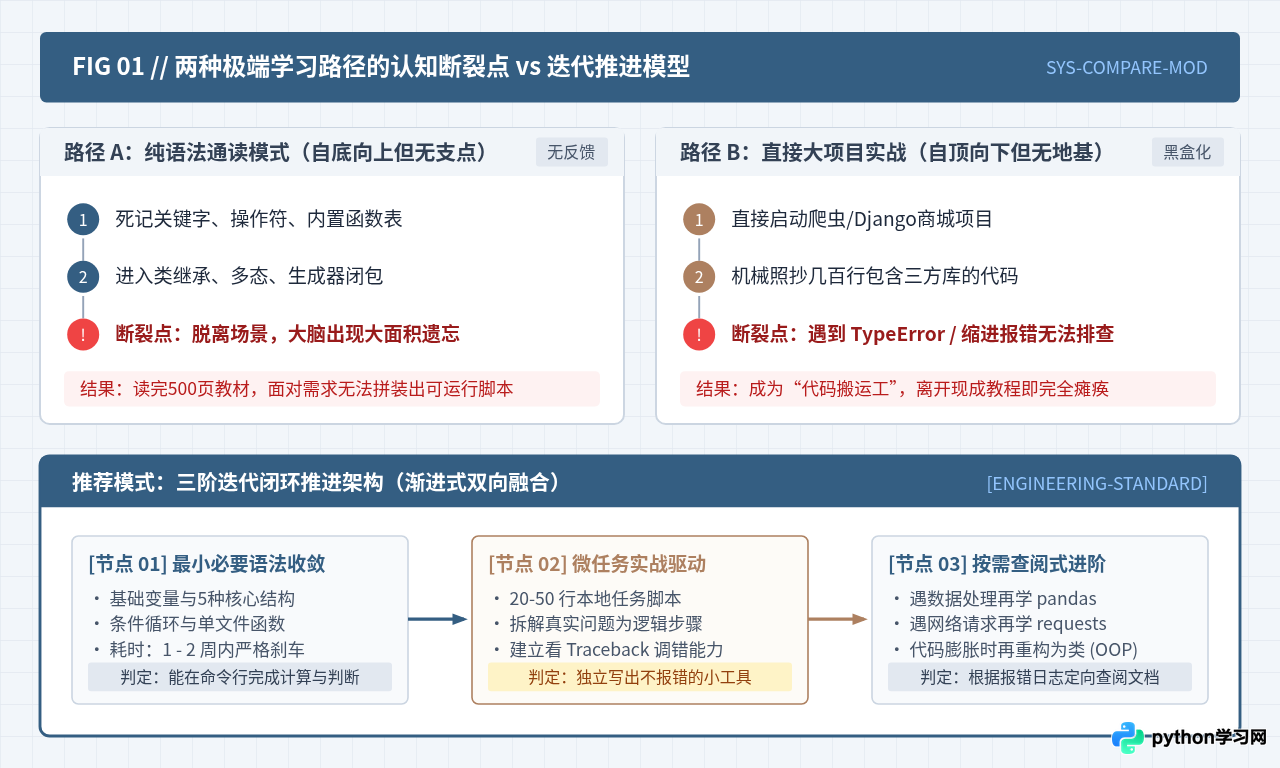
要打破上述困境,关键在于确立“最小必要语法”(Minimum Viable Syntax, 简称 MVS)。所谓最小必要语法,是指支撑你写出一个 20 至 50 行、具备实际输入输出功能的脚本所必须具备的最简语法子集。在这个子集之外的所有进阶特性,在初学阶段一律主动排除。
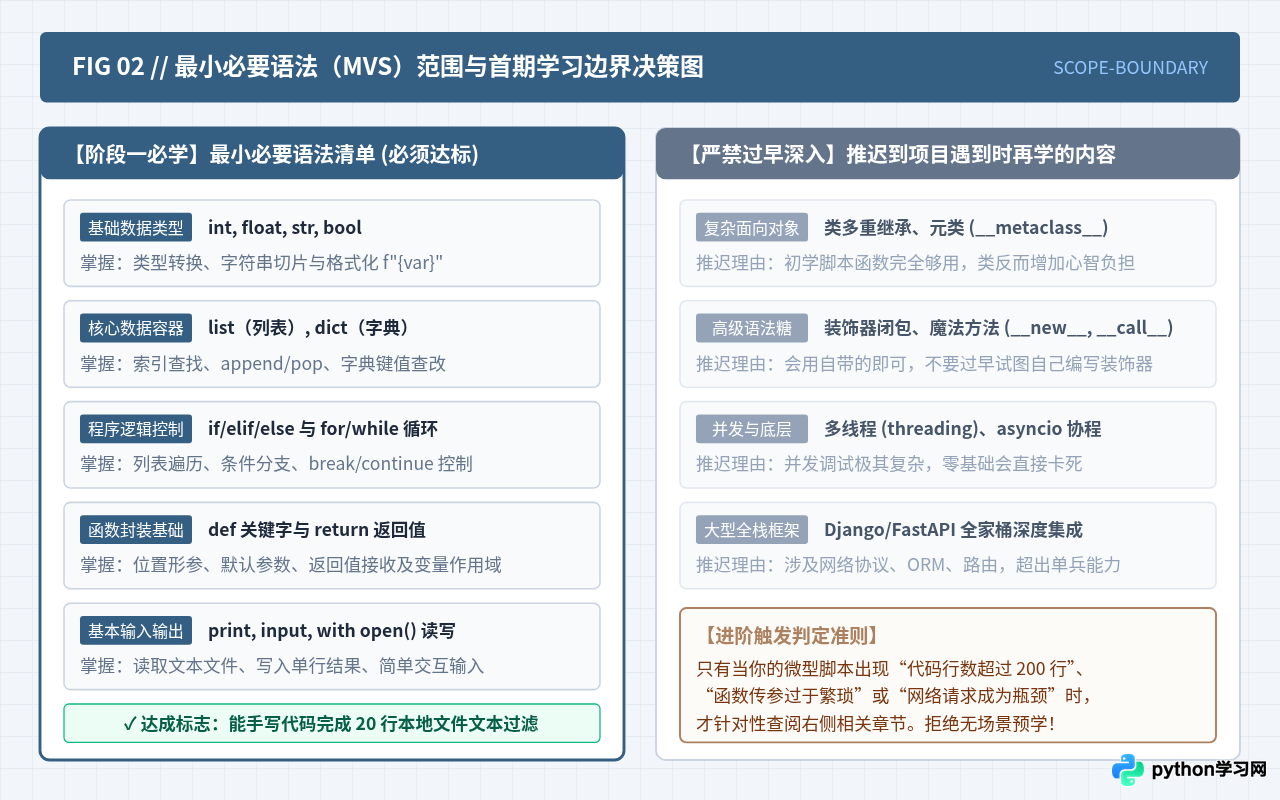
| 知识维度 | 阶段一必须收敛的核心掌握点 (MVS) | 严禁在初学阶段死磕的内容(推迟到项目中) |
|---|---|---|
| 数据类型 | int, float, str, bool 基础运算;str.strip(), str.split(), str.replace() 基础文本处理;f-string 格式化字符串。 | 复杂正则表达式高级回溯、字节序列 (bytes/bytearray) 底层编码转换、自定义元类。 |
| 数据容器 | list 的索引、切片、append()、len();dict 的键值配对、dict.get()、in 成员判断。 | collections 模块全部高级容器(OrderedDict, ChainMap)、多重嵌套列表推导式、生成器表达式底层原理。 |
| 控制流 | if / elif / else 分支判断;for item in iterable 遍历;while 循环与 break / continue 基础控制。 | for...else 语法糖、上下文管理器协议内部 __enter__ / __exit__ 手动实现。 |
| 函数与封装 | def 定义函数;参数传递;return 显式返回值;全局变量与局部变量的基本作用域概念。 | 带参数的函数装饰器、闭包作用域深潜 (nonlocal)、递归算法优化、匿名函数 lambda 的过度炫技。 |
| 系统与文件 IO | with open("file.txt", "r", encoding="utf-8") 安全读取与写入纯文本;内置 print() 与 input()。 |
底层 socket 网络编程、mmap 内存映射、异步文件 IO、复杂多线程并发锁竞争。 |
三、实操步骤:从自然语言需求到可运行脚本的推导全过程
掌握了最小必要语法后,许多初学者依然会经历“看懂了语法,但不知道第一行代码怎么敲”的卡顿。这是因为现实需求是以“业务目的”表达的,而计算机只接受“指令序列”。要完成这个过渡,需要一套标准化的推导步骤。
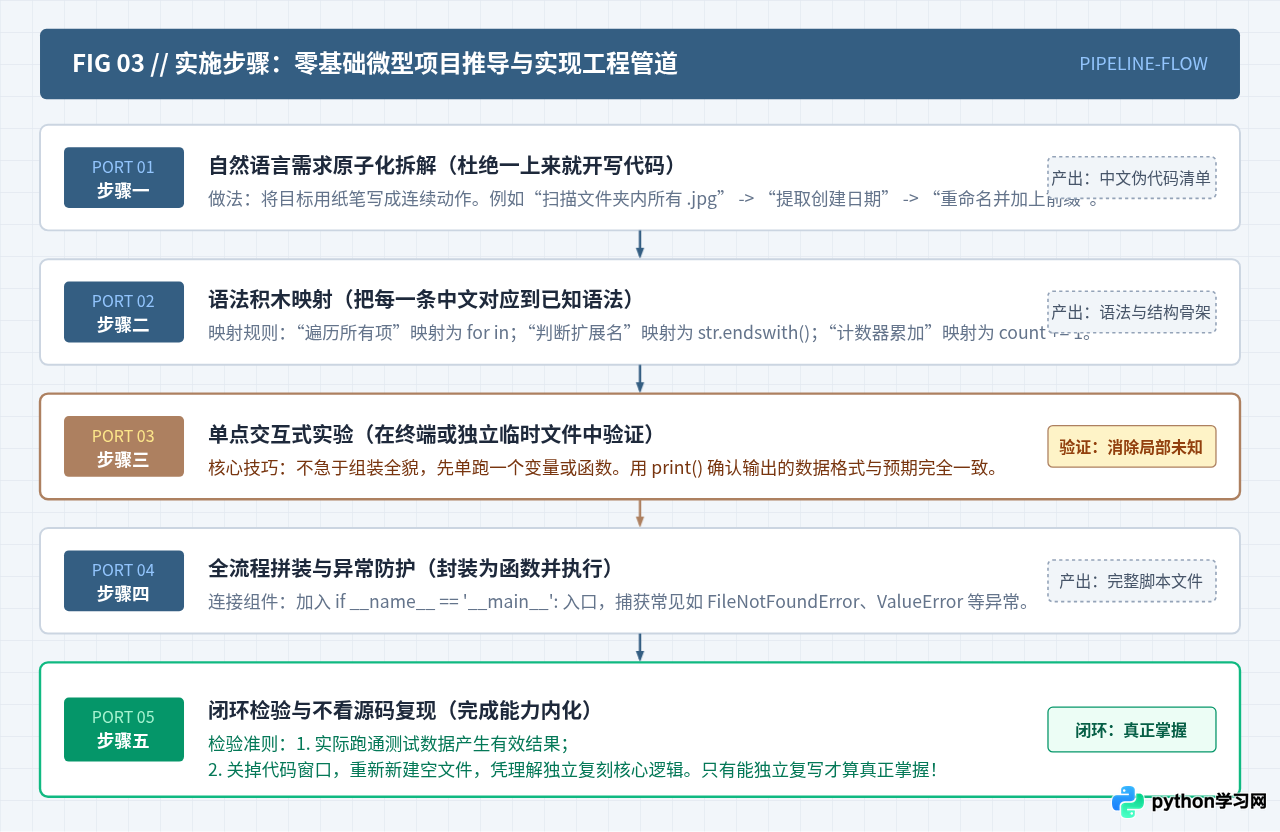
步骤一:需求原子化拆解(编写中文逻辑清单)
以一个典型的实际办公微任务为例:“从一个包含 1000 行服务器访问日志的文本文件中,筛选出所有状态码为 500 的报错行,并提取出对应的请求路径与发生时间,最后存入新文件。”
绝对不要直接在编辑器里写代码,先用纯中文写下执行动作:
- 打开原始日志文件
server.log,逐行读取内容; - 检查当前这一行中是否包含关键词
" 500 "; - 如果不包含,直接跳过当前行;
- 如果包含,使用空格将这行文本拆开,提取第 1 项(时间)和第 5 项(路径);
- 将提取出的信息格式化后,追加写入到结果文件
errors.txt中; - 处理完毕后在终端打印统计总数。
步骤二:将业务动作映射到 MVS 语法积木
将上述中文动作逐条对应到已经学过的 Python 语法:
- “逐行读取文件” →
with open(...)搭配for line in file循环; - “检查是否包含” → 成员运算符
if " 500 " in line:; - “拆开文本” → 字符串方法
parts = line.split(" "); - “提取特定项” → 列表索引访问
parts[0],parts[4]; - “追加写入结果” →
with open(..., "a", encoding="utf-8")。
步骤三:在独立临时脚本中完成单点验证
初学者容易犯的错误是一次性把全部逻辑写完再运行。正确的做法是“小步前进,单点验证”。例如,先单独写两行代码测试文本拆分是否符合预期:
# 拿一行模拟的日志文本测试 split() 的拆分结果
sample_line = "2026-11-02 08:30:15 GET /api/v1/user 500 128ms"
parts = sample_line.split(" ")

print(f"拆分后总项数: {len(parts)}")
print(f"时间字段: {parts[0]} {parts[1]}")
print(f"请求路径: {parts[3]}")
print(f"状态码: {parts[4]}")拆分后总项数: 6 时间字段: 2026-11-02 08:30:15 请求路径: /api/v1/user 状态码: 500
步骤四:拼装完整可运行脚本并加入防御逻辑
单点逻辑验证无误后,将其组合为结构清晰的独立脚本。在此处引入基础函数封装与文件容错:
import os

def filter_server_errors(source_file: str, output_file: str) -> int:
    """
    读取源日志文件,提取包含 500 报错的请求路径与时间,存入目标文件。
    返回匹配到的错误日志条数。
    """
    if not os.path.exists(source_file):
        print(f"【错误】源文件不存在: {source_file}")
        return 0

    error_count = 0
    with open(source_file, "r", encoding="utf-8") as src,          open(output_file, "w", encoding="utf-8") as dst:

        # 写入结果文件的表头
        dst.write("时间戳 | 请求路径 | 状态码\n")
        dst.write("-" * 40 + "\n")

        for line in src:
            clean_line = line.strip()
            if not clean_line:
                continue

            if " 500 " in clean_line:
                parts = clean_line.split(" ")
                if len(parts) >= 5:
                    timestamp = f"{parts[0]} {parts[1]}"
                    path = parts[3]
                    status = parts[4]
                    dst.write(f"{timestamp} | {path} | {status}\n")
                    error_count += 1

    return error_count

if __name__ == "__main__":
    # 配置输入与输出路径
    src_path = "server.log"
    out_path = "errors_summary.txt"

    # 模拟生成测试数据便于本地立即验证
    with open(src_path, "w", encoding="utf-8") as f:
        f.write("2026-11-02 08:30:15 GET /api/v1/user 200 45ms\n")
        f.write("2026-11-02 08:31:02 POST /api/v1/order 500 520ms\n")
        f.write("2026-11-02 08:32:44 GET /api/v1/health 200 12ms\n")
        f.write("2026-11-02 08:35:19 GET /api/v1/payment 500 890ms\n")

    total_errors = filter_server_errors(src_path, out_path)
    print(f"分析完成!共识别并导出 {total_errors} 条服务器异常记录。")
print(f"结果已保存至: {out_path}")分析完成!共识别并导出 2 条服务器异常记录。 结果已保存至: errors_summary.txt
步骤五:闭环检验——不看源码独立复刻
这是决定知识能否转化为自身肌肉记忆的关键一步。当你跟着教程写完上述 40 行脚本并顺利运行后,不要立刻觉得自己“学会了”。请关闭当前代码编辑器窗口,打开一个全新的空文件 log_analyzer_v2.py,仅根据步骤一的中文逻辑清单,独立将代码重新实现一遍。
在复刻过程中,你可能会卡在 split() 的参数上,或者忘记 with 的用法。此时不要看原文件,而是通过查阅 Python 官方文档或搜索引擎解决。当你能独立从零敲出这个可执行脚本时,才真正完成了从语法到项目的闭环。
四、全周期规划:零基础四阶段渐进式演进路线图
为了让学习者在不同阶段始终保持明确的目标感,我们将整个学习路径划分为四个阶段。每个阶段都严格定义了时间配比、核心学习输入、代表性里程碑项目以及达标考核判据。
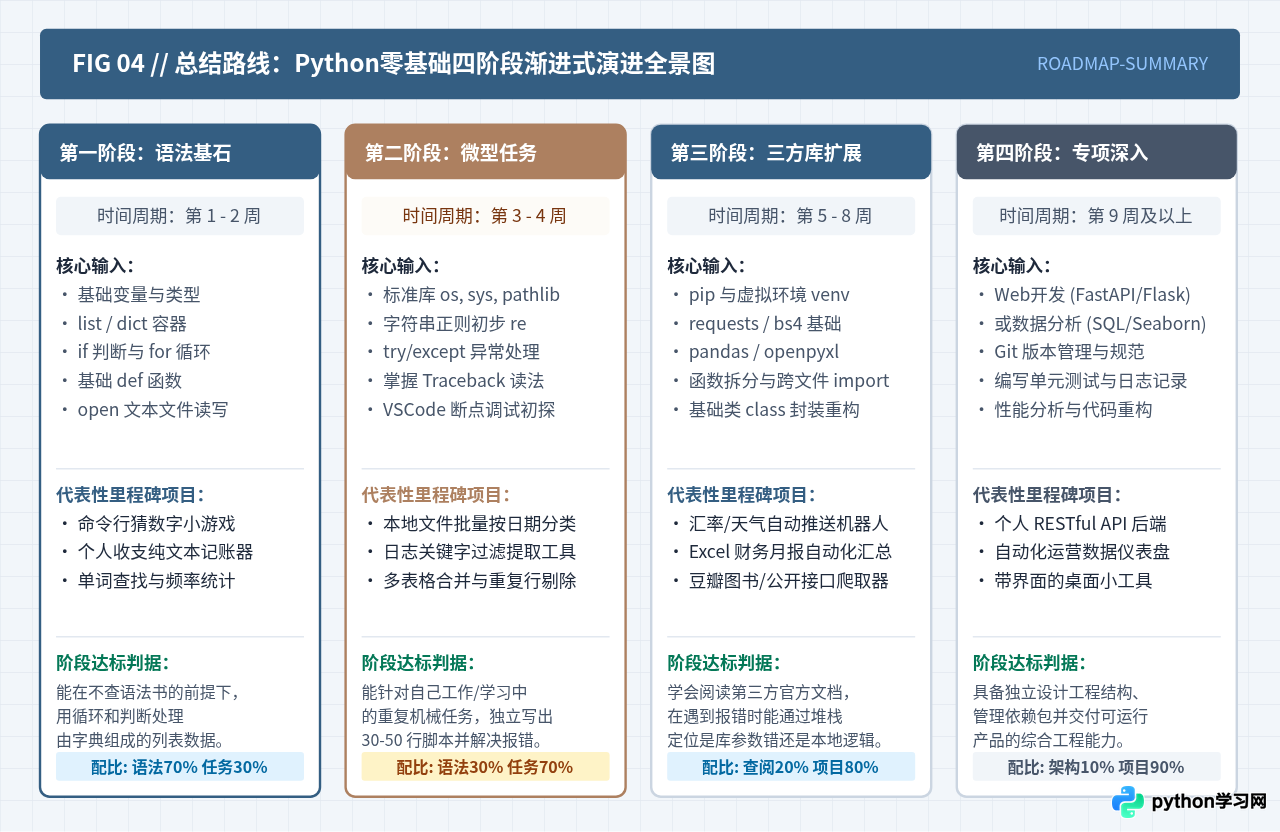
阶段一:语法基石收敛期(建议时长:1 - 2 周)
- 时间与精力配比:语法概念 70%,微型验证练习 30%。
- 目标:建立代码语感,掌握基础数据类型、控制流程、自定义函数与基本文件读写,形成最小必要语法体系。
- 代表性练习:
- 命令行猜数字互动程序(综合运用
random、while、input、if/elif/else); - 纯文本账目记录器(将用户输入的花费以结构化格式追加写入
expense.txt); - 单词统计工具(读取英文文本,使用字典统计每个单词出现的频次并输出前 5 名)。
- 命令行猜数字互动程序(综合运用
- 合格检验标志:能在脱离语法教材参考的前提下,独立使用循环、字典和条件分支组织出 20 行无语法报错的单文件脚本。
阶段二:微任务闭环实践期(建议时长:2 - 3 周)
- 时间与精力配比:语法查阅 30%,实际场景写脚本 70%。
- 目标:走出单行测试,针对本地真实文件与重复性任务编写 30 至 60 行的小工具;建立定位和阅读 Traceback 堆栈报错的能力。
- 代表性练习:
- 基于
pathlib或os的本地文件批量规范重命名(如给目录下全部照片自动加上修改日期前缀); - 多份 CSV 数据文件的格式校验、缺失值过滤与总计合并;
- 简易系统监控提示器(读取磁盘或内存占用,超过阈值时在控制台告警)。
- 基于
- 合格检验标志:面对报错信息能够迅速指出报错所在的代码行数,区分
IndexError与KeyError的根本原因并自行修复。
阶段三:第三方生态与工程化进阶(建议时长:4 周左右)
- 时间与精力配比:阅读第三方库官方文档 20%,工程实践 80%。
- 目标:掌握包管理工具(
pip)与虚拟环境(venv);按需学习网络请求库(requests)或数据分析库(pandas/openpyxl);在代码规模扩大后引入类(OOP)组织结构。 - 代表性练习:
- 天气与汇率自动化查询脚本(调用公开 RESTful API,解析 JSON 并格式化输出);
- 自动化 Excel 财务日报汇总生成器(读取多个部门工作簿,合并为汇总报表并设置高亮样式);
- 轻量级特定网页信息抓取与存储器(利用
requests+BeautifulSoup提取公开图书榜单并保存为 CSV)。
- 合格检验标志:能够根据第三方库的 Quickstart 官方英文文档,在未看过视频教程的情况下完成库的安装、配置与单点功能调用。
阶段四:专项领域深耕(第 9 周及以后)
进入此阶段后,“先学语法还是做项目”已不再是困惑。学习者应根据实际职业或业务需求,选择单一垂直分支深入:
- Web 与 API 开发方向:深入学习
FastAPI或Flask,理解 HTTP 状态码、路由系统、SQLAlchemy ORM 与数据库交互设计; - 数据分析与可视化方向:深入掌握
pandas高级数据透视、numpy向量计算以及matplotlib/seaborn图表绘制; - 自动化与运维开发方向:学习并发框架、定时任务调度(如
schedule/celery)以及命令行工具开发(如click/typer)。
五、常见认知误区与避坑指南
视频教学具有强烈的“被动输入”特性。讲师在屏幕上流畅敲出的代码,已经过精心的预演与调试。很多读者在看视频时觉得思路清晰无比,可一旦关掉视频面对空白编辑器,大脑瞬间空白。纠偏措施:每看完 15 分钟视频,必须立刻停下播放,用自己的键盘亲手将演示代码敲一遍,并故意改动其中一个变量或参数,观察程序的反应。
初学者在看到红色的 Traceback 堆栈报错时往往心生恐惧,下意识觉得是全盘逻辑写错了,甚至把整段代码删掉重敲。纠偏措施:Python 的报错提示极其精准。解决报错只需要盯住两处:第一,看堆栈最下方的一行,明确错误类型(如
NameError: name 'val' is not defined);第二,看倒数第二行,确认报错发生在哪一个具体文件的第几行。根据定位直接查看对应变量的赋值过程,精准排障。
部分初学者在刚学会写几个函数时,就急于把代码重构为包含抽象基类、工厂模式、单例模式的复杂架构,导致几十行的实用功能被膨胀为数百行的过度设计。纠偏措施:严格遵守 Python 之禅(Zen of Python)中的原则:“Simple is better than complex(简单优于复杂)”和“Flat is better than nested(扁平优于嵌套)”。在初期阶段,能用 30 行平铺直叙的函数解决的问题,坚决不抽象为类。
六、总结速查:行动判定清单
回到标题的核心提问:“Python零基础学习路线:先学语法还是直接做项目?”
你的执行决策可以用以下三条明确的行动准则进行判定:
- 第一阶段严守“两周限期”:用不超过两周的时间通读并掌握“变量、列表字典、循环分支、自定义函数、文件基础读写”这五个 MVS 语法点。一旦这五个点可以在终端跑通,立即叫停语法通读,坚决不翻看后续高级章节。
- 第二阶段只接“微型任务”:寻找真实生活或工作中的微小痛点(批量重命名、文本提取、数据清洗),将目标限制在 20 至 50 行代码以内。通过“中文清单 → 语法积木 → 单点测试 → 组装复现”的五步法完成闭环。
- 第三阶段坚决“按需驱动”:高级语法、第三方库和面向对象设计,永远只在写项目遇到瓶颈(例如原生列表处理速度不够、需要网络交互、函数参数过载)时,针对性查阅 1 至 2 小时。
以极简语法构筑地基,用微型项目驱动成长,随着项目规模的自然生长逐步吸纳工程进阶知识。这才是零基础读者走出自学迷茫、真正获得编程能力的科学学习路线。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















