


Python open函数读取文件的基本语法与参数详解

open()是与操作系统底层I/O接口交互的核心桥梁。在读取文件时,只要掌握它的基础调用语法、关键参数的作用机制(特别是编码格式与异常策略),并配合with上下文管理器,就能以安全、稳定且高效的方式处理各类纯文本与二进制数据文件。
一、open函数的基本调用语法与生命周期管理
在Python中,open()函数无需导入任何外部模块,属于内置命名空间函数。它的核心职责是接收文件路径并向操作系统申请建立文件描述符,最终返回一个具有读写能力的文件流对象(File Object)。
函数的完整形式签名如下:
open(file, mode='r', buffering=-1, encoding=None, errors=None, newline=None, closefd=True, opener=None)在绝大多数读取场景下,我们并不需要为所有参数传值,但推荐始终使用with语句管理文件生命周期。与传统手动调用close()相比,with语句基于Python上下文管理器协议(Context Manager),在代码块执行结束或中途发生未捕获异常时,能够确保文件描述符被操作系统及时安全回收,彻底杜绝句柄泄漏。
# 标准安全的文本读取语法
with open("data.txt", mode="r", encoding="utf-8") as f:
    content = f.read()
    print("读取完成,文本长度:", len(content))
# 离开代码块后,f 已经被自动关闭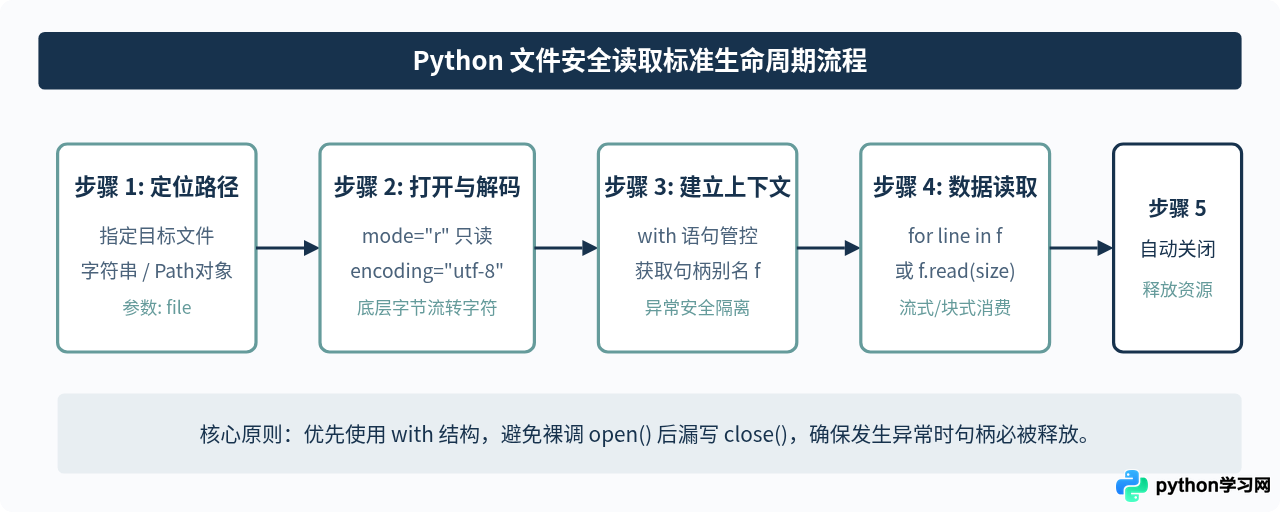
二、核心参数分类与详细功能解析
深入理解 open() 的各参数,是写出健壮读取代码的前提。我们可以将参数划分为三组:路径与访问模式、字符编解码与格式控制、底层性能与系统参数。
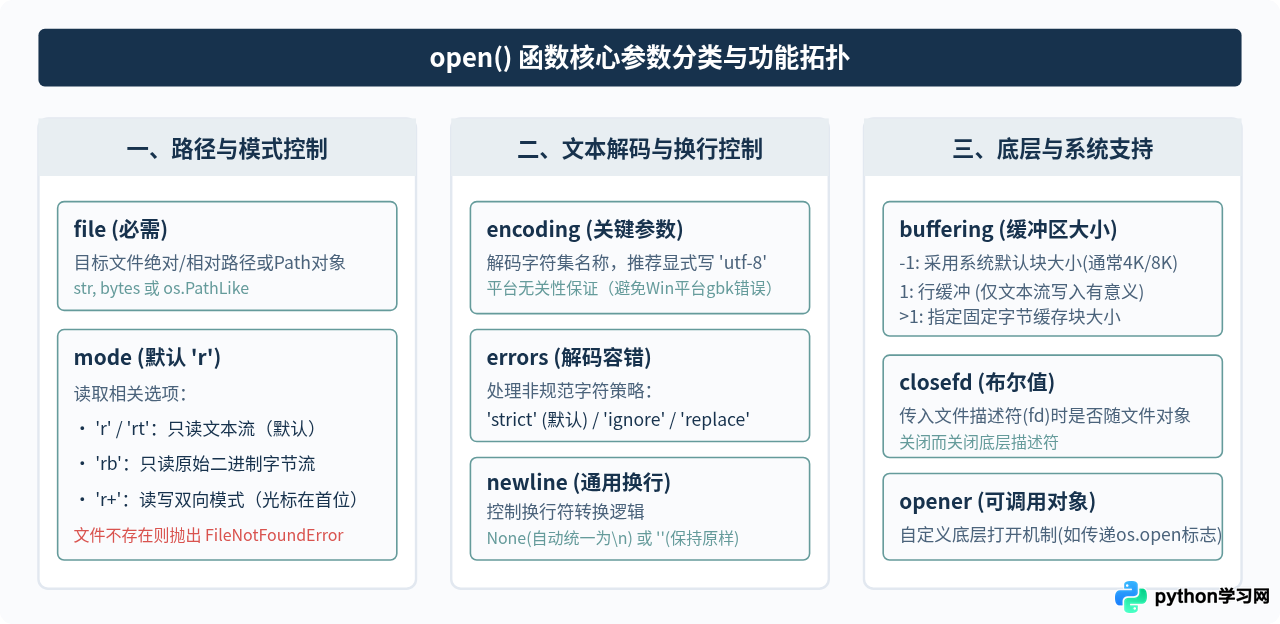
1. file 参数:如何准确传递文件路径
file 参数指定要打开的目标。不仅可以传入绝对路径或相对于当前工作目录的相对路径字符串,还可以直接使用现代 Python 推荐的 pathlib.Path 对象:
from pathlib import Path

# 使用 pathlib.Path 作为 file 参数
target_file = Path("configs") / "app.json"
with open(target_file, mode="r", encoding="utf-8") as f:
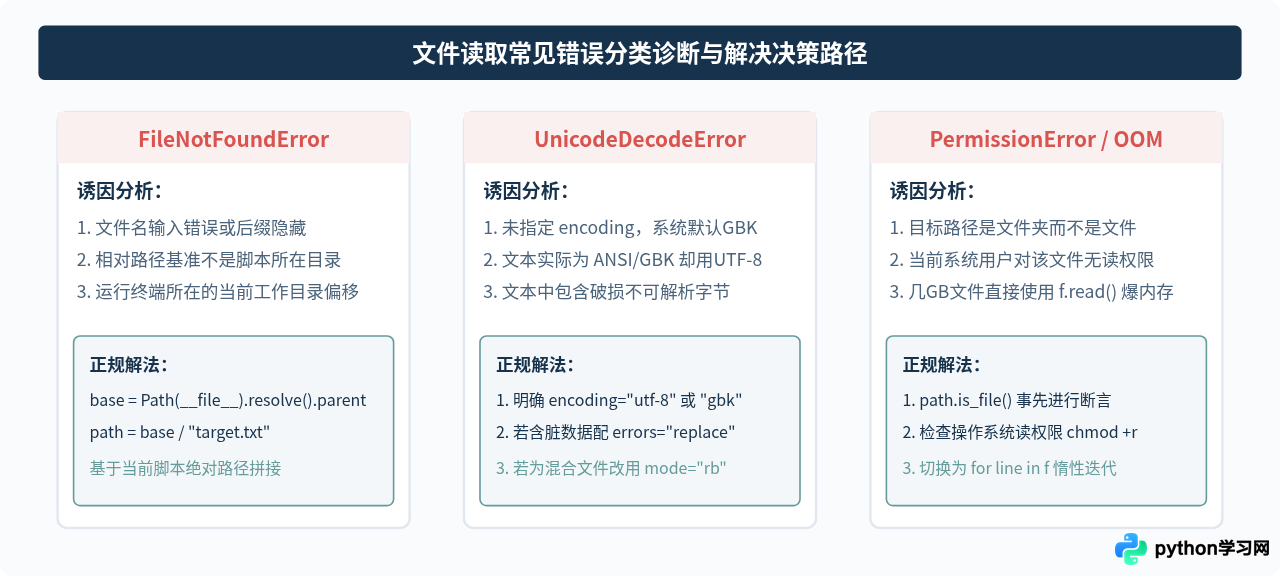
text = f.read()特别需要提醒的是:相对路径解析依赖于当前工作目录(即 os.getcwd()),而非代码脚本所在的物理目录。在多模块项目或不同终端目录执行时,常因路径不一致引发 FileNotFoundError。
2. mode 参数:明确读取目标是文本还是字节
针对读取场景,常用的模式组合有:
| 模式标识 | 模式名称 | 返回值类型 | 行为说明与边界条件 |
|---|---|---|---|
'r' 或 'rt' |
文本只读(默认) | str |
打开并按照指定编码解析文本。如果文件不存在,抛出 FileNotFoundError。 |
'rb' |
二进制只读 | bytes |
读取原始字节流,不经过任何编码转换。适用于图片、音视频、序列化二进制文件。此时禁止设置 encoding 和 errors 参数。 |
'r+' |
读写模式 | str |
打开文件可同时读写,文件指针初始位于起始位置(偏移量0)。写入时会从当前指针位置覆写后续内容。文件不存在同样报错。 |
3. encoding 参数:跨平台文本读取的核心防线
在 Python 3 中,文本文件在底层都是以二进制字节存储的。encoding 参数指明了将这些字节反序列化为内存中 str(Unicode字符串)的字符集标准。
encoding,Python 会采用当前操作系统的默认编码(通常通过 locale.getpreferredencoding(False) 获取)。在 Linux 和 macOS 上通常是 utf-8,而在简体中文 Windows 操作系统上往往是 gbk(CP936)。如果一个 UTF-8 编码的文件在 Windows 上以默认参数打开,极易触发 UnicodeDecodeError: 'gbk' codec can't decode byte... 崩溃。因此在编写所有读取文本的代码时,强烈建议显式声明 encoding="utf-8"。
4. errors 参数:优雅处理编码异常
当文件中混入了损坏的字节、未知的扩展编码或混合格式时,errors 参数定义了解码器遇到非法字节时的应对策略:
errors="strict"(默认):遇到任何解码错误立刻抛出UnicodeDecodeError,保证数据绝对严谨。errors="ignore":直接丢弃无法解码的非法字节序列,保证程序继续执行,但可能导致字符丢失。errors="replace":将无法识别的字节序列替换为 Unicode 官方替换字符�(通常显示为一个带问号的菱形),既不中断程序,又能清晰保留异常位置。errors="backslashreplace":将非法字节转换为形如\xNN的十六进制转义形式,非常适合排查底层字节问题。
# 在处理来源复杂、可能夹杂乱码的日志文件时:
with open("legacy_server.log", mode="r", encoding="utf-8", errors="replace") as f:
    for line in f:
        process_log_line(line)
5. newline 参数:通用换行符转换机制
不同操作系统上的换行符存在差异:Windows 为 \r\n,Linux/macOS 为 \n,早期 macOS 为 \r。
在读取文本时,newline 参数控制通用换行符模式(Universal Newlines):
newline=None(默认):输入流中的所有\r\n、\r均会被自动翻译为统一的标准\n字符交付给 Python。newline='':禁用换行符翻译,文件中实际是什么换行符,读取出的字符串中就保留原本的符号(对于解析 CSV 格式、校验原始文件哈希值非常有用)。newline='\n'或newline='\r\n':只将指定的符号识别为行结束,其他符号不予处理。
三、四大文件读取方法对比与内存策略
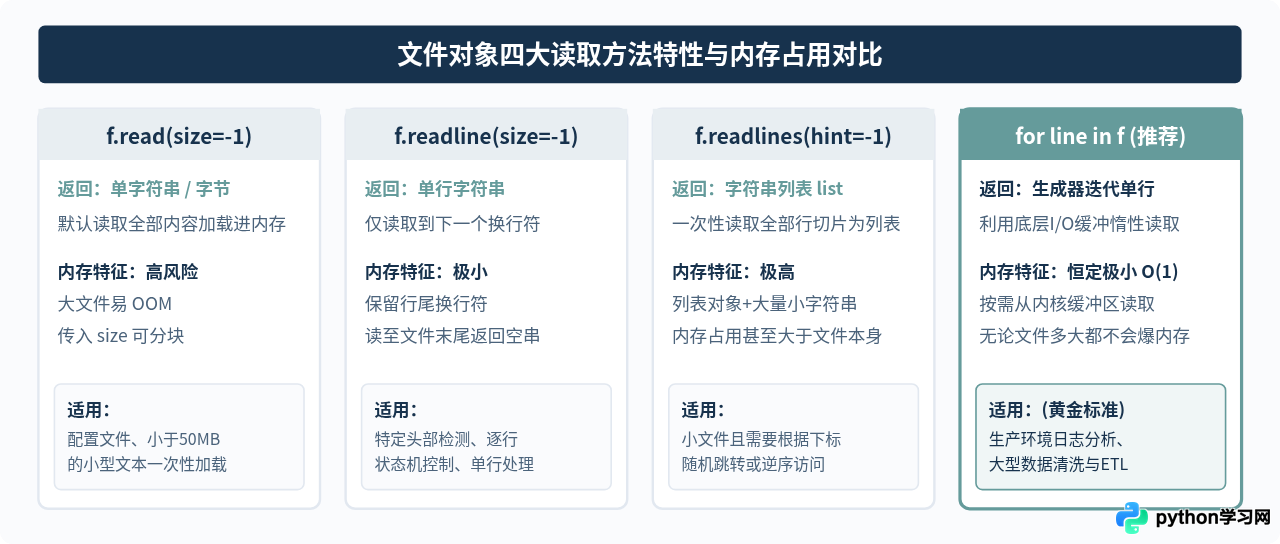
打开文件获取句柄后,如何调用读取方法直接决定了程序的执行效率与内存开销。Python 提供了四种主要的读取方式。
大文件读取的黄金标准代码
对于可能达到数百兆甚至数十吉字节(GB)的日志文件,直接调用 f.read() 或 f.readlines() 会直接耗尽系统可用内存。最佳方案是直接对文件句柄进行 for 循环迭代,或者按固定块大小读取:
# 方案 A:针对文本日志文件的逐行流式读取(内存占用极低)
line_count = 0
with open("massive_access.log", mode="r", encoding="utf-8") as f:
    for line in f:
        # strip() 去除首尾空白及换行符
        cleaned_line = line.strip()
        if cleaned_line:
            line_count += 1
print(f"有效数据行数:{line_count}")

# 方案 B:针对超大二进制文件的固定块缓冲读取(以64KB为一块)
CHUNK_SIZE = 64 * 1024
with open("archive.tar.gz", mode="rb") as f:
    while True:
        chunk = f.read(CHUNK_SIZE)
        if not chunk:  # 读取完毕返回空字节 b''
            break
        # 处理当前 64KB 块数据
        compute_checksum(chunk)
四、常见报错排查与最佳实践总结
在使用 open() 函数读取文件时,绝大多数生产环境报错都可以归类到以下三种场景。依照规范的排查决策树,可以快速修复问题。
规范读取代码的最佳实践清单
- 杜绝裸用 open():无论是多小的脚本,都养成使用
with open(...) as f:的习惯。 - 文本读取必填 encoding:在所有跨平台或团队协作项目中,必须显式传递
encoding="utf-8"。 - 优先使用 pathlib 管理路径:使用
Path(__file__).resolve().parent / "filename"规避相对路径定位错位。 - 按行或按块处理大数据:大文件严禁使用
f.read()和f.readlines(),采用for line in f保持内存恒定。 - 二进制文件切断编码参数:当使用
mode="rb"时,切勿传入encoding或errors参数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















