


Python爬虫解析JSON API接口提取结构化数据实例

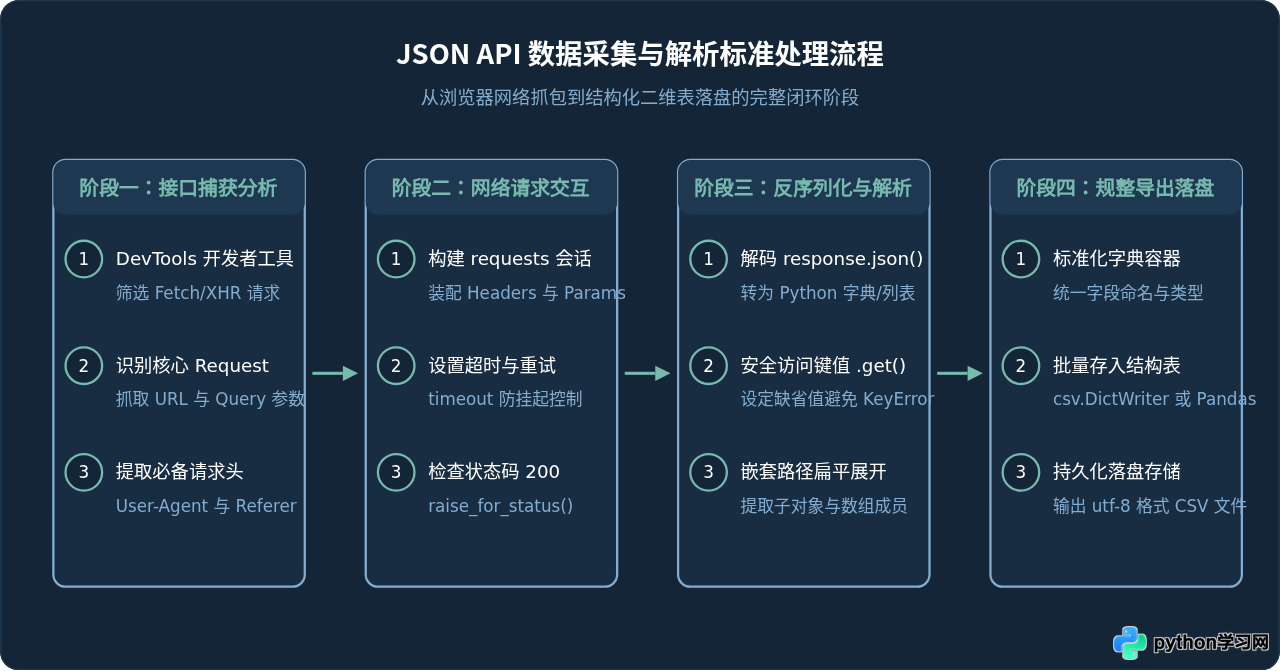
在网络数据采集实践中,很多现代网页不再将完整数据直接渲染在服务端的初始 HTML 文档中,而是先加载基础页面骨架,再通过异步请求(AJAX 或 Fetch)向后端 JSON API 接口拉取业务数据。面对这类网站,若仍尝试解析杂乱多变的 HTML DOM 树,不仅容易因为前端样式改动而导致爬虫频繁失效,解析效率也较低。直接针对底层 JSON API 发起请求并解析其返回的结构化报文,是目前更稳健、高效的数据采集途径。本文将通过一个真实可落地的实战流程,演示如何排查接口、发送网络请求、安全解构深层嵌套数据,并最终将目标字段规整导出为结构化数据表格。
一、为什么优先抓取 JSON API 而非解析 HTML
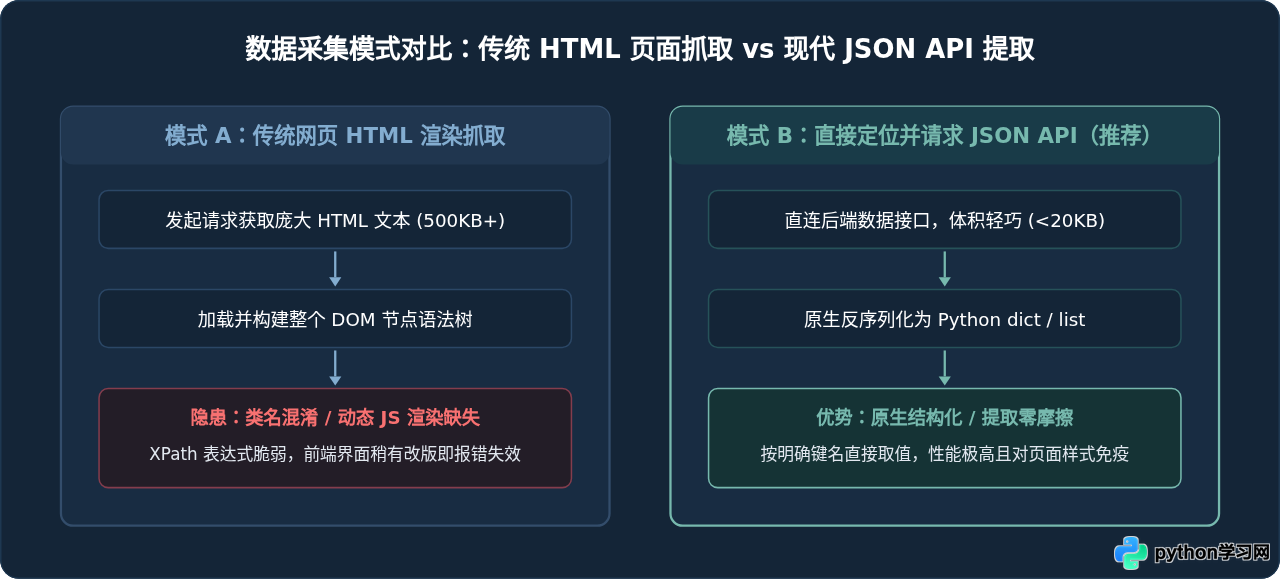
很多初学者在编写爬虫时习惯使用 BeautifulSoup、lxml 或正则表达式去解析整个页面的 HTML 标签。然而,对于现代基于前后端分离架构的应用而言,这种传统方式往往事倍功半。下表概括了两者的核心差异:
| 对比维度 | 传统 HTML 页面解析 | 直接调用 JSON API 接口 |
|---|---|---|
| 数据载体 | 嵌套复杂的 DOM 树(包含大量布局标签与样式) | 紧凑的 JSON 格式文本(纯业务键值数据) |
| 解析成本 | 高:需要编写针对性 CSS 选择器或 XPath 路径 | 极低:通过字典键名(Key)直接精准访问 |
| 稳定性 | 较差:前端 UI 页面改版、类名重构极易导致脚本崩溃 | 较高:API 数据契约通常具备向下兼容性 |
| 传输网络开销 | 庞大:夹带大量无用 HTML、CSS、JS 文本 | 小:只传输有效业务字段与分页指标 |
二、通过开发者工具抓取并分析目标 API
要抓取 JSON 数据,第一步是获取浏览器与服务器通信的真实接口地址及必要参数。具体操作步骤如下:
- 打开网络面板:在 Chrome、Edge 或 Firefox 浏览器中按下
F12打开开发者工具(DevTools),切换至 Network(网络) 面板。 - 过滤异步请求:点击面板顶部的 Fetch/XHR 过滤器。此时网络请求列表中仅会显示异步数据接口。
- 触发数据刷新:在页面上进行翻页、滚动加载更多或点击搜索,此时列表中会新增多条网络请求记录。
- 查看响应报文:依次点击请求条目,在右侧的 Response(响应) 或 Preview(预览) 标签页中查找返回的 JSON 数据树。当找到包含目标文章列表或商品信息的接口时,记录下对应的 Request URL。
- 检查关键请求头:切换至 Headers 标签,检查
Request Method(一般为 GET 或 POST)以及必要的请求头。通常至少需要带上User-Agent,部分需要权限验证的接口还会要求携带Authorization、Token或特定Cookie。
三、请求接口并解析嵌套 JSON 结构实例
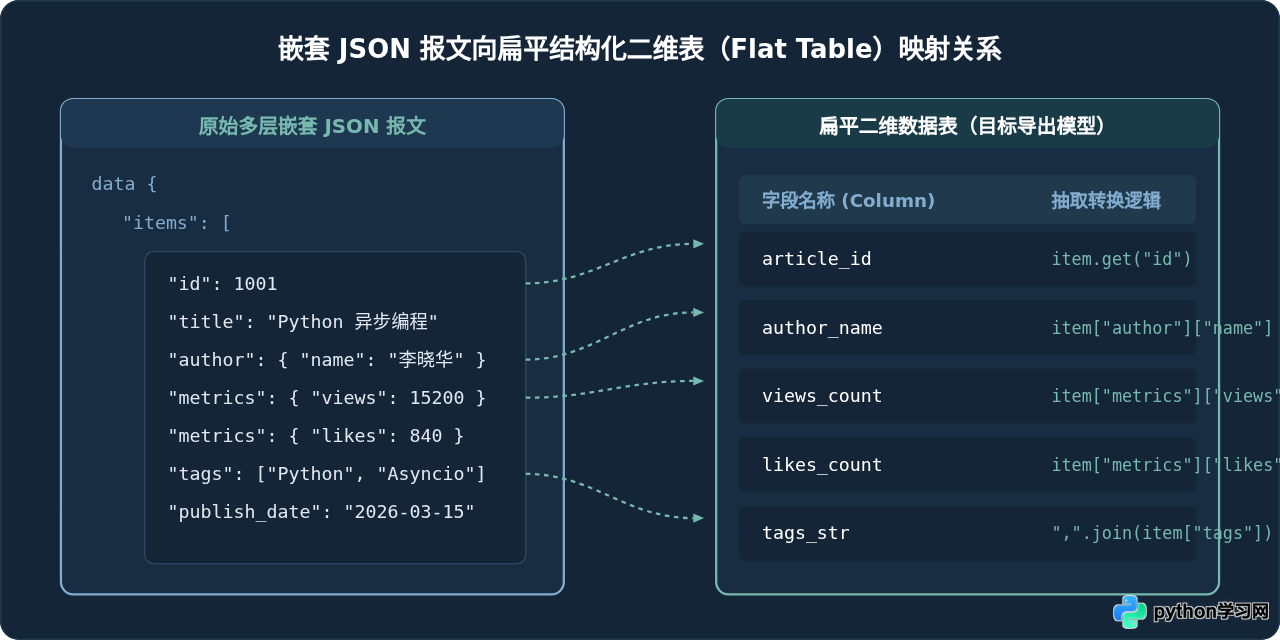
假设我们通过分析定位到了一个文章列表接口,其返回的典型 JSON 数据报文如下所示。该结构具有真实业务中普遍存在的多层嵌套特征:顶层包含状态码与分页元数据,数据实体存放在 data.items 列表中,而每篇文章的作者信息和分类标签又进一步嵌套在子字典和列表中。
{
  "code": 200,
  "message": "success",
  "data": {
    "total": 45,
    "page": 1,
    "page_size": 2,
    "items": [
      {
        "id": 1001,
        "title": "Python 异步并发编程指南",
        "author": {
          "user_id": 8801,
          "name": "李晓华"
        },
        "metrics": {
          "views": 15200,
          "likes": 840
        },
        "tags": ["Python", "Asyncio", "网络编程"],
        "publish_date": "2026-03-15"
      },
      {
        "id": 1002,
        "title": "分布式爬虫架构设计实战",
        "author": {
          "user_id": 8802,
          "name": "张建国"
        },
        "metrics": {
          "views": 9800,
          "likes": 512
        },
        "tags": ["爬虫", "架构", "Redis"],
        "publish_date": "2026-03-18"
      }
    ]
  }
}
编写单页抓取与字段清洗脚本
在解析多层嵌套 JSON 时,切勿直接使用链式下标如 item["author"]["name"],因为一旦某一篇文章没有作者信息(该字段为 None 或缺失),程序就会直接抛出 KeyError 或 TypeError 并中断崩溃。最安全的做法是使用字典的 .get() 方法并提供合理默认值。
import requests
import json
from typing import List, Dict, Any

def fetch_single_page(api_url: str, page: int = 1) -> List[Dict[str, Any]]:
    """
    请求指定分页的 JSON API 接口,并提取清洗为扁平结构化列表
    """
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
        "Accept": "application/json, text/plain, */*",
        "Referer": "https://example.com/articles"
    }
    params = {
        "page": page,
        "page_size": 10
    }

    try:
        # 显式指定超时时间,防止因远端无响应导致爬虫永久挂起
        response = requests.get(api_url, headers=headers, params=params, timeout=10)
        response.raise_for_status()  # 若状态码非 200 则抛出 HTTPError 异常
    except requests.exceptions.RequestException as e:
        print(f"[网络错误] 请求接口失败 (page={page}): {e}")
        return []

    try:
        data_payload = response.json()
    except json.JSONDecodeError:
        print(f"[解析错误] 响应内容并非合法 JSON 字符串")
        return []

    # 校验顶层状态码
    if data_payload.get("code") != 200:
        print(f"[业务错误] 接口返回异常状态码: {data_payload.get('code')}")
        return []

    # 获取文章数据列表
    raw_items = data_payload.get("data", {}).get("items", [])
    extracted_records: List[Dict[str, Any]] = []

    for item in raw_items:
        # 安全读取子字典
        author_info = item.get("author") or {}
        metrics_info = item.get("metrics") or {}
        tags_list = item.get("tags") or []

        # 规整出扁平的一维记录
        record = {
            "article_id": item.get("id"),
            "title": str(item.get("title", "")).strip(),
            "author_id": author_info.get("user_id"),
            "author_name": author_info.get("name", "匿名作者"),
            "views": int(metrics_info.get("views", 0)),
            "likes": int(metrics_info.get("likes", 0)),
            "tags": ";".join(tags_list),  # 列表转为分号拼接字符串以适配 CSV 单元格
            "publish_date": item.get("publish_date", "")
        }
        extracted_records.append(record)

    return extracted_records
四、完整实战:自动分页抓取与 CSV 数据导出
实际生产需求通常需要遍历全部分页。API 分页通常有两种常见模式:基于页码与页长的 page / page_size 模式,以及基于游标或偏移量的 cursor / offset 模式。本实例演示最常用的 page 分页抓取,配合终止条件检测与 csv.DictWriter 模块,将抓取结果持续存储为标准的 UTF-8 CSV 文件。
import os
import csv
import time
import requests
from typing import List, Dict, Any

def scrape_all_pages_to_csv(output_filepath: str, base_api_url: str, max_pages: int = 5):
    """
    循环遍历 API 接口所有分页,并将规整后的数据持久化写入 CSV 文件
    """
    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept": "application/json"
    }

    fieldnames = [
        "article_id",
        "title",
        "author_id",
        "author_name",
        "views",
        "likes",
        "tags",
        "publish_date"
    ]

    total_records = 0
    # 采用 utf-8-sig 编码,确保在 Excel 打开时不会出现中文乱码
    with open(output_filepath, mode="w", encoding="utf-8-sig", newline="") as csvfile:
        writer = csv.DictWriter(csvfile, fieldnames=fieldnames)
        writer.writeheader()

        for current_page in range(1, max_pages + 1):
            print(f"[进度信息] 正在抓取第 {current_page} 页数据...")
            params = {"page": current_page, "page_size": 20}

            try:
                resp = requests.get(base_api_url, headers=headers, params=params, timeout=12)
                if resp.status_code != 200:
                    print(f"[告警] 第 {current_page} 页返回非 200 状态码: {resp.status_code},停止翻页")
                    break
                json_data = resp.json()
            except Exception as exc:
                print(f"[异常] 抓取第 {current_page} 页发生异常: {exc}")
                break

            # 提取列表
            items = json_data.get("data", {}).get("items", [])
            if not items:
                print("[完成] 接口返回空列表,已到达末尾分页,正常退出循环。")
                break

            for item in items:
                author = item.get("author") or {}
                metrics = item.get("metrics") or {}
                row = {
                    "article_id": item.get("id"),
                    "title": str(item.get("title", "")).strip(),
                    "author_id": author.get("user_id"),
                    "author_name": author.get("name", "未知"),
                    "views": metrics.get("views", 0),
                    "likes": metrics.get("likes", 0),
                    "tags": ";".join(item.get("tags") or []),
                    "publish_date": item.get("publish_date", "")
                }
                writer.writerow(row)
                total_records += 1

            # 礼貌爬取:增加短暂睡眠,避免高频请求触发对方接口的限流熔断
            time.sleep(1.0)

    print(f"[任务结束] 成功采集并存储共计 {total_records} 条结构化数据至: {output_filepath}")

if __name__ == "__main__":
    # 示例调用
    TARGET_API = "https://api.example.com/v1/posts/list"
    OUTPUT_FILE = "structured_posts.csv"
scrape_all_pages_to_csv(OUTPUT_FILE, TARGET_API, max_pages=10)encoding="utf-8-sig" 能够自动在文件首部写入 UTF-8 BOM 标记,这样即使在 Windows 系统的 Microsoft Excel 中直接双击打开该 CSV 文件,中文字符也能正常显示,避免乱码。
五、工程化可靠性与常见问题排查
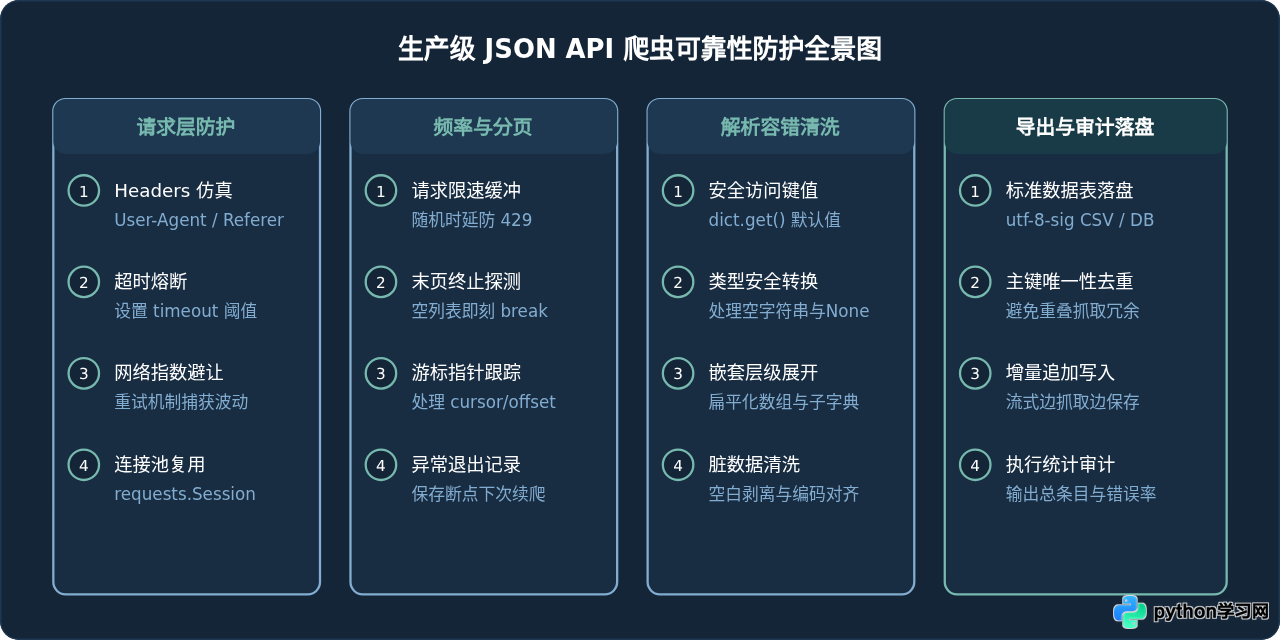
在面对生产环境中的各类复杂 API 时,爬虫开发者往往会遇到以下典型问题:
- 接口返回 403 Forbidden 或 419:说明目标服务检测到了非浏览器特征。除了配置完整的
User-Agent之外,重点补全Referer、Origin以及从浏览器复制而来的合法Cookie。 - 动态签名与加密参数(Token / Sign):部分接口在 URL 或请求体中包含类似
sign=d41d8cd98f00b204e9800998ecf8427e的参数。此时可在开发者工具中全局搜索该参数名,定位生成该签名的 JavaScript 逻辑,或借助浏览器自动化工具获取动态凭证。 - 频繁触发 429 Too Many Requests:此状态码代表触发了接口的速率限制(Rate Limiting)。应在每次请求之间加入随机延迟(如
time.sleep(random.uniform(1.5, 3.5))),必要时引入请求代理池分散来源 IP。 - 字段类型动态漂移:某些非规范 API 在没有数据时可能返回
"views": ""(空字符串)而不是0或null。在类型强转前必须增加兼容判断,避免int("")引发ValueError。
总结
直接通过抓取后端 JSON API 提取数据,避免了繁重的 DOM 解析工作,并且能够显著提高爬虫系统的执行速度与长期维护性。在构建爬虫脚本时,只要遵循“定位接口 → 补全请求头 → 安全解构嵌套 JSON → 处理分页终止 → 规范落盘导出”的标准化流程,就能在保证高效稳定的同时,轻松获得整洁规范的高质量结构化数据。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















