


人工智能为什么首选Python:生态库与开发效率深度解析

Python 能够成为人工智能与机器学习领域的绝对首选语言,本质原因并非其运行性能,而在于其“高层胶水表达 + 底层高性能引擎”的双层解耦架构,以及由此构建起的巨大且不可逆的生态库协同网络。它使得算法工程师与研究人员能够以最低的认知摩擦快速将数学公式转化为计算逻辑,而耗费算力的密集矩阵运算与并行加速则直接交由底层 C/C++ 与 CUDA 高效执行。
一、架构机理解析:双层解耦如何化解性能短板
初涉人工智能领域的开发者常有一个普遍疑问:Python 作为一种带有全局解释器锁(GIL)且运行速度远慢于 C/C++ 或 Rust 的动态解释型语言,为何能在对算力要求极高的 AI 领域占据主导地位?
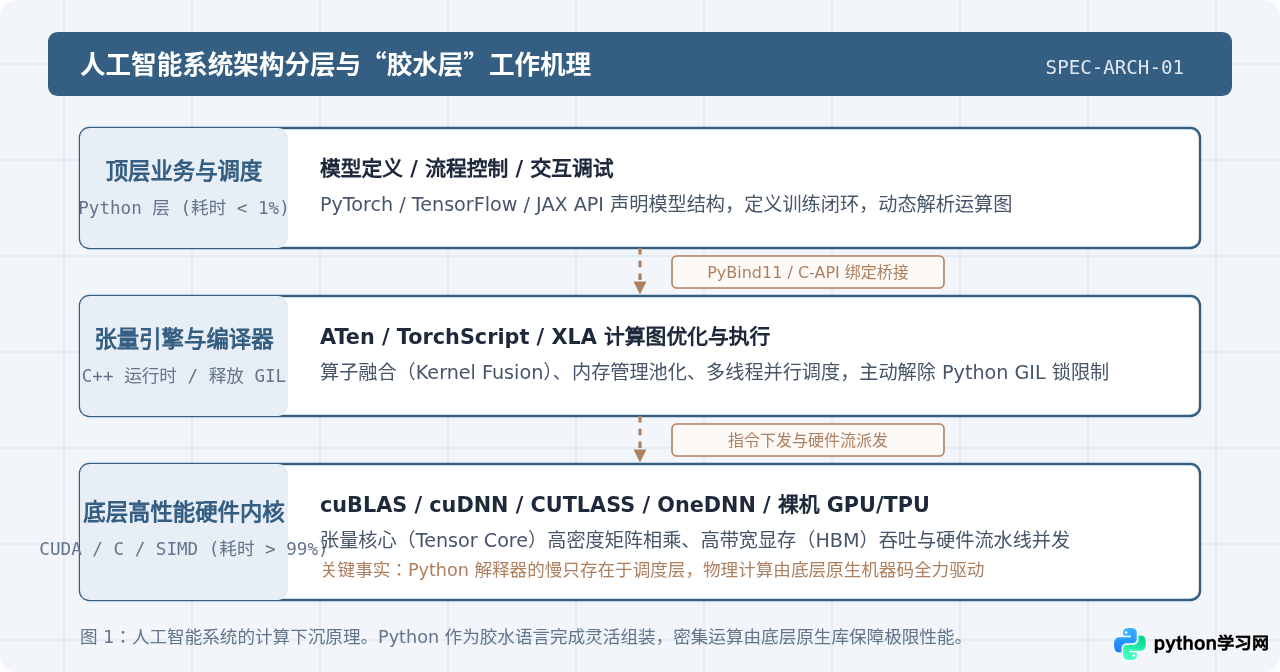
答案在于人工智能软件栈的双层解耦设计(Two-Language Architecture)。在典型的深度学习任务中,整个系统被清晰地划分为两层:
- 顶层调度与表达层(Python 负责):承担模型结构搭建、超参数配置、数据加载流转、损失函数定义及训练流程编排。这部分代码执行频率低,属于毫秒级甚至秒级的控制逻辑,对 CPU 执行耗时极不敏感。
- 底层密集计算层(C/C++ 与 CUDA 负责):承担卷积、张量乘法、反向传播梯度推导、显存数据搬运等任务。这部分由底层的 cuBLAS、cuDNN、OneDNN 以及手写的 SIMD 向量化指令执行,直接运行在底层硬件与 GPU 流处理器之上。
当你在 Python 中编写一行简单的矩阵乘法代码 torch.matmul(A, B) 时,Python 解释器仅负责参数合法性校验并迅速生成调用指令,耗时占比通常不足 0.1%;随后的数亿次浮点运算全部在编译好的 CUDA 内核中以接近芯片物理极限的吞吐量执行。此时,语言本身的运行速度差异被底层庞大的计算耗时完全摊薄。
GIL(全局解释器锁)在 AI 计算中为何失效?
众所周知,CPython 解释器的全局解释器锁(GIL)使得多线程无法在多核 CPU 上同时执行 Python 字节码。但在 AI 框架中,这一缺陷被巧妙规避:
当 Python 调用底层 C++ 算子(如 PyTorch 的 ATen 库)启动密集计算时,扩展层会主动执行宏 Py_BEGIN_ALLOW_THREADS,显式释放 GIL 锁。此时,计算线程脱离 Python 运行时管控,底层的 OpenMP 或 CUDA 流可以自由利用多核心 CPU 与多 GPU 流处理器进行硬件级并行运算;计算完成后再通过 Py_END_ALLOW_THREADS 重新获取锁将结果返回。因此,GIL 并没有阻碍 AI 计算的横向扩展。
二、开发效率与实验迭代闭环:算法探索的核心诉求
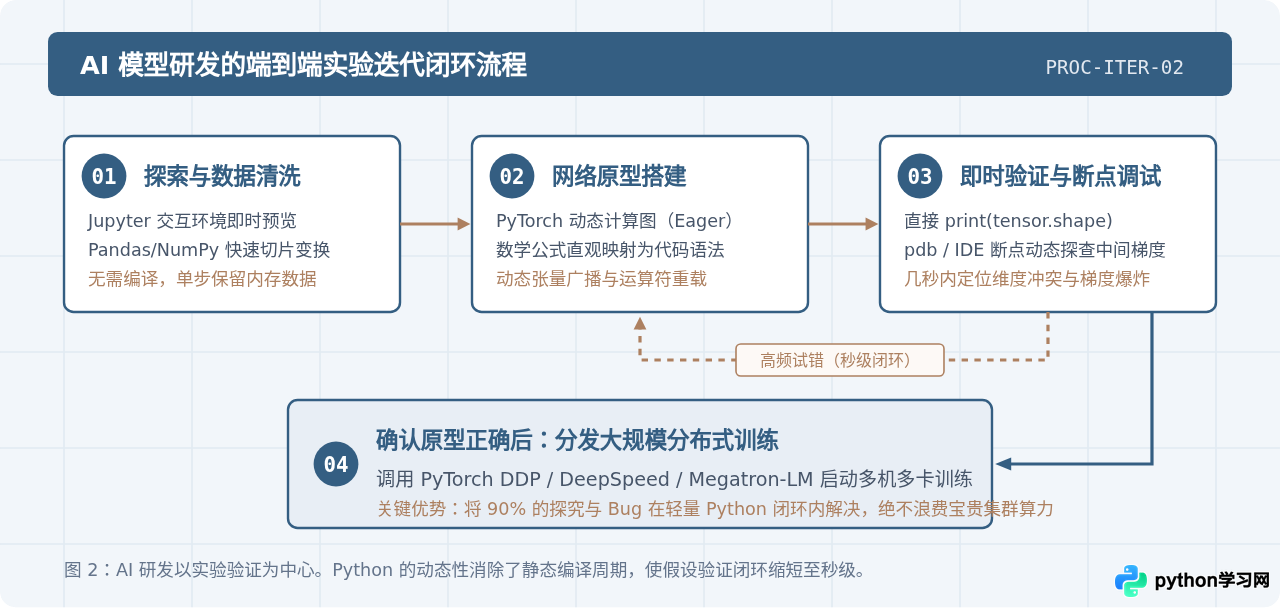
人工智能模型的研发与传统软件工程存在根本差异。传统工程往往有着明确的确定性业务逻辑与系统架构规范;而 AI 研发本质上是高频探索性科学实验。
一个典型的算法研究员每天要经历数十次甚至上百次假设检验:调整注意力机制头数、改变激活函数公式、测试新的归一化方法、排查梯度消失或张量形状不匹配。在这一工作模式下,开发者的“迭代耗时”决定了科研产出的天花板。
1. 消除繁重的静态类型与编译等待
若使用 C++ 或 Rust 编写模型逻辑,每次微调全连接层的输出维度、插入一个残差连接,都需要重新调用编译器进行编译链接。在大工程中,一次编译可能需要几十秒甚至数分钟。而 Python 作为动态解释语言,支持即写即跑,开发者甚至可以在交互式终端中动态注入新函数。
2. “可执行的伪代码”与更低的认知负荷
学术界与工业界的人工智能先驱多为应用数学、理论物理、神经科学或统计学背景。他们擅长的是矩阵变换、概率论与信息论,而不是管理内存指针、内存对齐或解决模板元编程的编译报错。Python 简洁直观的语法特性,使算法研究员能够将思维注意力全部放在数学公式本身上。
以实现一个多头注意力机制(Multi-Head Attention)的核心缩放点积公式为例:
# 缩放点积注意力:Attention(Q, K, V) = softmax(Q * K^T / sqrt(d_k)) * V
import torch
import torch.nn.functional as F

def scaled_dot_product_attention(Q, K, V, mask=None):
    d_k = Q.size(-1)
    scores = torch.matmul(Q, K.transpose(-2, -1)) / (d_k ** 0.5)
    if mask is not None:
        scores = scores.masked_fill(mask == 0, -1e9)
    weights = F.softmax(scores, dim=-1)
    return torch.matmul(weights, V)
这几行 Python 代码几乎与原始论文中的数学公式一一对应。高维矩阵转置、广播机制(Broadcasting)、矩阵批处理乘法与掩码操作均在一目了然的语句中完成,无需手动书写多层嵌套的 for 循环,也无需手动分配与回收堆内存。
三、滚雪球式的生态壁垒:从张量标准到大模型生态
开发效率决定了最初的吸引力,而生态库的协同网络则形成了坚不可摧的“护城河”。如果一种编程语言仅仅是语法优雅,但缺乏配套的基础设施,它依然无法成为行业标准。
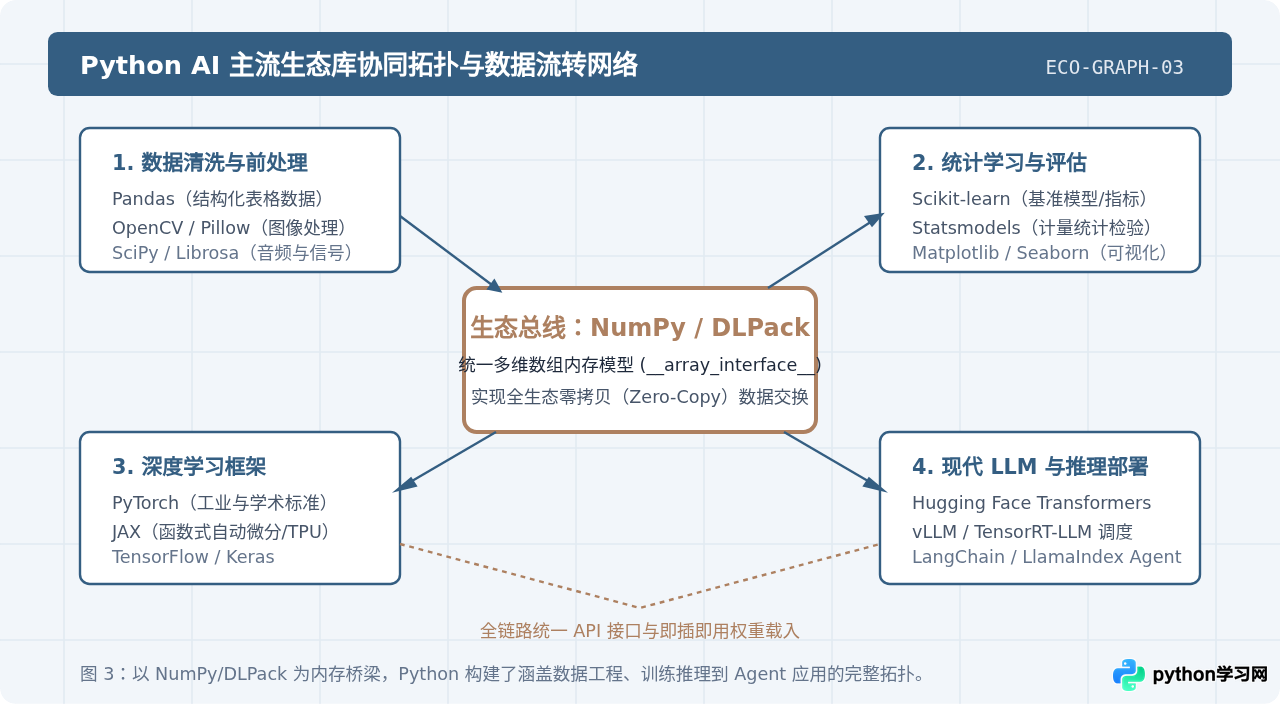
Python 在人工智能领域的生态并非各个孤岛,而是一套高度协同、紧密啮合的数据处理与模型研发流水线:
统一的数组标准:NumPy 奠定的基石
Python AI 生态能够繁荣,最重要的功臣是 NumPy 及其定义的多维数组对象(ndarray)。NumPy 在底层通过 C 连续内存块管理数据,并向 Python 暴露了标准的数组接口(__array_interface__)。
由于所有数据处理库(OpenCV、Pandas、SciPy)与深度学习框架(PyTorch、TensorFlow、JAX)均遵循这套内存接口,数据在这些原本完全独立的库之间流转时,无需任何内存复制(Zero-Copy)。你可以用 OpenCV 读取一张图片并进行高斯滤波,紧接着直接通过 torch.from_numpy(img) 将指针交给 PyTorch 转化为 GPU 张量,中间只有毫秒级的元数据指针传递。这种无缝互操作性在其他语言中极难重现。
四、为什么不是其他语言:主流竞争者的边界与定位
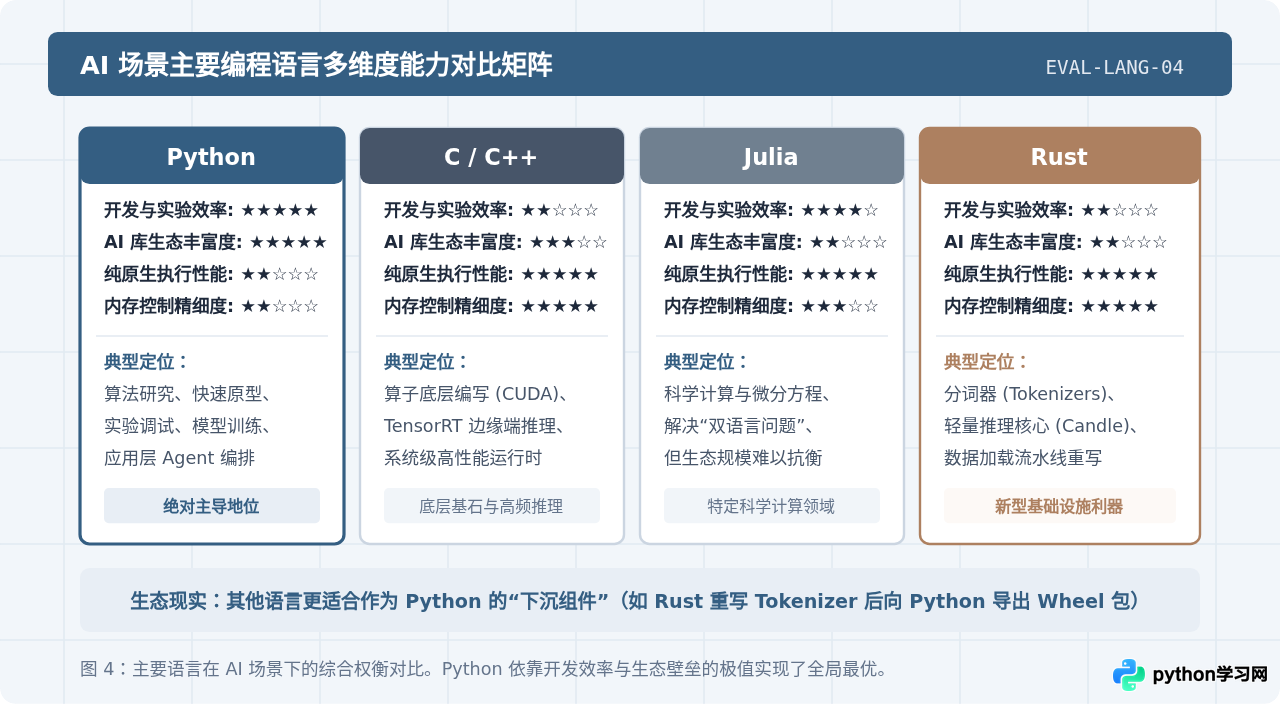
除了 Python,计算机领域还有许多优秀的编程语言,如 C++、Julia、Rust 等。它们在某些性能指标上甚至远胜 Python,但为何无法颠覆 Python 在 AI 领域的首选地位?
1. C/C++:强大的底层,高昂的原型代价
C++ 在高性能推理(如 TensorRT、ONNX Runtime)与游戏 AI/机器人底层控制中不可或缺。但若使用 C++ 搭建前沿研究原型,开发者需要耗费海量精力处理模板推导、内存生命周期以及跨平台第三方依赖库的编译构建问题,极易拖慢算法迭代进度。
2. Julia:理念先进但面临“冷启动”困境
Julia 凭借其多重分派(Multiple Dispatch)和即时编译(JIT)机制,成功解决了“双语言问题”(无需混合 C++ 即可同时获得易写性与原生性能)。然而,Julia 出现的时间较晚,此时 Python 已经在深度学习生态建立了深厚的马太效应。重新用 Julia 编写成千上万个高质量的预训练模型、算子库以及数据分析工具需要庞大的人力投入,目前其应用主要集中在偏理论的科学计算与微分方程领域。
3. Rust:现代系统级补充,而非替代
近年来,Rust 在 AI 基础设施中异军突起,例如 Hugging Face 的核心分词库 tokenizers 以及极速数据加载组件均由 Rust 编写。但有趣的是,Rust 在 AI 领域的成功恰恰印证了 Python 的主导地位——Rust 编写的组件最终都会通过 pyo3 封装为 Python 原生扩展包,继续供 Python 用户无缝调用。
五、现代工业落地范式:训练与推理的最佳实践分工
在严肃的工业生产环境中,人工智能系统的最佳工程实践通常遵循“Python 负责研发探索,专用引擎负责落地部署”的标准路径:
| 业务阶段 | 主要采用技术 | 选用理由与实践目标 |
|---|---|---|
| 数据清洗与特征工程 | Python (Polars, Pandas, DuckDB, PySpark) | 快速处理多源异构数据,具备丰富的格式解析器与探索性数据可视化支持。 |
| 模型架构设计与实验训练 | Python (PyTorch, DeepSpeed, JAX) | 极速验证学术假设,利用分布式训练框架驱动万卡 GPU 集群,调试方便。 |
| 计算图静态化与模型导出 | ONNX, TorchScript, TensorRT Engine | 剥离 Python 运行时依赖,将动态图转换为高度优化的静态计算拓扑结构。 |
| 边缘端或超低延迟线上推理 | C++ / Rust / TensorRT / Triton Inference Server | 将静态权重加载至纯原生环境执行,实现微秒级延迟响应与极致的内存并发控制。 |
| 上层 Agent 与工作流应用编排 | Python (FastAPI, LangChain, AutoGen) | 由于大模型应用更关注多工具联动与异步 API 调用,Python 再次作为首选控制胶水。 |
六、总结
人工智能选择 Python,是计算机工业在“人本效率”(Human Productivity)与“机器效率”(Machine Efficiency)之间长期权衡演进的必然结果。
通过精妙的双层解耦架构,Python 成功摆脱了纯解释型语言的性能枷锁,让科学家负责用直观的代码表达数学思考,让底层硬件指令负责高并发计算。只要算法探索依然高度依赖实验驱动,只要人类工程师的开发时间依然比算力时间更宝贵,Python 构筑起的生态重力与开发效率优势就无法被轻易撼动。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















