


RAGFlow vs Dify vs LangChain:开源RAG框架选型对比

在构建基于大语言模型(LLM)的知识库问答系统时,检索增强生成(RAG)已成为标准架构。然而,面对市场上众多的开源工具,技术团队往往陷入选择困难:是选择专注于深度文档解析的 RAGFlow,还是偏向低代码应用编排的 Dify,亦或是完全代码控制的 LangChain?
这三个工具并非简单的替代关系,而是分别解决了 RAG 链路中不同阶段的痛点。理解它们的核心定位差异,是做出正确选型的前提。
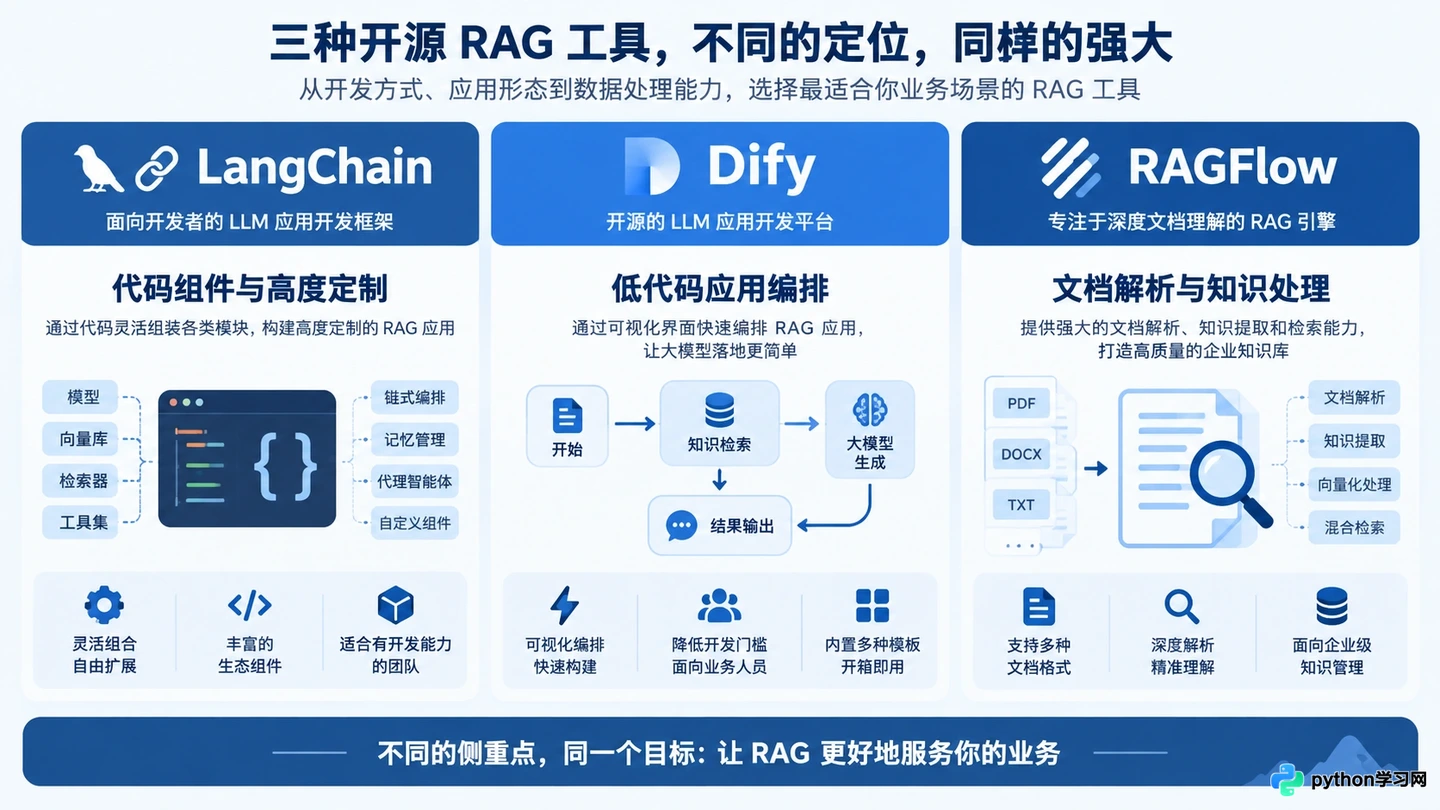
三者核心定位对比:LangChain 侧重代码组件,Dify 侧重应用编排,RAGFlow 侧重数据解析
关于核心定位与设计哲学
LangChain 是一个用于开发由语言模型驱动的应用程序的框架。它的核心优势在于“原子化”和“灵活性”。它提供了大量的组件(Chains, Agents, Tools),让开发者可以像搭积木一样构建复杂的逻辑。但这也意味着,你需要自己处理数据清洗、向量存储连接、检索策略优化等大量底层细节。它更像是一个 SDK,而非一个开箱即用的产品。
Dify 则定位为 LLM 应用开发平台。它试图在“易用性”和“灵活性”之间找到平衡。通过可视化的工作流编排,Dify 让非资深开发者也能快速搭建 RAG 应用。它内置了常见的 RAG 流程,包括文件上传、分段、索引和检索。Dify 的重点在于“应用交付”,它关注的是如何快速将一个想法变成可被调用的 API 或 Web 界面。
RAGFlow 的出现则是为了解决 RAG 落地中最头疼的问题:“垃圾进,垃圾出”。许多 RAG 效果不佳,并非模型不够强,而是原始文档(如 PDF、表格、扫描件)解析质量太差。RAGFlow 的核心竞争力在于其强大的深度文档理解能力,特别是基于视觉模型的布局分析,能够精准还原复杂排版、表格和公式。它的定位更偏向于“高质量数据引擎”,为上层应用提供纯净的知识片段。
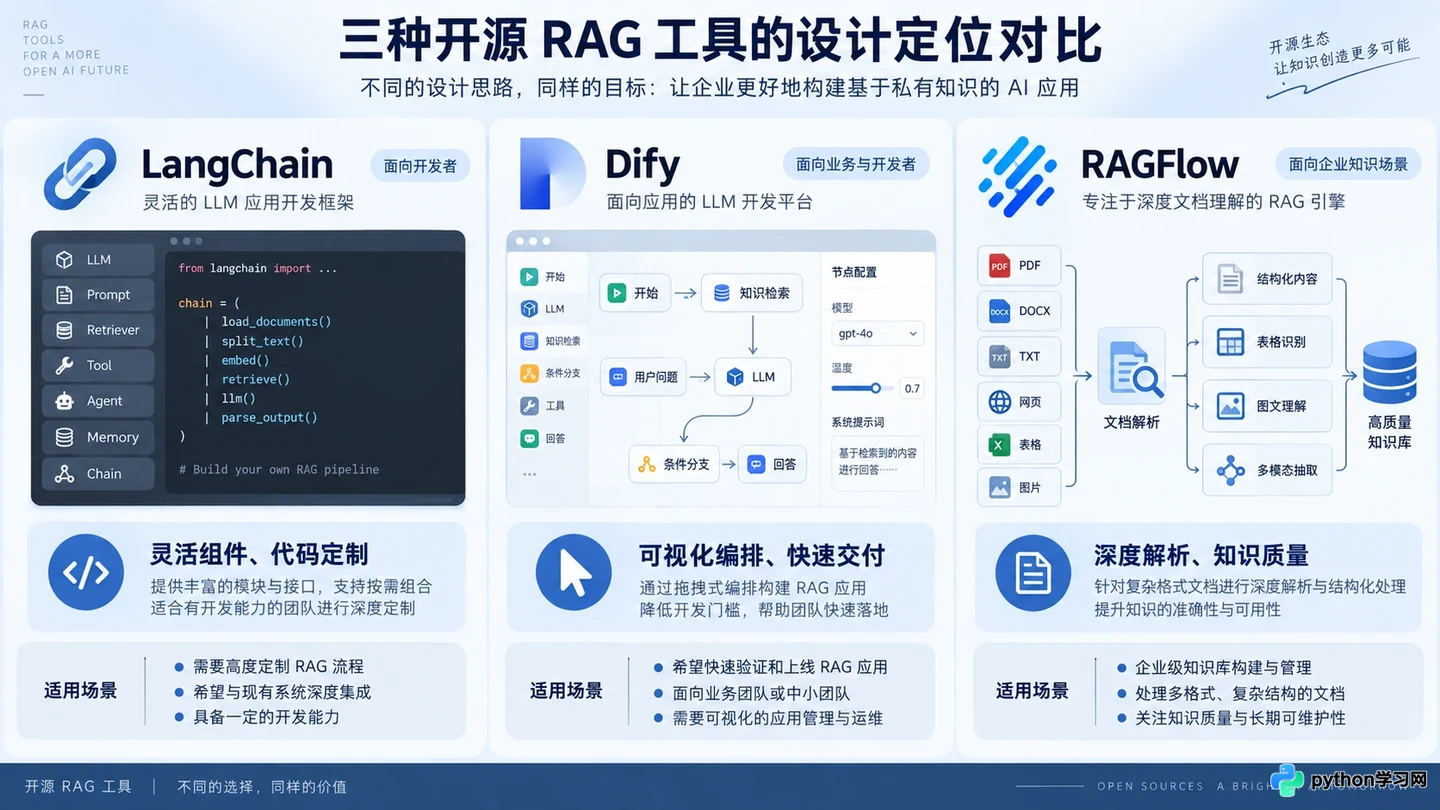
关于核心定位与设计哲学
关于数据处理与解析能力
在 RAG 系统中,数据预处理的质量直接决定了检索的上限。这是三者差异最明显的地方。
LangChain 本身不提供原生的高级文档解析器,它通常依赖第三方库(如 PyPDF, Unstructured, LlamaParse 等)。开发者需要自行集成这些库,并编写代码处理解析后的清洗逻辑。对于简单的纯文本或结构良好的 Markdown,LangChain 处理起来很轻松;但面对扫描版 PDF、多栏排版或复杂表格时,配置成本极高且效果难以保证。
Dify 内置了标准的文件解析流程,支持常见格式(PDF, Word, TXT, Markdown 等)。它提供了自动分段和混合检索功能,对大多数常规企业文档有不错的默认支持。用户可以通过界面调整分段大小和重叠率,但对于极度复杂的版面(如跨页表格、图文混排的科学文献),Dify 的解析精度有限,主要依赖通用的文本提取逻辑。
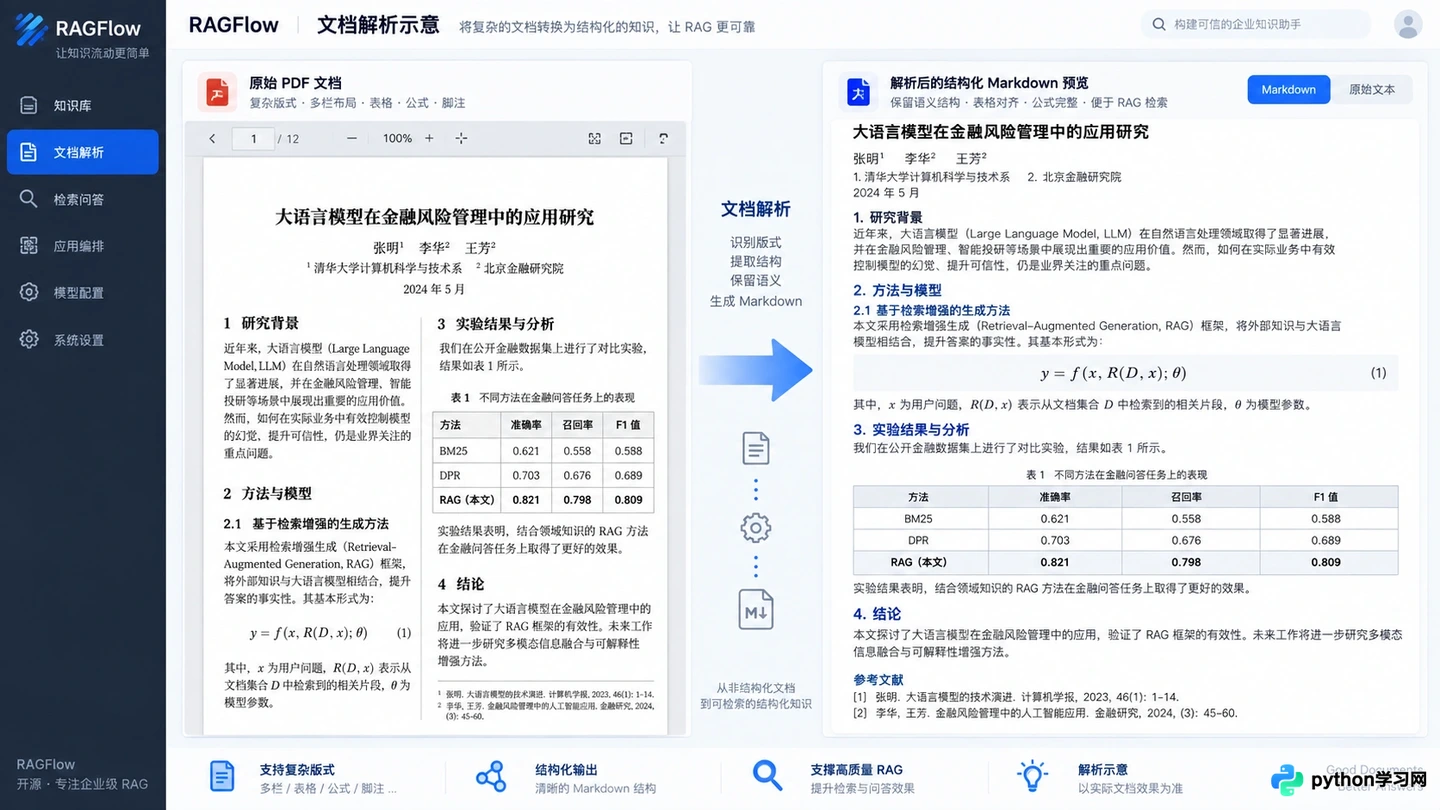
RAGFlow 对复杂表格和排版的精准还原能力
RAGFlow 在此方面具有显著优势。它集成了深度文档理解模型,能够识别文档的视觉布局。这意味着它可以准确区分标题、正文、侧边栏、脚注,并能将复杂的表格转换为结构化的 Markdown 或 HTML 格式,保留行列关系。对于金融研报、法律合同、学术论文等对格式敏感的场景,RAGFlow 能大幅减少因解析错误导致的幻觉。它还支持对解析结果进行人工校对和调整,确保入库知识的准确性。
关于工作流编排与开发体验
当数据准备就绪后,如何构建检索和生成的逻辑?
LangChain 采用代码优先(Code-First)的方式。开发者使用 Python 或 JavaScript 编写逻辑。这种方式上限极高,你可以实现任何自定义的检索策略(如 HyDE, Step-back Prompting)、重排序算法或代理逻辑。但缺点是学习曲线陡峭,调试复杂,且随着逻辑变复杂,代码维护成本会迅速上升。它适合拥有强大工程团队、需要高度定制化的项目。
Dify 采用可视化编排(Visual-Orchestration)。用户通过拖拽节点来构建工作流,例如“开始 -> 知识库检索 -> LLM 生成 -> 结束”。它屏蔽了底层的向量数据库交互细节,提供了直观的调试界面。Dify 还支持插件扩展和模型切换,非常适合快速原型验证和中后台业务系统的集成。对于大多数不需要极致定制的企业级应用,Dify 的开发效率最高。
RAGFlow 目前也提供了工作流编排功能,但其重心依然在前端的数据处理和管理上。它的界面更侧重于知识库的管理、文件解析状态的监控以及切片结果的预览。在检索策略上,RAGFlow 提供了多种预设模板(如通用、学术、法律等),针对不同文档类型优化了检索参数。虽然它也支持一定的逻辑编排,但在复杂 Agent 构建和外部工具调用方面,目前不如 Dify 成熟和丰富。
关于部署运维与生态集成
在生产环境中,工具的易部署性和生态兼容性至关重要。
LangChain 作为一个库,没有独立的“部署”概念,它随你的应用一起部署。你需要自行解决向量数据库(如 Milvus, Chroma, Pinecone)的搭建和维护,以及 LLM API 的管理。生态极其丰富,几乎兼容所有主流的 LLM 和向量库,但集成工作需要自己动手。
Dify 提供了完整的后端服务,支持 Docker 一键部署。它内置了对多种向量数据库的支持,并提供了统一的管理界面来监控 API 调用、日志和用户反馈。Dify 的社区活跃,插件市场丰富,可以轻松集成微信、飞书等IM工具。对于希望快速上线独立 RAG 应用的团队,Dify 的运维负担最小。
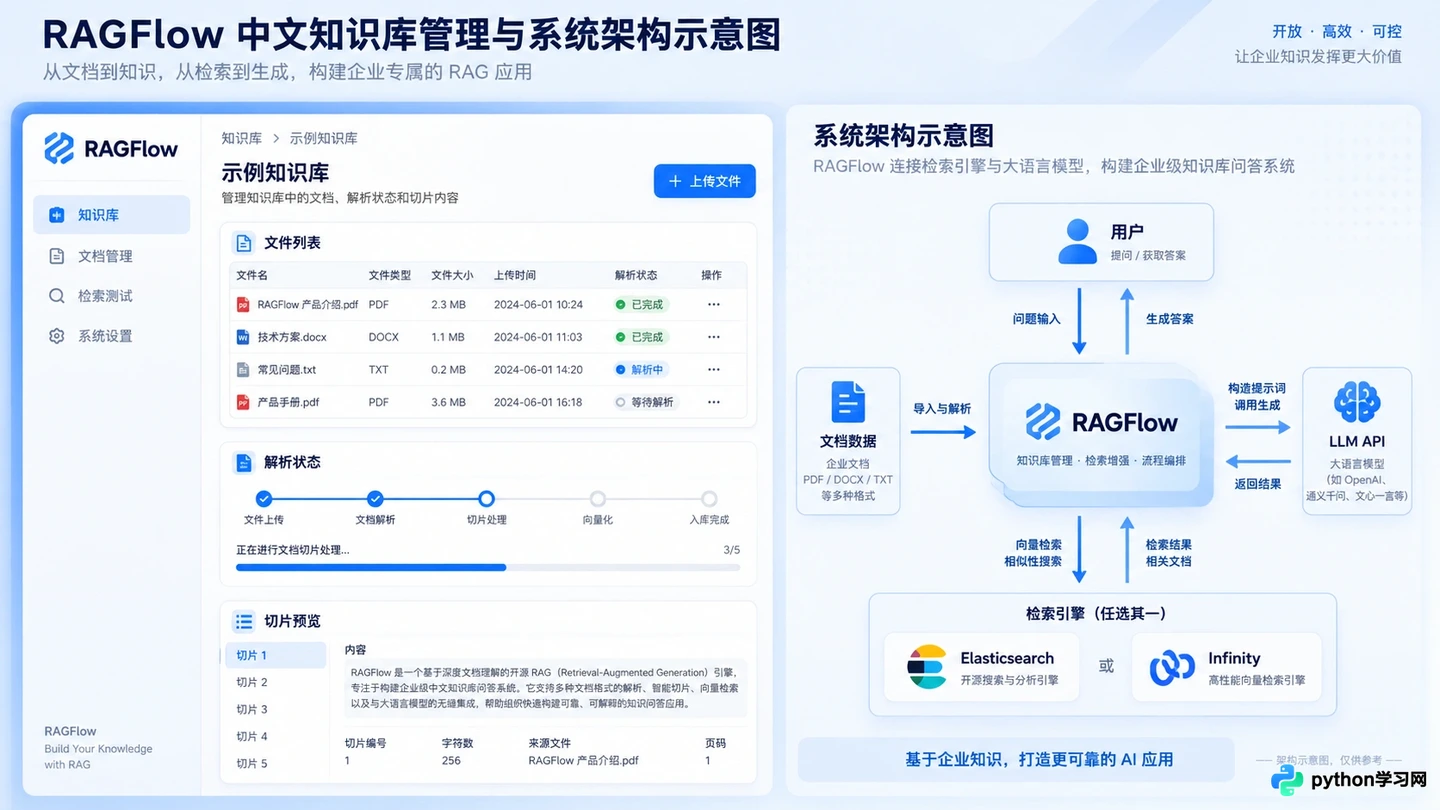
RAGFlow 的知识库管理界面及底层依赖
RAGFlow 同样支持 Docker 部署,其架构依赖于 Elasticsearch 或 Infinity 作为向量/全文检索引擎。由于涉及深度文档理解模型,RAGFlow 对硬件资源(特别是 GPU)有一定要求。它在生态集成上相对专注,主要聚焦于知识库本身的能力输出,通常作为 Dify 或其他应用平台的数据源后端存在,而不是直接面向最终用户提供完整的聊天界面(尽管它也具备基本的对话功能)。
关于选型建议与场景匹配
没有最好的工具,只有最适合的场景。以下是基于实际项目需求的选型指引:
-
如果你的核心痛点是文档解析质量,尤其是处理大量 PDF、扫描件、复杂表格,且对检索精度要求极高,RAGFlow 是首选。它可以作为高质量的知识底座,甚至可以与 Dify 结合使用(用 RAGFlow 做解析和检索,Dify 做应用编排)。
-
如果你需要快速构建一个完整的 LLM 应用,如企业内部客服、智能助手,且团队缺乏深厚的 AI 工程背景,Dify 是最佳选择。它提供了从数据导入到应用发布的全链路支持,开箱即用,维护成本低。
-
如果你是AI 原生应用开发者,需要实现非常复杂的逻辑、自定义的 Agent 行为,或者需要将 LLM 能力深度嵌入到现有的复杂软件架构中,LangChain 依然是不可替代的基础设施。它赋予了你最大的控制权,但也要求你承担最多的开发工作。
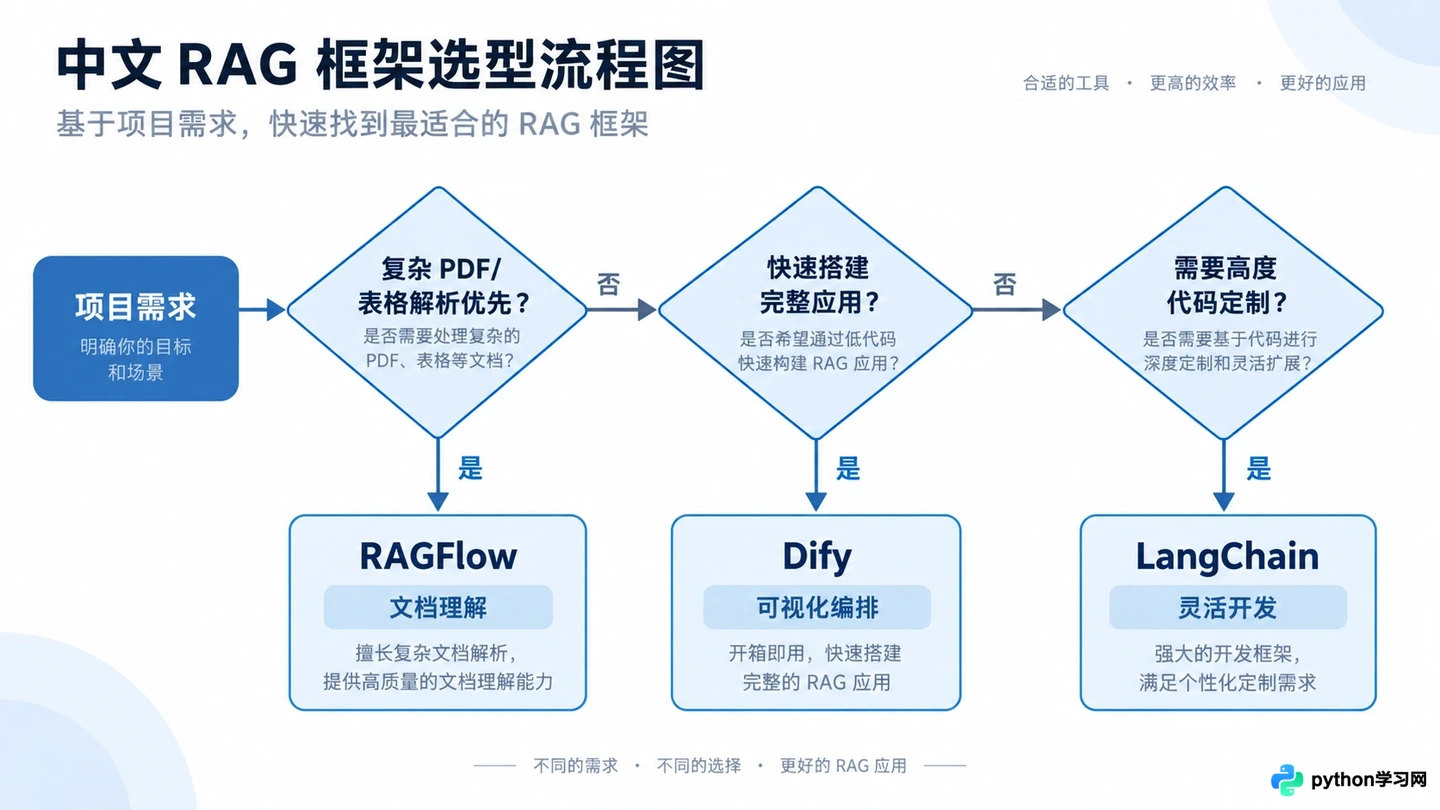
基于项目需求的选型决策路径
在实际的大型项目中,组合使用往往比单选更有效。例如,使用 RAGFlow 进行高精度的文档解析和切片,将处理好的数据存入向量库,再通过 Dify 编排检索和生成工作流,最后通过 LangChain 编写特定的自定义工具或代理逻辑。理解各工具的边界,才能构建出稳健高效的 RAG 系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















