


怎么使用conda安装pandas并管理环境依赖

在数据处理和科学计算工作中,使用 conda 安装 pandas 不仅仅是执行一条下载命令,更核心的价值在于借助 conda 建立相互独立的虚拟环境,确保 pandas 及其底层的 C/Fortran 编译依赖(如 NumPy、OpenBLAS)版本协调一致。本文将系统讲解如何从零创建一个纯净的环境、正确安装与验证 pandas,并通过配置文件实现依赖的精确固化与跨平台迁移。
一、准备工作:为什么要在专属环境中安装 pandas
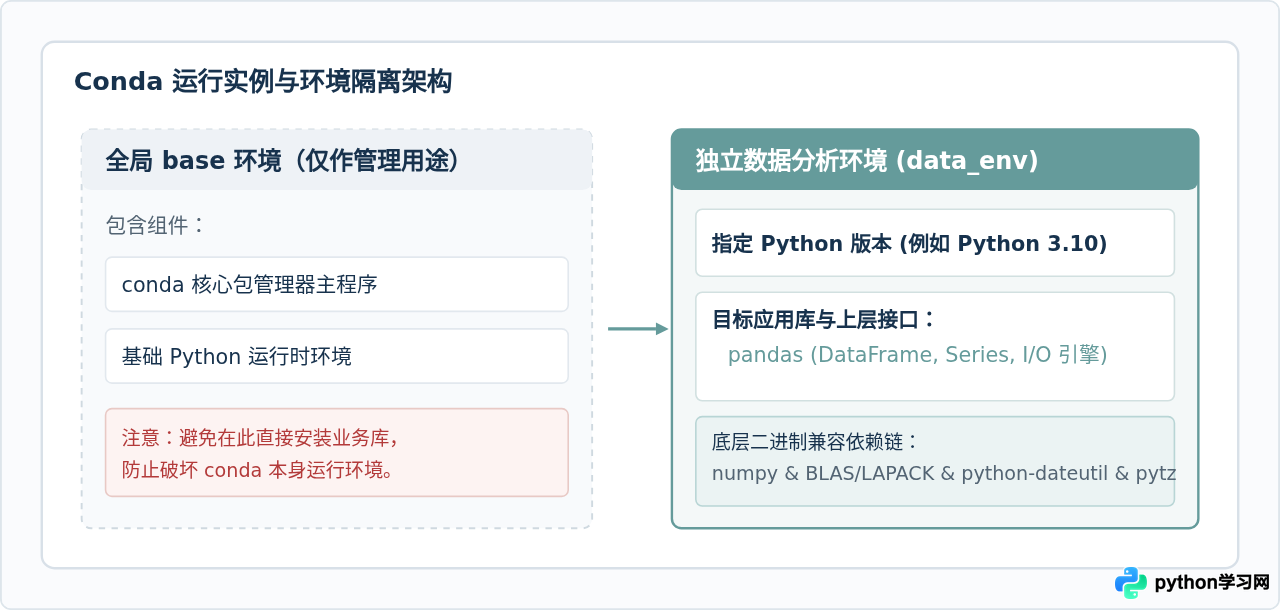
很多初学者容易直接在 conda 的默认 base 环境中安装软件包,这通常是后续依赖冲突的主要诱因。pandas 依赖于一系列底层二进制计算库,随着项目增加,不同工具对底层库版本的诉求往往不一致。直接在全局环境叠加安装,极易导致底层符号链接被覆盖,甚至损坏 conda 本身的运行环境。
标准做法是为每个数据项目分配一个独立的虚拟环境。独立环境具备明确的 Python 版本以及完全隔离的 site-packages 目录,既保障了项目的可复现性,也让后续的环境清理与迁移变得安全轻量。
二、核心步骤:创建环境并安装 pandas
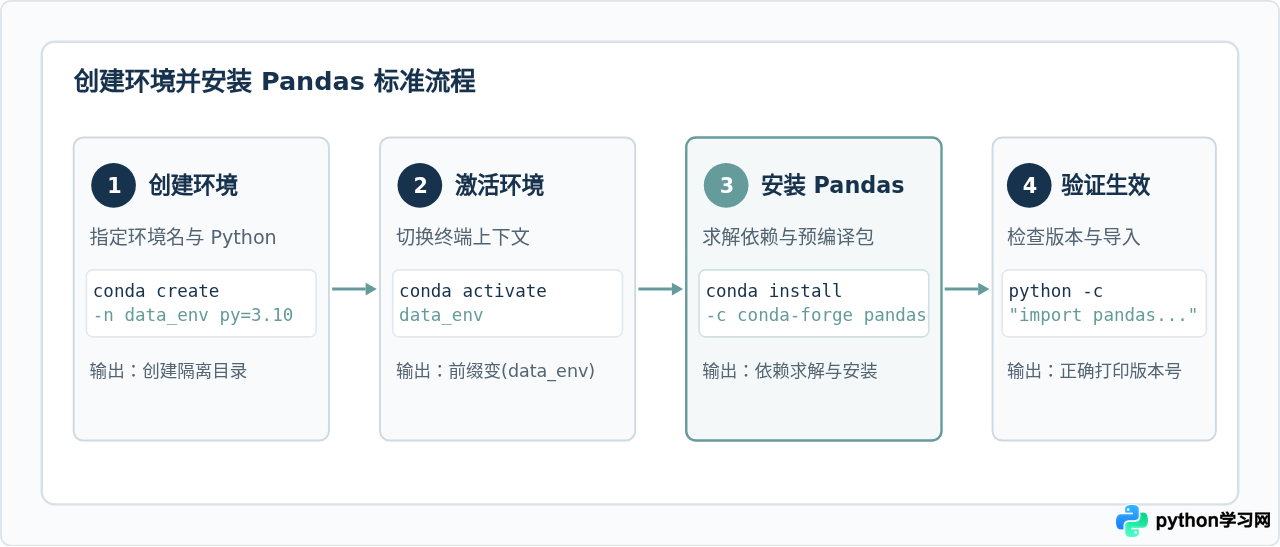
安装与管理过程分为四个标准动作:创建环境、激活环境、执行安装与验证运行。整个过程在操作系统的终端(Windows 推荐使用 Anaconda Prompt 或 PowerShell,macOS 与 Linux 使用标准 Terminal)中完成。
步骤 1:创建专属虚拟环境
执行 conda create 命令,使用 -n 参数指定新环境名称(此处以 data_env 为例),并明确声明所需的 Python 主版本。显式指定 Python 版本能够避免安装默认版本与特定算法包发生不兼容。
conda create -n data_env python=3.10 -y终端会输出准备安装的底层基础包列表,参数 -y 表示自动确认执行。
步骤 2:激活新创建的环境
环境创建完成后,必须显式激活该环境。激活环境会将当前终端的 PATH 变量重定向到新环境的目录结构下。
conda activate data_env激活成功后,终端提示符前缀会由 (base) 变为 (data_env),这表明后续所有包操作均严格局限在此环境中。
步骤 3:使用 conda 安装 pandas
在当前激活的环境中执行安装命令。建议优先使用开源社区广泛维护且更新及时的 conda-forge 镜像频道:
conda install -c conda-forge pandas -y如果项目对 pandas 版本有硬性要求(例如需要特定 2.2 系列版本),可以直接在命令中附加版本号约束:
conda install -c conda-forge pandas=2.2.0 -y执行该命令时,conda 会自动启动求解器(Solver),计算 pandas 依赖的所有下游构件(如 numpy、pytz、tzdata 等),确保下载的各个预编译包在 ABI 与 C 运行时级别完全兼容。
步骤 4:验证安装结果与运行时信息
安装完成后,通过一行简短的 Python 命令检测模块是否可正常加载,并打印已安装的版本号:
python -c "import pandas as pd; print('Pandas版本:', pd.__version__); print('NumPy版本:', pd.np.__version__ if hasattr(pd, 'np') else '已独立解耦')"[示例输出]
Pandas版本: 2.2.0
已独立解耦
只要能正常输出版本号且没有报错,即证明 pandas 及其核心依赖已在当前环境中正确就绪。
三、依赖管理:导出、版本固化与跨平台迁移
单台设备上完成安装只是第一步。在团队协作或将代码部署至生产服务器时,必须确保目标机器拥有完全一致的运行环境。Conda 提供了通过 YAML 配置文件描述环境依赖的完整机制。
1. 导出轻量级环境配置文件
如果直接执行常规的 conda env export,导出的文件中会包含具体操作系统的构建散列值(如 mkl_h6a684a1_0),这会导致导出的文件在 macOS、Linux 与 Windows 之间无法通用。推荐添加 --no-builds 参数导出跨平台通用的环境配置清单:
conda env export --no-builds > environment.yml导出的 environment.yml 结构清晰可读,样例如下:
name: data_env
channels:
  - conda-forge
  - defaults
dependencies:
  - python=3.10
  - pandas=2.2.0
  - numpy=1.26.4
  - pip:
    # 如有 pip 专属包则放置于此处
2. 在新设备上一键重建环境
当协作者获取到 environment.yml 文件后,只需在终端运行以下命令,conda 就会按照文件中的依赖说明,自动拉取对应平台的兼容构件并完成配置:
conda env create -f environment.yml3. 查看与更新现有依赖
日常维护中,可以通过以下命令快速检查当前环境中已安装的依赖列表及来源频道:
# 查看当前环境内所有包名与对应版本
conda list

# 仅筛选查看 pandas 相关包
conda list pandas

# 升级 pandas 至当前依赖允许的最新版本
conda update pandas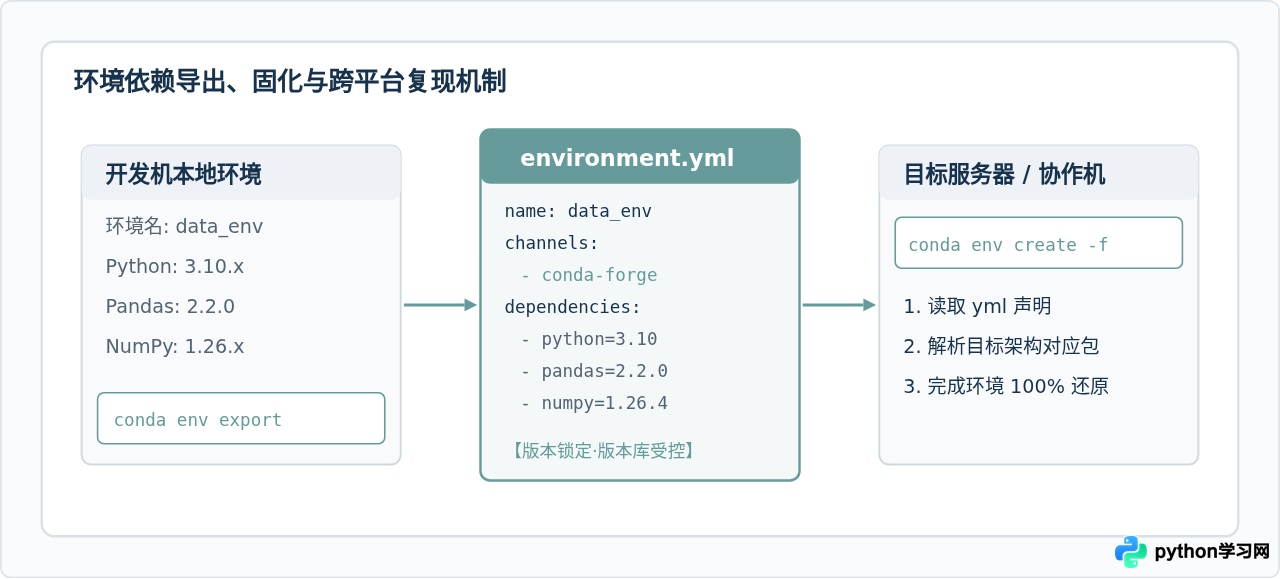
四、避坑指南:源配置、混用规则与环境清理
在使用 conda 管理 pandas 依赖时,几个细节对维护长期稳定的环境至关重要:
Anaconda 默认源(defaults)与社区源(conda-forge)中的编译链和时间戳偶有差异。混合无序安装容易引发漫长的求解冲突(Solving Environment 假死)。推荐设置全局严格频道优先级:
conda config --set channel_priority strict
conda config --add channels conda-forge当某些特定数据分析扩展库在 conda 频道中未提供时,才需使用 pip 安装。混用时应遵循“先 conda 后 pip”原则:先使用
conda install 将 Python、pandas、numpy 等核心底层基础库全部就绪;最后再使用 pip install 安装纯 Python 补充包。千万不要在使用 pip 安装后再回头运行 conda install,这会覆盖已记录的元数据导致依赖视图断裂。
当测试或特定阶段项目结束时,应及时退出并清理环境以释放磁盘空间:
# 退出当前激活的环境回到 base
conda deactivate

# 彻底移除整个虚拟环境及其包含的所有包
conda env remove -n data_env -y

# 清理未使用的缓存包压缩包
conda clean -a -y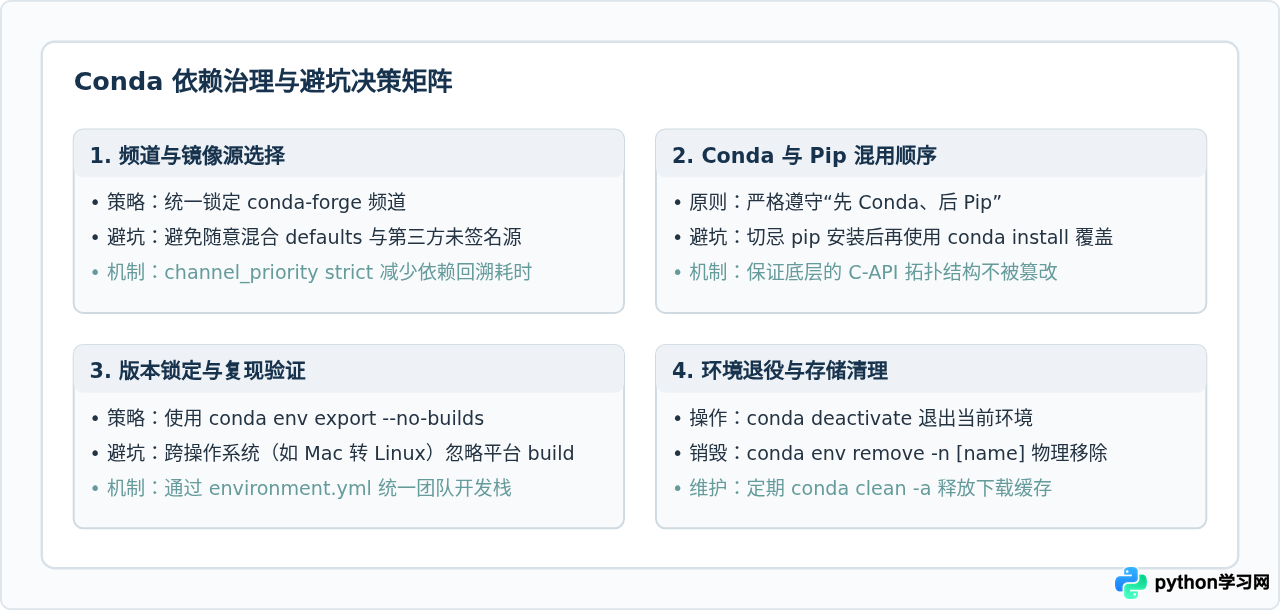
五、总结
通过 conda 安装 pandas 并管理依赖,最稳健的工作流可以归纳为:“隔离在先、统一渠道、按需锁定、安全退出”。只要坚持在独立的虚拟环境中操作,并善用 environment.yml 对依赖版本进行声明,就能彻底摆脱“在我的电脑上能跑,换台机器就报错”的困境,为后续的数据分析与建模构建可靠的基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















