


RAG知识库怎么处理PDF和Word文档:解析工具与预处理难点

在构建检索增强生成(RAG)系统时,最耗时且容易出错的环节往往不是模型微调,而是如何将企业内部的PDF报告、Word合同等非结构化文档转化为机器可理解的高质量文本。如果直接粗暴地提取文字,大量的页眉页脚、乱码符号和断裂的表格会严重干扰向量检索的准确性,导致大模型回答出现幻觉或遗漏关键信息。本教程将演示一套标准化的文档预处理流程,确保入库数据的清洁度与语义连贯性。
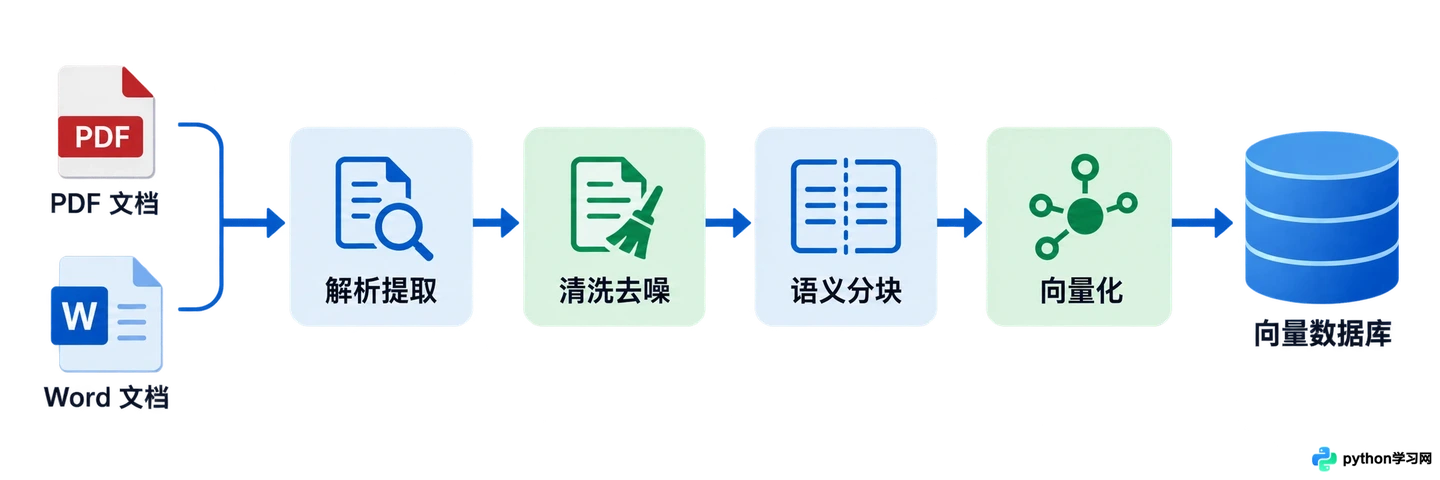
RAG知识库文档处理全流程:从原始文件到向量索引
非结构化数据的核心挑战在于“版式”与“内容”的分离。PDF本质上是打印指令的集合,缺乏逻辑结构;Word虽然包含样式标签,但嵌套复杂。预处理的目标是还原文档的逻辑层级,剔除视觉噪声,并将长文本切分为适合嵌入模型处理的语义块。
开始前,请确保已安装 Python 环境,并准备好以下基础库:PyMuPDF (fitz) 用于高效PDF解析,python-docx 用于Word处理,以及 langchain 或 llama-index 用于后续的分块与向量化。对于包含复杂表格的文档,建议额外安装 pdfplumber 或 unstructured 库以获得更好的布局识别能力。
1. PDF文档的深度解析与噪声清洗
PDF解析不能仅依赖简单的文本复制,必须处理多栏排版和隐藏字符。使用 PyMuPDF 可以按页提取文本,但更推荐结合布局分析工具。
首先,加载PDF文件并遍历每一页。不要一次性读取整个文件,以免内存溢出。对于每一页,提取文本后需立即执行正则清洗,去除不可见的控制字符和多余的空行。
import fitz  # PyMuPDF
import re

def clean_pdf_text(pdf_path):
    doc = fitz.open(pdf_path)
    full_text = []
    for page in doc:
        text = page.get_text()
        # 去除多余空白和特殊控制字符
        text = re.sub(r'\s+', ' ', text)
        text = re.sub(r'[\x00-\x08\x0b\x0c\x0e-\x1f]', '', text)
        if text.strip():
            full_text.append(text)
    return "\n".join(full_text)
关键的难点在于页眉页脚的去除。大多数商业文档的页眉页脚位置相对固定。可以通过检测页面顶部和底部特定坐标区域内的文本,或者利用字体大小差异(页眉通常字号较小)来识别并剔除这些重复噪声。如果页眉包含页码,务必使用正则表达式 r'\d+\s*/\s*\d+' 进行匹配删除,防止页码打断句子语义。
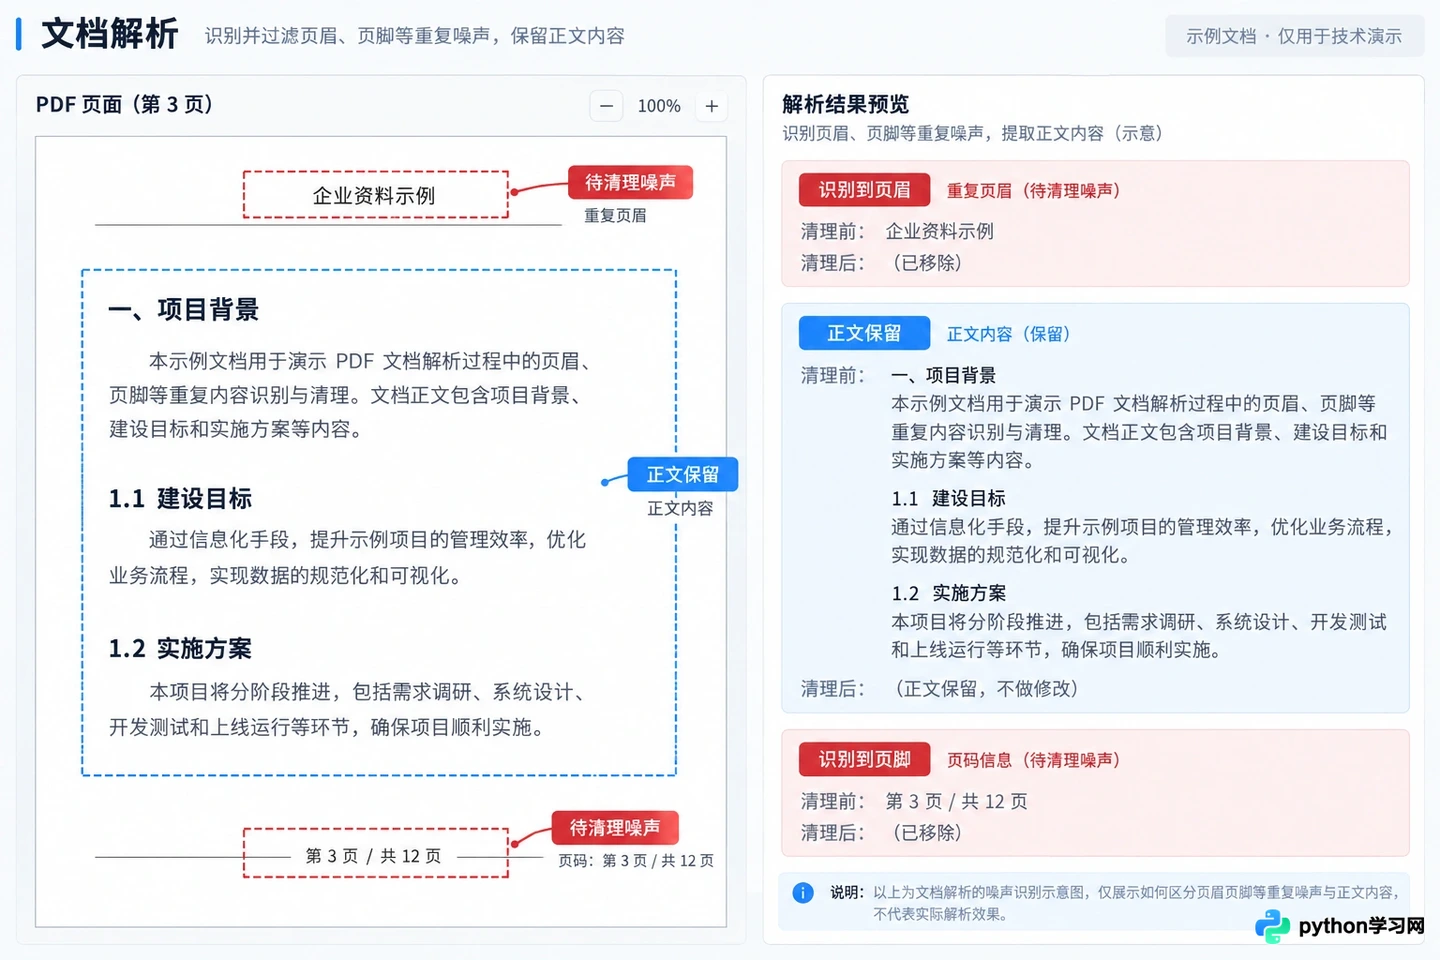
PDF解析中识别并去除页眉页脚噪声
对于包含表格的PDF,普通文本提取会导致列数据混杂。此时应切换至 pdfplumber,它能识别表格边界。提取表格时,将其转换为 Markdown 格式或 CSV 字符串,再插入到主文本流的对应位置,保持上下文的空间关系。
2. Word文档的结构化提取
Word文档的优势在于保留了段落样式和层级信息。使用 python-docx 库时,不应只提取 paragraph.text,而应同时读取 paragraph.style.name。
遍历文档中的所有段落,判断其样式是否为“标题1”、“标题2”等。如果是标题,将其作为后续分块的天然分隔符或元数据标记;如果是正文,则累积文本。这种基于样式的提取方式能有效还原文档的大纲结构,比纯文本切割更具语义完整性。
注意处理文档中的图片和嵌入式对象。对于RAG系统,除非具备多模态处理能力,否则应跳过图片占位符,或在元数据中记录“此处有图表”,避免插入无意义的二进制乱码。同时,检查超链接字段,若链接指向内部锚点可保留,外部链接可视需求决定是否转为纯文本描述。
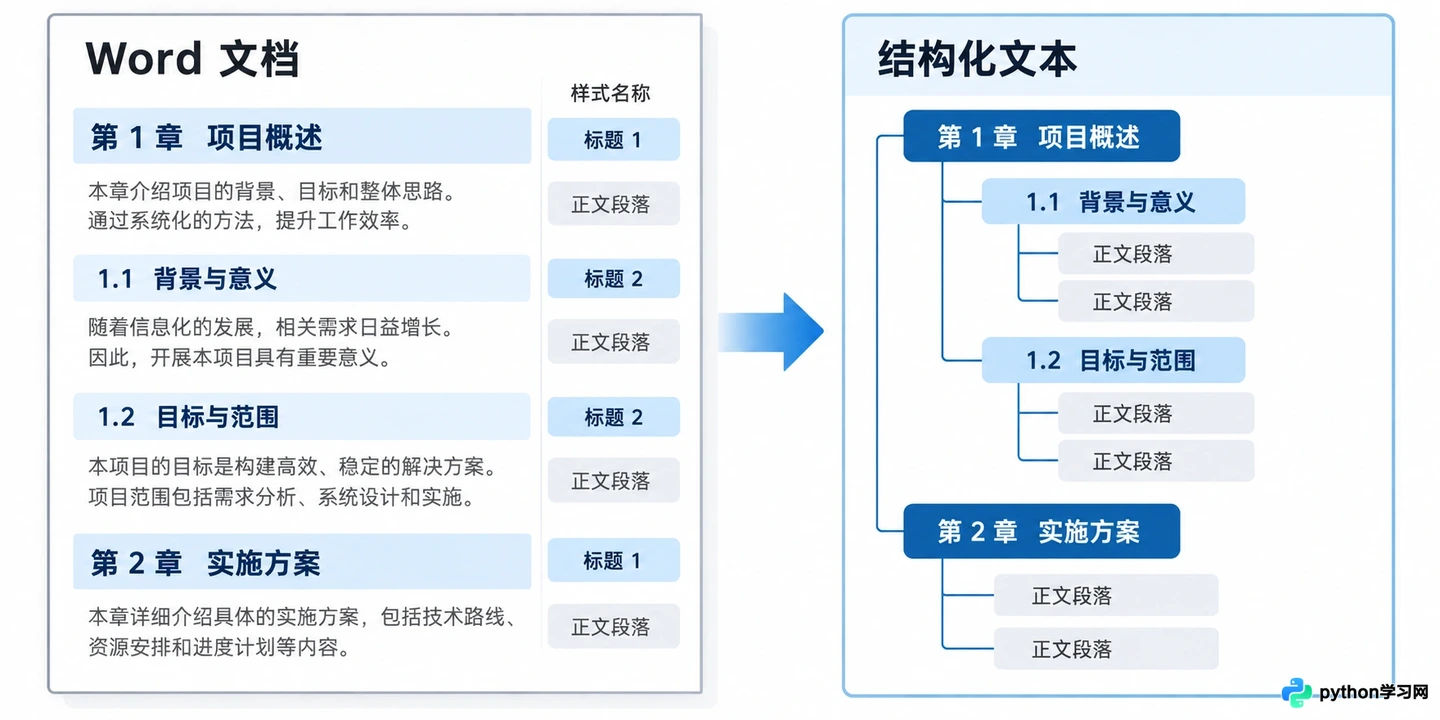
基于Word样式标签的结构化文本提取
3. 统一编码与特殊字符处理
不同来源的文档可能存在编码不一致问题,尤其是老旧的Word文档或扫描版PDF。在合并文本前,强制统一使用 UTF-8 编码。
处理中文文档时,常遇到全角标点与半角标点混用的情况。建议建立统一的标点映射表,将全角逗号、句号转换为半角,或反之,取决于后续分词工具的要求。此外,移除所有非打印字符,如软回车(^l)和手动分页符,这些字符在向量空间中毫无意义,却会割裂语义。
对于OCR识别后的PDF,常出现形近字错误(如“1”与“l”,“0”与“O”)。虽然完全自动校正很难,但可以通过词典匹配进行初步过滤。如果置信度低,建议在预处理阶段标记该段落,降低其在检索中的权重,而不是直接丢弃。
4. 智能分块与元数据增强
清洗后的文本需要切分为小块(Chunks)才能存入向量数据库。固定的字符数切割(如每500字一切)往往会切断句子或段落逻辑。推荐使用基于语义的分块策略。
利用 LangChain 的 RecursiveCharacterTextSplitter,设置分隔符优先级为 ["\n\n", "\n", " ", ""]。这样分割器会先尝试在段落间切割,其次在句子间,最后才在字符间。设置 chunk_size 为 500-1000 字符,chunk_overlap 为 100-200 字符,重叠部分能确保上下文信息的连贯性,避免关键信息被截断在两个块的边缘。
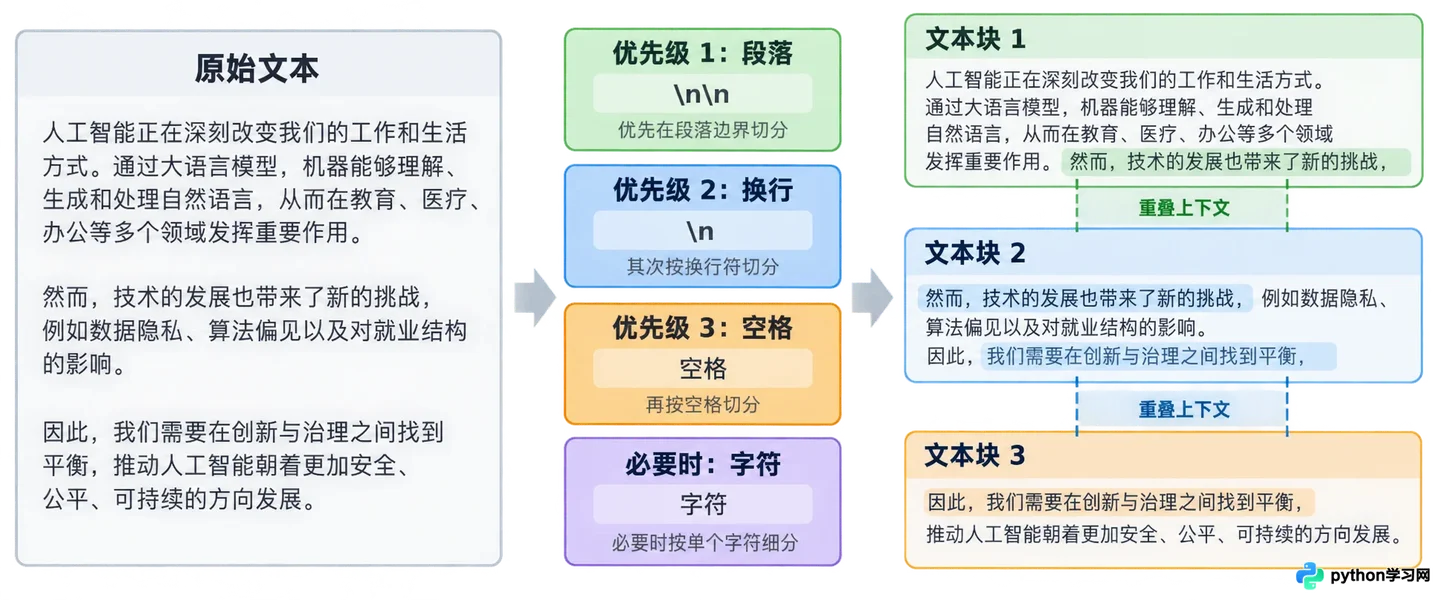
RecursiveCharacterTextSplitter的分块逻辑
在分块的同时,必须注入元数据。将之前提取的文件名、页码、标题层级作为元数据附加到每个 Chunk 上。例如,一个来自“2023财报.pdf”第5页“营收分析”章节的文本块,其元数据应包含 {"source": "2023财报.pdf", "page": 5, "section": "营收分析"}。这使得在检索时可以过滤特定来源,提高回答的可解释性。
5. 验证数据质量与入库测试
预处理完成后,不要直接全量入库。随机抽取 5-10 个文本块,人工检查其可读性和完整性。确认没有残留的页眉页脚,表格数据是否保持了行列对应关系,以及句子是否在合理的位置断开。
使用一个简单的嵌入模型(如 BGE-M3 或 text-embedding-ada-002)对样本块进行向量化,并计算余弦相似度。如果同一文档内相邻块的相似度过低,可能意味着分块粒度太细或噪声过多;如果不同文档的块异常相似,检查是否去除了通用的 boilerplate 文本(如免责声明)。
确认无误后,将处理好的 JSONL 或 Parquet 文件导入向量数据库。保留原始的清洗脚本和中间日志,以便当用户反馈检索结果不佳时,能快速回溯是解析阶段丢失了信息,还是分块策略不当。
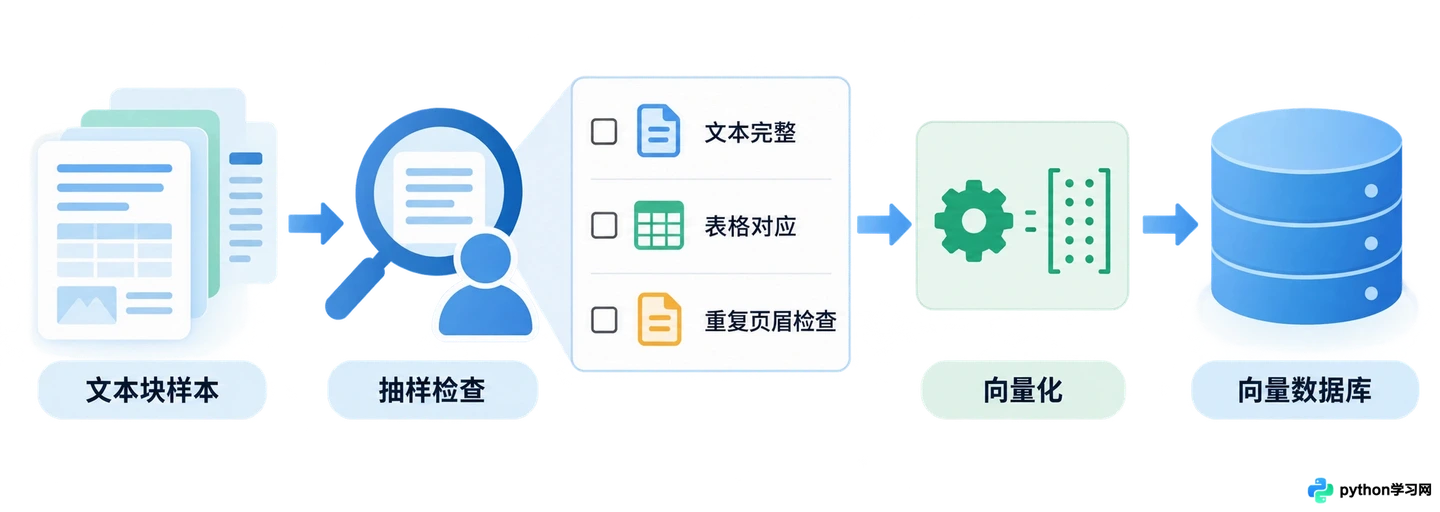
预处理后的数据块质量检查与入库流程
通过上述步骤,你可以将杂乱的 PDF 和 Word 文档转化为结构清晰、语义连贯的知识库素材。记住,RAG 的效果上限取决于数据质量,花在预处理上的时间最终会在检索准确率中得到回报。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















