


怎么用列表推导式在Python中快速生成数组

一、列表推导式的核心语法与原理拆解
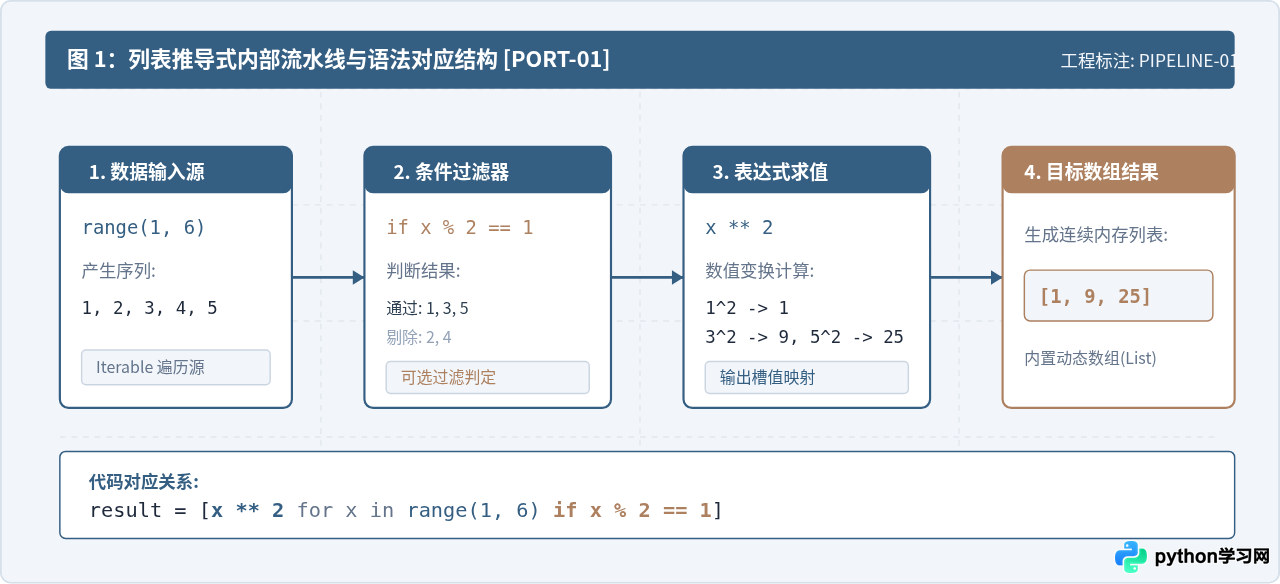
列表推导式的基本构造包含在方括号 [] 之内,核心部分由三部分组成:目标生成表达式、for...in 迭代子句,以及可选的 if 过滤子句。其标准结构如下:
[输出表达式 for 变量 in 可迭代对象 if 过滤条件]当 Python 解释器执行列表推导式时,它会依次从可迭代对象中取出元素,先交由过滤条件评估。只有条件为真(或未定义过滤条件)时,才会计算前面的输出表达式,并将最终结果顺序压入预备分配的数组缓存区中。
二、快速生成各类数组的操作步骤与示例
在实际编程中,根据维度和规则的不同,数组的生成可归纳为四个常见场景:生成固定初值数组、生成数值规律数组、条件筛选数组以及生成二维多维数组。
1. 生成固定默认值或常数的一维数组
当需要初始化一个长度为 N 且填充指定默认值(如 0、False 或 None)的数组时,除了使用乘法扩充 [0] * N 外,使用列表推导式能够清晰表达初始化意图,特别是在元素为可变对象时具有天然的隔离优势:
# 生成包含 8 个整数 0 的数组
zeros = [0 for _ in range(8)]
# 输出示例: [0, 0, 0, 0, 0, 0, 0, 0]
2. 生成满足数学变换与连续区间的一维数组
结合内置函数 range(),可以快速生成线性递增、等差序列或经数学公式映射后的数组:
# 生成 0 到 9 的平方数数组
squares = [x * x for x in range(10)]
# 输出示例: [0, 1, 4, 9, 16, 25, 36, 49, 64, 81]

# 对字符串列表进行预处理得到长度数组
words = ["python", "array", "comprehension", "fast"]
lengths = [len(w) for w in words]
# 输出示例: [6, 5, 13, 4]
3. 带条件过滤与分支转换的数组生成
推导式中的条件语句有两种常见用法:
- 仅做过滤(放在末尾):只有满足条件的元素才会被生成。
- 条件选择变换(放在 for 前面):使用三元表达式
A if condition else B对每个元素做分支处理,输出数组长度与原数据源一致。
# 场景 A: 仅保留 0 到 19 中的偶数 (过滤模式)
evens = [x for x in range(20) if x % 2 == 0]
# 输出示例: [0, 2, 4, 6, 8, 10, 12, 14, 16, 18]

# 场景 B: 奇数保持原样,偶数取负值 (分支变换模式)
transformed = [x if x % 2 != 0 else -x for x in range(6)]
# 输出示例: [0, 1, -2, 3, -4, 5]
4. 嵌套推导式快速构建二维数组(矩阵)
生成二维矩阵时,外层循环控制行(row),内层循环控制列(column)。外层推导式的每一个单元都是一个独立的内层推导式:
# 生成 3 行 4 列全 0 的二维矩阵
rows, cols = 3, 4
matrix_zeros = [[0 for _ in range(cols)] for _ in range(rows)]
# 输出示例:
# [
#   [0, 0, 0, 0],
#   [0, 0, 0, 0],
#   [0, 0, 0, 0]
# ]

# 生成 3x3 乘法坐标矩阵 (元素为 row * col)
grid = [[r * c for c in range(1, 4)] for r in range(1, 4)]
# 输出示例: [[1, 2, 3], [2, 4, 6], [3, 6, 9]]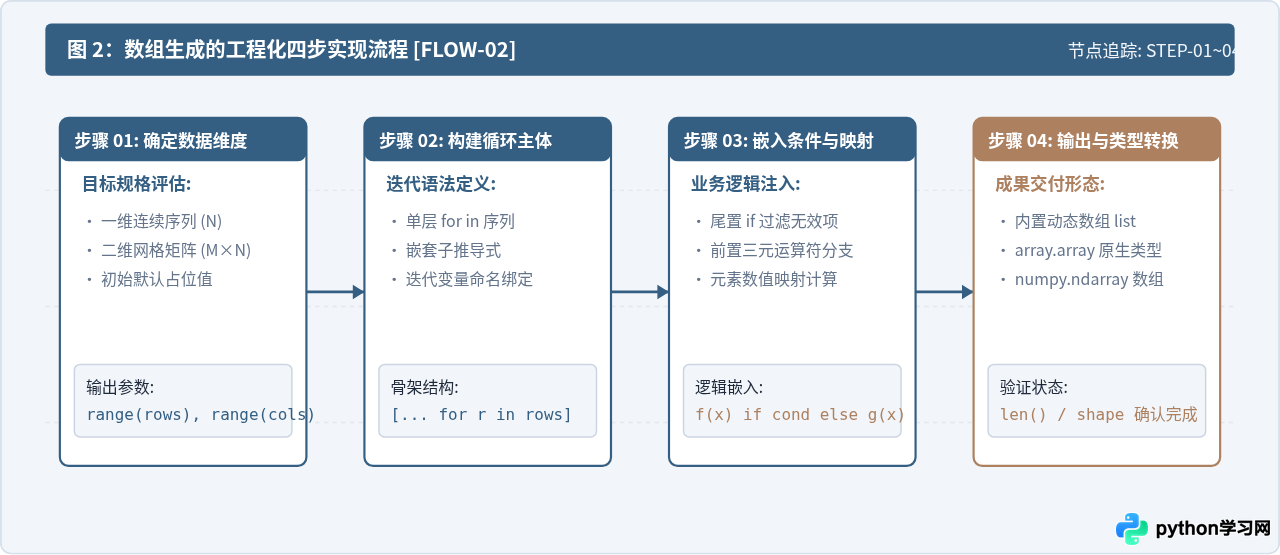
三、底层机制与传统循环的性能对比
很多读者会有疑问:列表推导式与普通的 for 循环配合 list.append() 相比,仅仅是代码行数更少,还是真正具有性能优势?
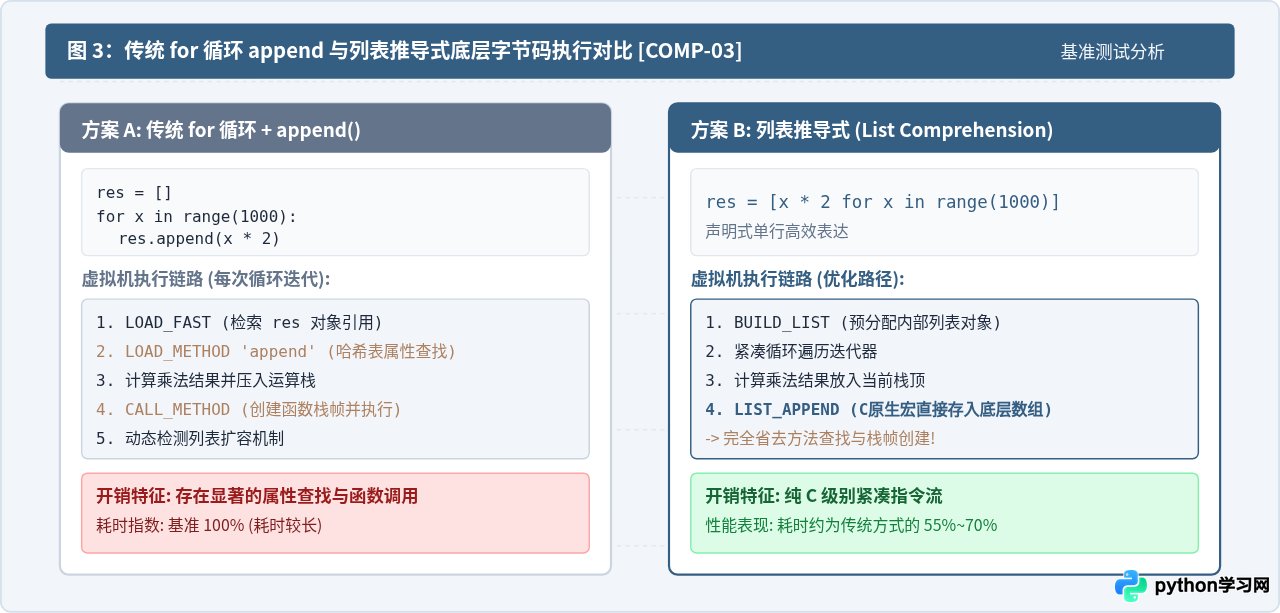
答案是肯定的。列表推导式在执行速度上通常比显式 for 循环快 25% 至 50% 左右。这种差异来源于 Python 虚拟机底层的字节码与内存操作机制:
- 避免频繁的方法查找与调用:在传统
for循环中,每次调用arr.append(item)时,解释器都必须通过LOAD_METHOD(或LOAD_ATTR)在对象中查找append属性,再通过CALL_METHOD压入函数调用栈。而在列表推导式中,解释器直接使用底层专用的 C 级指令LIST_APPEND,完全省去了属性检索与函数调用栈开销。 - 预估分配与紧凑循环:列表推导式在 CPython 解释器内部有紧凑的原生循环实现,对内存分配有更优的预测策略,数据能更直接地写入数组缓冲区。
四、容易出现的典型陷阱与规避方法
1. 浅拷贝陷阱:避免使用 `[[0]*cols]*rows` 初始化二维数组
初学者在需要初始化二维数组时,常会误写为 [[0] * 3] * 3。这种写法极其危险,因为乘法操作只是将同一个内层列表的引用复制了 3 次。当修改 matrix[0][0] = 1 时,所有行的第一列都会同时发生改变。
[[0 for _ in range(cols)] for _ in range(rows)]。外层推导式在每次迭代时都会独立执行内层推导式,从而为每一行创建全新的、相互独立的列表对象。
2. 嵌套深度与代码可读性
列表推导式支持多重嵌套,但过深的嵌套(超过两层)会导致代码极其难以理解和维护。例如,将三维张量展开或带复杂三元判断的多层推导式压缩在一行,会增加后期排查 bug 的成本。当逻辑较为复杂时,应拆分为常规循环或封装为独立生成函数。
3. 海量数据场景下的内存溢出风险
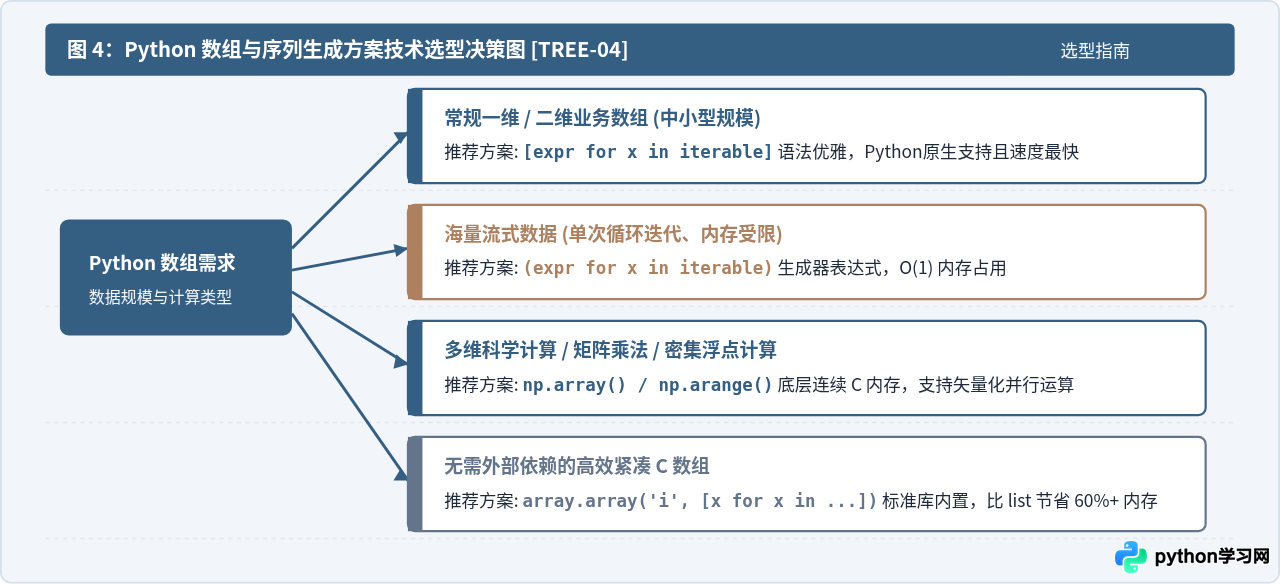
列表推导式是一次性计算并分配完整的内存空间来容纳所有元素。如果需要处理的数据量极其庞大(例如生成上千万个整数),列表推导式可能会瞬间耗尽系统内存。如果这些数据只需要按顺序单次遍历消费,应将外层中括号 [] 替换为小括号 (),转为生成器表达式(Generator Expression):
# 列表推导式:立刻占用大量内存
large_list = [x for x in range(10_000_000)]

# 生成器表达式:惰性求值,占用极少固定内存
large_gen = (x for x in range(10_000_000))
五、数组生成方案技术选型指南
虽然列表推导式十分便利,但面对数值计算、固定类型连续存储或高维度矩阵时,Python 生态中还有其他工具协同使用。下面的决策结构展示了不同应用场景下的推荐方案:
六、全文总结
用列表推导式在 Python 中快速生成数组是兼顾可读性与运行性能的最佳实践。在实际编码中,牢记以下三个核心建议:
- 熟练掌握语法位置:纯过滤逻辑的
if紧随其后放在末尾;分支映射逻辑的if-else必须置于for前部。 - 防御二维引用陷阱:构建多维矩阵务必采用嵌套推导式,杜绝使用乘法浅拷贝生成二维列表。
- 权衡空间与时间:在常规规模下充分发挥推导式
LIST_APPEND带来的底层速度优势;面对超大体量序列时,及时切换为生成器表达式或专门的数值计算库。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















