


Python大规模字符串模糊匹配的性能优化策略

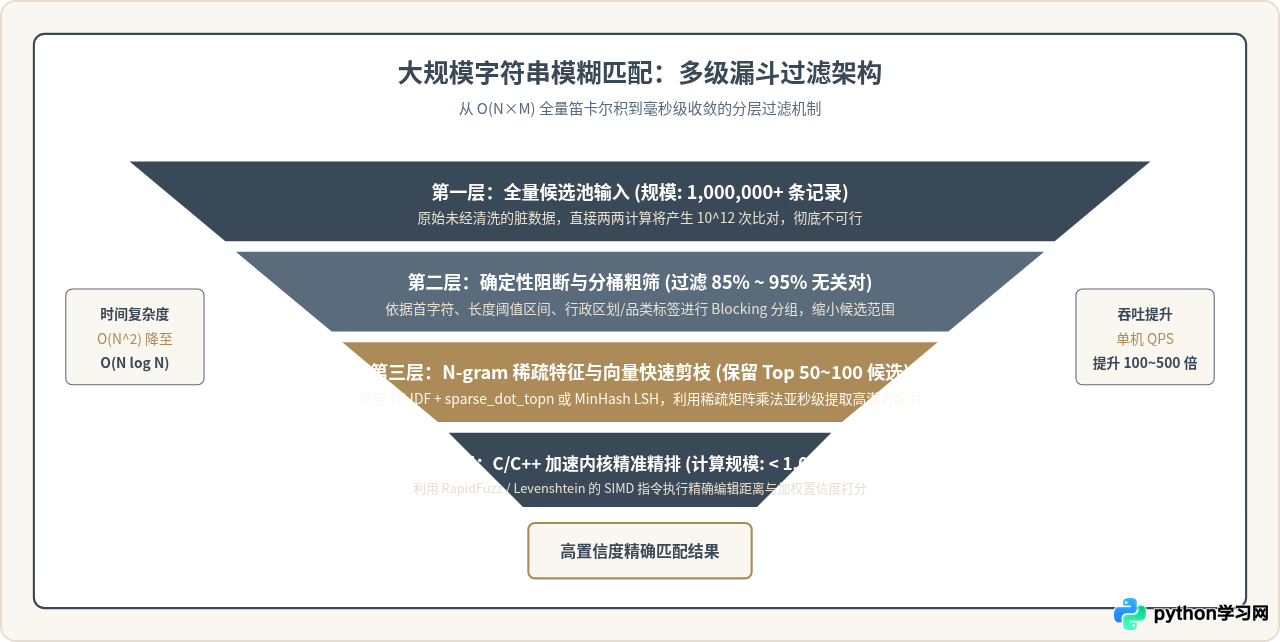
在海量文本清洗、企业实体对齐、商品标题去重和日志反洗钱分析等场景中,字符串模糊匹配是高频核心环节。然而,当输入文本量级从数百条跃升至数十万甚至千万级时,传统的纯 Python 双重循环暴力匹配(如标准库 difflib)会迅速陷入计算瓶颈:面对两组规模分别为 10 万的文本库,全量两两比对需要执行高达 100 亿次编辑距离运算,耗时可达数天。解决这一性能难题的关键并非单纯堆砌算力,而是构建一套从底层计算引擎替换、特征倒排粗筛到度量空间剪枝的分层优化体系,在保留高匹配召回率的前提下,将整体计算复杂度从 O(N×M) 降低到近线性量级。
一、为什么纯 Python 匹配在规模化时会崩溃
很多工程团队在初期处理千行级别文本时,往往习惯使用 difflib.get_close_matches 或 fuzzywuzzy。这些工具在处理小批量任务时简单直接,但一旦数据量突破数万行,运行耗时就会呈爆炸式上升。究其原因,主要存在三个维度的瓶颈:
- 笛卡尔积计算膨胀:若目标文本池有 $N$ 条,查询文本池有 $M$ 条,无索引的比较必须执行 $N \times M$ 次两两对比。当 $N=10^5, M=10^5$ 时,比对次数高达 100 亿次。
- 动态规划算法本身的高复杂度:经典的莱文斯坦编辑距离(Levenshtein Distance)采用动态规划算法,单次两两比较的复杂度为 $O(L_1 \times L_2)$,其中 $L$ 为字符串平均长度。这意味着计算量随字符长度平方级上升。
- CPython 解释器的执行开销:纯 Python 代码存在大量的对象头解包、动态类型检查及局部变量查找开销,无法利用现代 CPU 的 SIMD 矢量化指令集与多核缓存并行机制。
二、第一步基石:用底层 C++ / SIMD 引擎全面替代纯 Python
如果业务规模在 1万到 5万条 之间,且必须保留两两计算逻辑,最直截了当的优化是用底层基于 C++ 实现、支持现代 CPU SIMD(单指令多数据流)向量化指令的库替代纯 Python 库。目前业界表现最出色的是 RapidFuzz。
RapidFuzz 完全兼容 FuzzyWuzzy 的 API,并在底层使用 C++17 重写,针对 AVX2 和 SSE4.2 指令集进行了极限优化,同时免去了外部 CPython GIL 的额外损耗。在相同数据集上,其单线程匹配速度通常是纯 Python 实现的 30 到 100 倍以上。
# 传统极慢写法(difflib / 纯 Python)
# import difflib
# match = difflib.get_close_matches(query, target_list, n=1, cutoff=0.8)

# 推荐高性能写法:使用 RapidFuzz C 扩展与提取器
from rapidfuzz import process, fuzz

query_items = ["苹果iPhone 15 Pro Max 256G", "华为Mate60 Pro 雅丹黑"]
candidate_pool = [
    "Apple iPhone 15 Pro Max 256GB 黑色",
    "华为 Mate 60 Pro 512GB 雅丹黑",
    "小米 14 Ultra 钛金属",
    "三星 Galaxy S24 Ultra"
]

# 单条高频提取:使用 process.extractOne,指定高效评分准则
for q in query_items:
    best_match = process.extractOne(
        q,
        candidate_pool,
        scorer=fuzz.token_sort_ratio,
        score_cutoff=60.0
    )
    # best_match 返回结构: (匹配文本, 相似度得分, 目标索引)
    print(f"查询: {q} -> 匹配结果: {best_match}")
若文本词序颠倒(如“华为 旗舰店 手机”与“手机 华为 旗舰店”),使用 fuzz.token_sort_ratio 可预先将词元排序,大幅提升准确率;若文本包含多余非关键词(如“正品现货速发”),使用 fuzz.token_set_ratio 可去重后比对,避免长尾词拉低相似分。
三、十万至千万级核心方案:基于 N-gram 的稀疏矩阵倒排索引
单纯依靠 RapidFuzz 加速,当数据量达到 10 万以上时仍然无法克服 $O(N \times M)$ 的计算量级。真正实现量级飞跃的核心手段是:先利用稀疏矩阵倒排索引进行前置粗筛,仅提取前 50~100 个高潜力候选者,再送入编辑距离做精确重打分。
具体做法是将字符串拆解为字符级别的 N-gram(例如以 3 个字符为一个切片滑动窗口)。相似的字符串必然共享大量的相同 N-gram。通过构建 TF-IDF 稀疏矩阵,并使用专门优化稀疏点积运算的 sparse_dot_topn 库,可以直接在 C++ 层面并发完成余弦相似度前 K 名筛选,耗时仅需数秒。
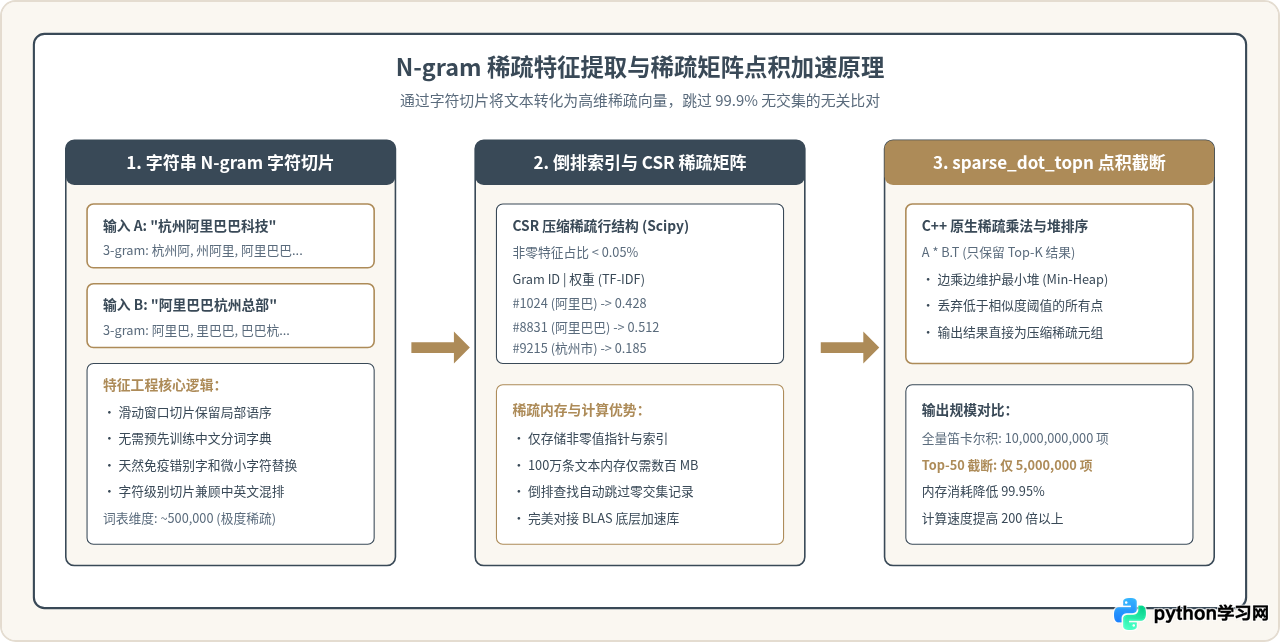
以下为使用 scikit-learn 与 sparse_dot_topn 进行大规模文本匹配的完整生产级代码范例:
import re
import numpy as np
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from sparse_dot_topn import awesome_cossim_topn

def build_char_ngrams(text: str, n: int = 3) -> list[str]:
    """清洗文本并生成固定步长的字符级 N-gram"""
    cleaned = re.sub(r"[^\w\s]", "", str(text)).strip().lower()
    if len(cleaned) < n:
        return [cleaned]
    return [cleaned[i:i + n] for i in range(len(cleaned) - n + 1)]

# 模拟 10 万条基准库与 10 万条待匹配样本
base_corpus = ["杭州阿里巴巴网络技术有限公司", "腾讯计算机系统有限公司", "北京百度网讯科技有限公司"] * 33333
query_corpus = ["阿里巴巴网络技术公司", "深圳市腾讯计算机", "北京百度科技有限公司"] * 33333

# 1. 构建字符级别 TF-IDF 向量化器(利用 analyzer 自定义切分)
vectorizer = TfidfVectorizer(analyzer=lambda s: build_char_ngrams(s, n=3))

# 拟合基础库并转化为 CSR 稀疏矩阵
tf_base = vectorizer.fit_transform(base_corpus)
tf_query = vectorizer.transform(query_corpus)

# 2. 调用 C++ 优化的顶层点积算法:每个 query 最多保留前 5 个最相似项,且相似度 > 0.4
top_matches = awesome_cossim_topn(
    tf_query,
    tf_base.transpose(),
    ntop=5,
    lower_bound=0.4,
    use_threads=True,
    n_jobs=4
)

# 3. 解析结果为坐标元组 (query_idx, base_idx, score)
query_indices, base_indices = top_matches.nonzero()
scores = top_matches.data

matches_df = pd.DataFrame({
    "query_id": query_indices,
    "base_id": base_indices,
    "cosine_score": scores
})
print("粗筛完成,候选匹配对总数:", len(matches_df))
四、海量数据极致架构:分层阻断(Blocking)与局部敏感哈希(LSH)
当候选样本库达到数千万(10M+)量级时,哪怕是稀疏矩阵相乘也会对单机内存带来较大负担。此时,业界标准做法是引入 阻断分桶(Blocking) 或 MinHash LSH(局部敏感哈希)。
1. 规则阻断与分组索引(Blocking)
阻断的核心理念是:两个极度相似的实体,必然在某些坚固的元数据特征上保持一致。例如公司名称比对中,处于不同省份、不同行业分类的实体几乎不可能匹配;或者按文本长度分桶(两个编辑距离小于 2 的字符串,其长度差绝对不会超过 2)。通过将数据集按所属省份、长度区间或首字母进行哈希分组,只在桶内执行匹配,可瞬间将单次比对的范围缩小为原先的几百分之一。
2. MinHash LSH(基于 Jaccard 相似度的常数级定位)
MinHash LSH 通过多次哈希变换,使得两个 Jaccard 相似度较高的集合以极高的概率碰撞落入同一个哈希桶内。查询时只需根据哈希值直接从倒排桶中检索候选集,其单次候选检索的时间复杂度接近 $O(1)$,极其适合亿级分布式文本去重。
五、工程实施流水线:从原始数据到高置信度落地
在实际生产部署中,高性能匹配绝不仅仅是一个算法调用,而是一条兼顾预处理、并行调度、内存安全和流式输出的工程流水线。
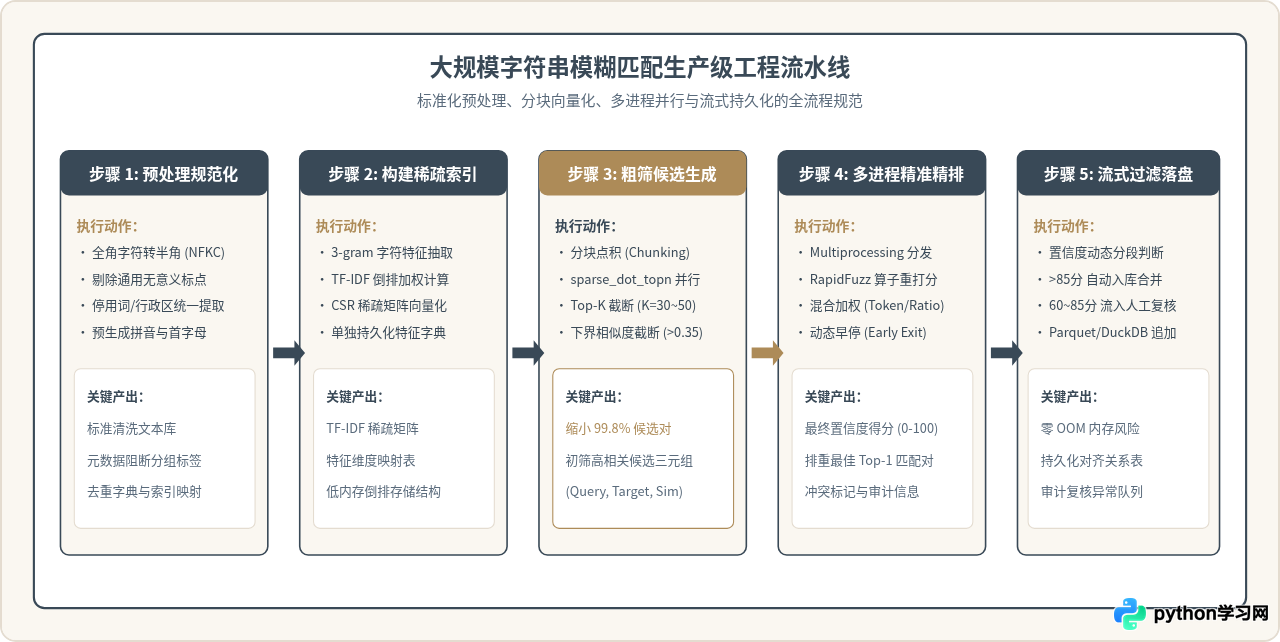
实战中的四大调优细节:
- 分块点积防止内存溢出(Chunking):当 Query 规模达到百万时,一次性生成整个结果稀疏矩阵可能消耗数十吉字节内存。建议将 Query 划分为每批 5 万至 10 万条的小切片,分别与 Base 稀疏矩阵进行点积,批次完成后立即写入磁盘释放内存。
- 多进程(Multiprocessing)并行精排:精排阶段的 RapidFuzz 计算属于典型的 CPU 密集型任务。由于 Python 的 GIL(全局解释器锁)存在,单进程无法发挥多核 CPU 实力。应使用
multiprocessing.Pool或concurrent.futures.ProcessPoolExecutor将初筛后的候选配对按核数均衡分发。 - 数据格式选型(Polars / PyArrow 替代纯 Python List):大规模字符串在纯 Python 的
list[str]中会产生巨量的PyUnicodeObject对象指针,导致 CPU 缓存频繁失效(Cache Miss)并增加垃圾回收停顿。使用基于 Rust 开发的Polars或原生PyArrow处理字符串列,不仅内存占用缩小 60%,而且内存连续分布极大提升了扫描速度。 - 阈值双重切分策略:在企业主数据对齐中,切忌一刀切。建议设置双阈值:高于 85 分直接由系统自动对齐合并;60 到 85 分之间进入候选复核队列,结合其他元数据规则判定;低于 60 分直接舍弃,有效规避误合并风险。
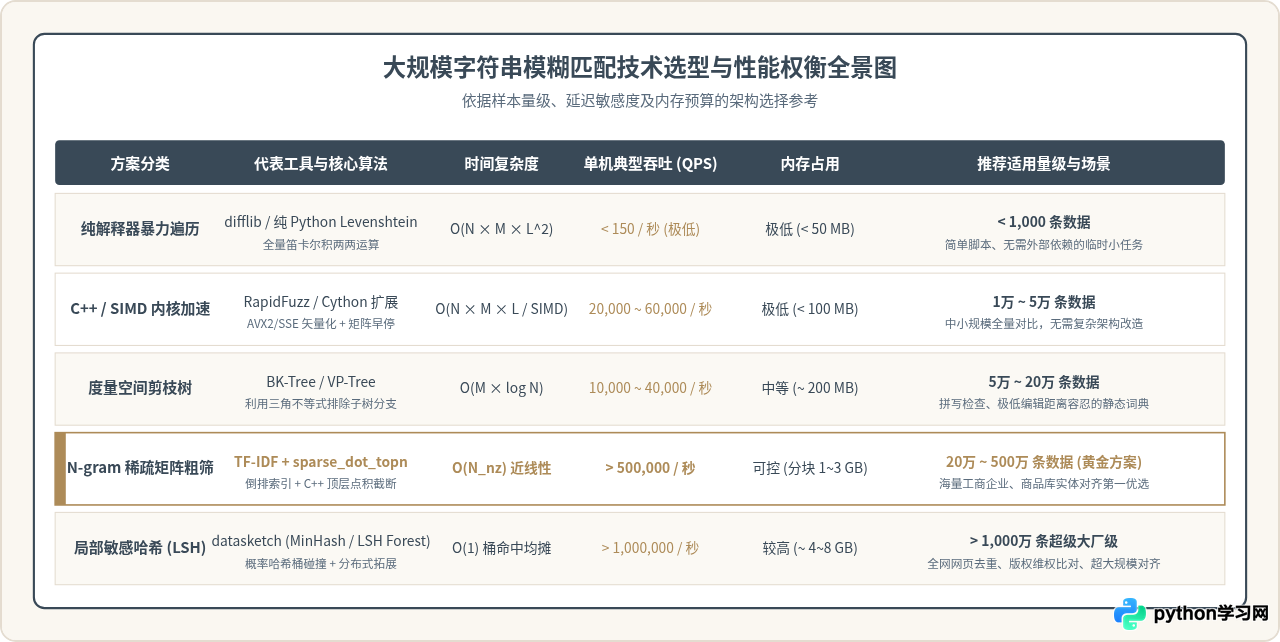
六、各场景优化策略综合选型对比
不同的数据量级和响应时效要求决定了最佳技术栈的选择。以下是涵盖主流优化方案的综合决策矩阵:
七、总结与落地建议
面对 Python 大规模字符串模糊匹配的性能挑战,核心结论可以归纳为十二个字:“规则分桶阻断,稀疏矩阵粗筛,C核矢量精排”。
在实际落地时,切忌一开始就投入复杂的深度学习模型或全量两两死算。对于 5 万以内的场景,立即将标准库更换为 rapidfuzz,即可轻松获得几十倍的效率提升;对于 10 万至数百万量级的场景,采用 TfidfVectorizer(analyzer=3-gram) 搭配 sparse_dot_topn 提取 Top-30 候选集,再辅以多进程 RapidFuzz 精确打分,是兼具极高召回率、极低内存开销与数分钟内完成计算的最佳工程范式。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















