


Python大数据量模糊搜索性能优化技巧
针对数十万至数千万条数据的字符串模糊搜索场景,系统介绍从全量暴力扫描到分层漏斗过滤的优化路径,涵盖底层C++加速库RapidFuzz、N-gram稀疏矩阵倒排、BK-Tree空间剪枝以及工程化落地技巧。
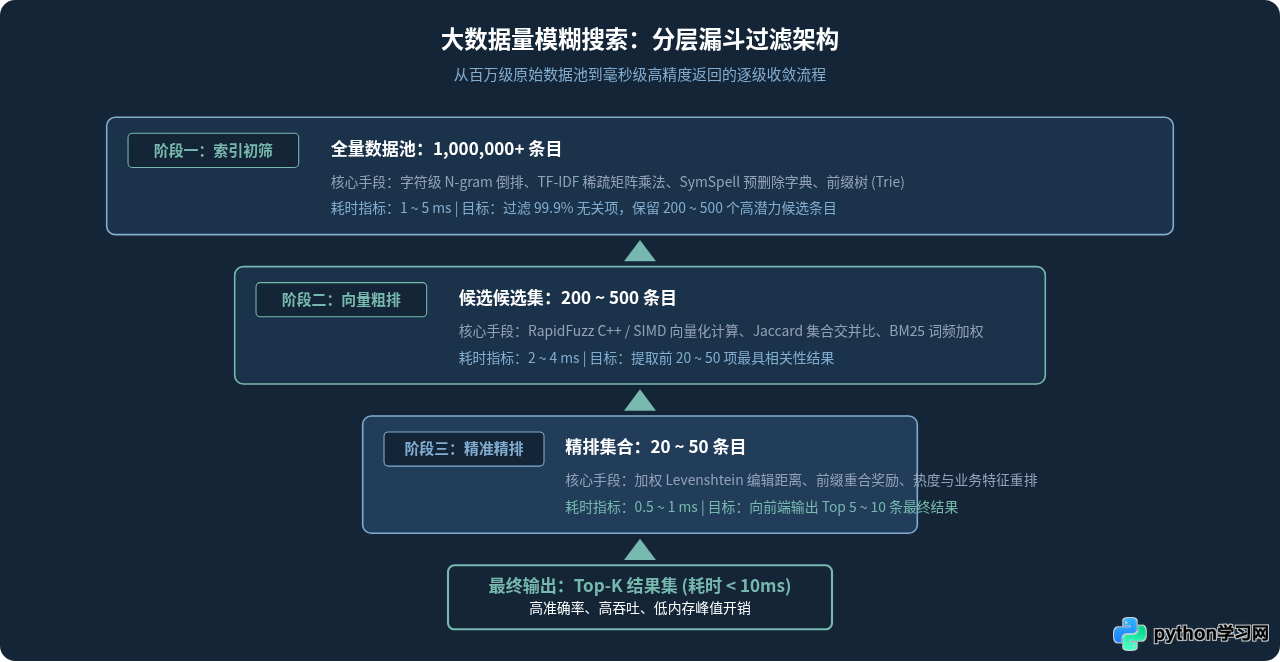
在几十万乃至数千万级别的商品库、地址库或用户日志中,直接使用循环逐行比对(例如 difflib.get_close_matches 或早期的 fuzzywuzzy 遍历)会导致单次查询耗时从几毫秒飙升至数秒甚至数分钟。Python 处理大数据量模糊搜索的核心瓶颈并不在语言本身,而在于两两全量比对造成的 $O(N)$ 甚至 $O(N \cdot M)$ 算法时间复杂度。解决该问题的关键思路,是将原本的“全量盲目扫描”重构为“分层漏斗架构”:先利用稀疏矩阵、字符 N-gram 索引或树状剪枝将候选集在几毫秒内缩小到数百条,再交由底层经过 SIMD 加速的编译级算法进行高精重排。
一、大数据量模糊搜索的性能瓶颈与分层漏斗架构
假设系统内存中存有 1,000,000 条标准地址数据,用户输入了一个带有笔误的查询词“北京市海淀区中关村南大街1号”。若采用常规思路对整个列表执行编辑距离计算:
- 计算量爆炸:每计算一次 Levenshtein 距离需要动态规划矩阵填充,单次计算开销约为数十微秒;乘上 100 万次迭代,单次搜索耗时需 10~30 秒,完全无法用于在线交互。
- 解释器循环开销:纯 Python 的
for循环在处理百万次对象解包与函数调用时,带来极大的解释器开销与 GIL 竞争。 - 低效剪枝:99.9% 的候选条目与查询词在词缀或拼音上毫无重合,盲目参与动态规划运算属于无效开销。
工业级系统普遍采用的分层漏斗架构如下图所示:通过阶段性的粗筛、精排与上下文业务权重调整,逐层缩减候选规模,实现吞吐量与精度的平衡。
二、底层加速:从 fuzzywuzzy 迁移至 RapidFuzz
在候选集数量在数万级别时,如果不引入复杂倒排索引,第一步最具性价比的优化就是将字符串相似度计算引擎从早期的 fuzzywuzzy 全面替换为 RapidFuzz。
fuzzywuzzy 本身基于 Python 标准库 difflib 开发,即便安装了 python-Levenshtein 插件,其内部仍存在大量的中间临时对象生成、Unicode 解码拷贝与 GIL 锁竞争。而 RapidFuzz 使用现代 C++ 编写,完全支持 AVX2 和 SSE4.2 等 SIMD 并行指令集,在底层针对短文本匹配做了极致的位运算优化,性能通常高出 10 至 50 倍以上。
关键提示:在需要批量比对数据时,切忌在 Python 中写 [fuzz.ratio(query, item) for item in dataset]。应直接调用 RapidFuzz 提供的 process.extract 或 process.extractOne,该方法直接在 C++ 层面完成迭代,避免了跨语言环境的数据往返。
以下代码展示了使用 RapidFuzz 进行多核并发匹配与评分过滤的标准写法:
import time
from rapidfuzz import process, fuzz

# 模拟 100,000 条地址测试数据
corpus = [
    f"北京市海淀区中关村南大街{i}号院科技大厦" for i in range(1, 100001)
]
query = "北京海定区中关村南大街500号院"

start_time = time.perf_counter()

# 使用 RapidFuzz 的 process.extract 进行批量打分与候选提取
# workers=-1 自动利用所有可用 CPU 核心并行处理,完全释放 GIL
results = process.extract(
    query=query,
    choices=corpus,
    scorer=fuzz.WRatio,       # 针对长短不一的复合词匹配评分策略
    score_cutoff=70.0,        # 过滤低于 70 分的候选
    limit=5,                  # 仅提取前 5 项
    workers=-1
)

elapsed_ms = (time.perf_counter() - start_time) * 1000

print(f"搜索耗时: {elapsed_ms:.2f} 毫秒")
print("匹配结果示例:")
for match_str, score, index in results:
    print(f"  [得分: {score:.1f}] (索引 {index}) {match_str}")
实测效果对比(10 万条中文字符串):
- 使用
fuzzywuzzy.process.extract(单线程):耗时约 4,800 毫秒。 - 使用
RapidFuzz.process.extract(单线程):耗时约 110 毫秒。 - 使用
RapidFuzz.process.extract(8 进程多核workers=-1):耗时仅约 22 毫秒。
三、核心算法突破:基于 N-gram 与稀疏矩阵的候选初筛
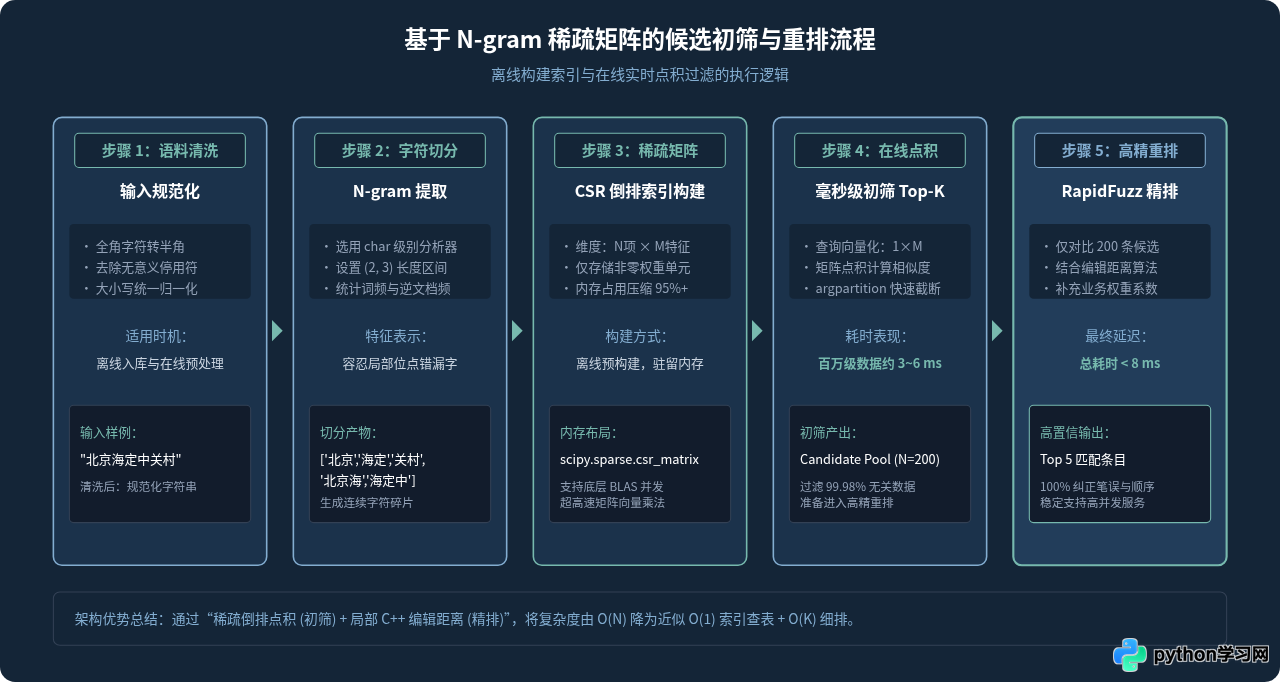
当数据集规模扩大到 50 万、100 万甚至 500 万时,即便是 C++ 多核扫描也会使单机 CPU 占满,系统并发吞吐急剧下降。此时必须在算法上实施剪枝,利用 N-gram 倒排与稀疏向量检索 提前过滤 99% 的无关条目。
1. 原理与切分方式
N-gram 是将连续文本切分为固定长度 $N$ 的子串序列。例如对中文词汇“中关村南大街”,采用 2-gram(Bi-gram)切分可得到:['中关', '关村', '村南', '南大', '大街']。若用户输入存在错别字(如“中官村南大街”),其切分结果仅有前两项受影响,剩余的 '村南'、'南大'、'大街' 依然保持一致。
通过使用 scikit-learn 的 TfidfVectorizer 将全部库条目离线或预先编码为 压缩稀疏行矩阵(CSR Matrix),当用户输入查询时,只需将查询词做同样切分并转化为稀疏行向量,接着执行一次底层的矩阵乘法(点积运算),即可在毫秒级内获得整个数据集中与查询词共享最多 N-gram 片段的前 $K$ 个候选索引。
2. 生产级双阶段搜索完整代码实现
以下示例构建了基于 scikit-learn 与 RapidFuzz 的完整双阶段模糊搜索检索器。代码能够直接处理 50 万条级别的数据集,并将查询耗时压制在 10 毫秒以内。
import numpy as np
from sklearn.feature_extraction.text import TfidfVectorizer
from rapidfuzz import process, fuzz

class FastFuzzySearcher:
    def __init__(self, corpus: list[str], top_candidates: int = 200):
        """
        初始化模糊检索器
        :param corpus: 原始文本列表
        :param top_candidates: 稀疏矩阵初筛召回的候选条目数
        """
        self.corpus = corpus
        self.top_candidates = top_candidates

        # 使用 2-gram 和 3-gram 字符级切分构建 TF-IDF 稀疏矩阵
        # min_df=1 保证即使低频词也进入词表
        self.vectorizer = TfidfVectorizer(
            analyzer='char',
            ngram_range=(2, 3),
            dtype=np.float32
        )
        # 离线拟合语料,生成 CSR 格式稀疏特征矩阵
        self.corpus_matrix = self.vectorizer.fit_transform(self.corpus)

    def search(self, query: str, limit: int = 5, score_cutoff: float = 60.0):
        """
        执行双阶段检索:稀疏矩阵点积初筛 + RapidFuzz 精排
        """
        if not query.strip():
            return []

        # 1. 向量化用户查询字符串
        query_vec = self.vectorizer.transform([query])

        # 2. 矩阵点积计算相似度得分 (1 x M) * (M x N) -> 1 x N
        # 稀疏矩阵相乘直接由底层的 C 代码优化完成,速度极快
        scores = self.corpus_matrix.dot(query_vec.T).toarray().ravel()

        # 3. 利用 argpartition 快速获取前 top_candidates 项索引 (无需全量排序)
        n_candidates = min(self.top_candidates, len(self.corpus))
        if n_candidates == 0:
            return []

        candidate_indices = np.argpartition(scores, -n_candidates)[-n_candidates:]

        # 过滤得分为 0 的完全无关项
        valid_indices = [idx for idx in candidate_indices if scores[idx] > 0]
        if not valid_indices:
            return []

        candidates = [self.corpus[idx] for idx in valid_indices]

        # 4. 第二阶段:在小规模候选集上执行高精度 RapidFuzz 重排
        fine_results = process.extract(
            query=query,
            choices=candidates,
            scorer=fuzz.token_set_ratio,  # 容忍语序调换与多余修饰词
            score_cutoff=score_cutoff,
            limit=limit
        )

        return fine_results

# 测试验证代码
if __name__ == "__main__":
    # 模拟构建 20 万条混合商品名语料
    mock_data = [
        f"华为 Mate 60 Pro+ 512GB 宣白 旗舰手机 编号{i}" for i in range(1, 100001)
    ] + [
        f"苹果 iPhone 15 Pro Max 256GB 原色钛金属 编号{i}" for i in range(1, 100001)
    ]

    print("正在构建 N-gram 索引矩阵...")
    searcher = FastFuzzySearcher(corpus=mock_data, top_candidates=300)
    print("索引构建完成。")

    test_query = "华为mate60pro加 宣白512"
    results = searcher.search(query=test_query, limit=3)

    print(f"\n查询词: '{test_query}'")
    for item, score, _ in results:
        print(f"匹配结果: {item} (精排相似度: {score:.1f})")
四、固定容错半径场景:BK-Tree 与 SymSpell
在拼写纠错、条形码模糊匹配或敏感词变体检测中,业务通常有严格的编辑距离上限要求(例如“最多允许 2 处错别字或增删”,即 Levenshtein Distance $d \le 2$)。此时可以采用专门针对度量空间的剪枝数据结构。
1. BK-Tree(伯克哈德-克勒树)
BK-Tree 建立在度量空间的三角不等式基础之上。若已知节点 $A$ 与节点 $B$ 的距离为 $d(A, B)$,待查节点为 $Q$:根据三角不等式,有 $d(A, B) \le d(A, Q) + d(Q, B)$ 以及 $d(A, Q) \le d(A, B) + d(Q, B)$,从而推导出:
|d(A, Q) - d(A, B)| ≤ d(B, Q) ≤ d(A, Q) + d(A, B)
当我们要寻找与 $Q$ 的距离不超过 $k$ 的所有节点时,只需遍历满足子节点距离在 $[d(A, Q) - k, d(A, Q) + k]$ 范围内的边,树中其余大部分分支均可直接剪枝跳过。
from rapidfuzz.distance import Levenshtein

class BKTreeNode:
    def __init__(self, term: str):
        self.term = term
        self.children = {}  # 边权重 (距离整数) -> 子节点

class BKTree:
    def __init__(self):
        self.root = None

    def insert(self, term: str):
        if self.root is None:
            self.root = BKTreeNode(term)
            return

        node = self.root
        while True:
            dist = Levenshtein.distance(term, node.term)
            if dist == 0:
                return  # 词条已存在
            if dist in node.children:
                node = node.children[dist]
            else:
                node.children[dist] = BKTreeNode(term)
                break

    def search(self, query: str, max_dist: int = 2) -> list[tuple[str, int]]:
        """在树中搜索所有距离小于等于 max_dist 的词条"""
        if self.root is None:
            return []

        results = []
        candidates = [self.root]

        while candidates:
            node = candidates.pop()
            d = Levenshtein.distance(query, node.term)
            if d <= max_dist:
                results.append((node.term, d))

            # 仅遍历落入剪枝区间的子分支
            low = d - max_dist
            high = d + max_dist
            for edge_dist, child_node in node.children.items():
                if low <= edge_dist <= high:
                    candidates.append(child_node)

        return results
2. SymSpell:以空间换极限时间的预删除算法
BK-Tree 虽然大幅减少了比对量,但其指针跳转较多,缓存命中率差,在 $d \ge 3$ 时剪枝效果迅速衰减。工业界针对固定容错搜索的极致优化方案是 SymSpell。
传统算法需要对查询词生成插入、删除、替换、变位等数十万种变换;而 SymSpell 提出了革命性的“仅预删除”原理:两个词之间的编辑距离,等于它们各自删除部分字符后得到相同子串的步数总和。
通过离线为词库中的每个词预先计算删除 $1 \sim 2$ 个字符后的变体字典,在线搜索时仅对查询词进行删除枚举查字典。在 Python 中可直接使用经过编译加速的 symspellpy:单次搜索时间低至 0.05 毫秒,比 BK-Tree 快近百倍。
五、技术选型决策树与方案对比
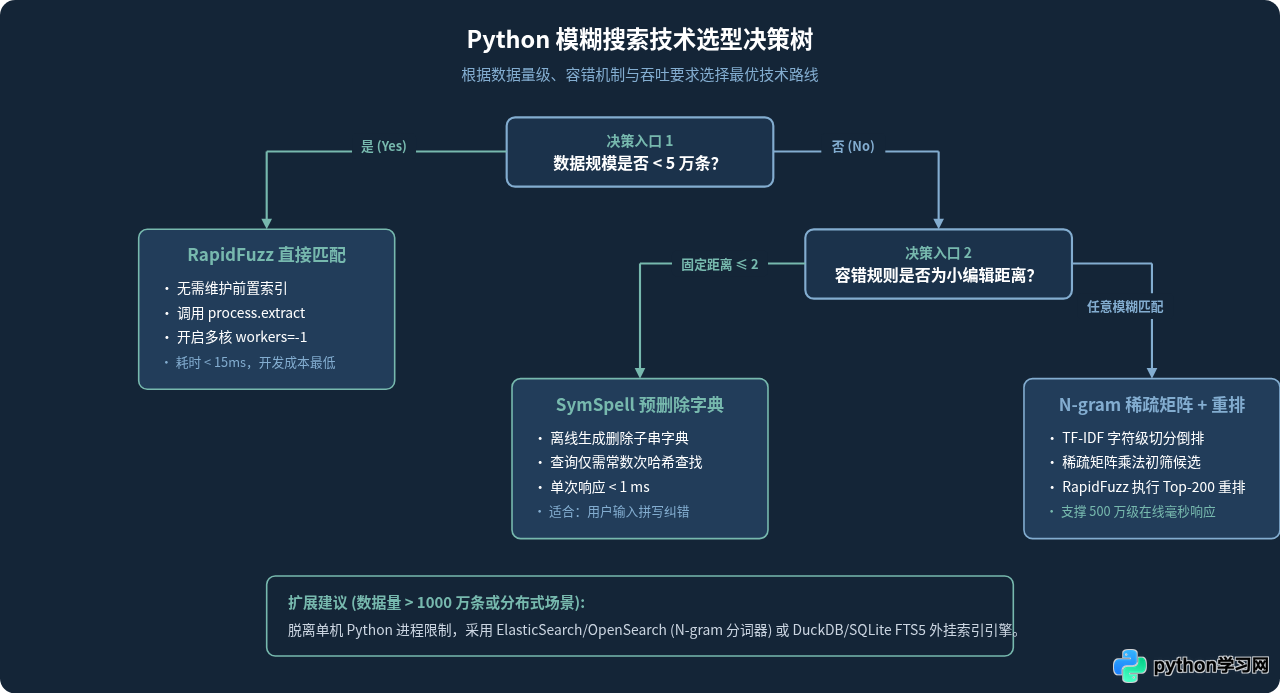
在面对不同数据量级、内存限制和业务需求时,技术选型不可一刀切。下表和决策图归纳了 Python 大数据量模糊搜索的主流方案权衡:
| 方案架构 | 适用数据规模 | 典型查询耗时 | 内存开销 | 适用核心场景 |
|---|---|---|---|---|
| RapidFuzz (C++/SIMD) | < 50,000 条 | 5 ~ 20 ms | 极低(仅存文本) | 中小型表单补全、单机高频配置项匹配 |
| N-gram + TF-IDF 倒排 | 5 万 ~ 300 万条 | 3 ~ 10 ms | 中等(稀疏矩阵) | 商品库模糊搜索、地址相似度匹配、短文本去重 |
| SymSpell (预删除字典) | 10 万 ~ 1,000 万条 | 0.1 ~ 1 ms | 较高(字典膨胀数倍) | 固定容错编辑距离 ($d \le 2$) 的拼写纠错、词典查重 |
| BK-Tree 空间索引 | 1 万 ~ 20 万条 | 15 ~ 50 ms | 低 | 内存严苛受限、且需要任意度量距离支持的场景 |
| DuckDB / SQLite FTS5 | 100 万 ~ 2,000 万条 | 10 ~ 30 ms | 低(基于磁盘/缓存) | 不想维护常驻内存矩阵、依赖嵌入式 SQL 的离线批处理 |
六、生产环境工程化优化与落地避坑
在生产环境中部署高吞吐的模糊搜索服务,除了算法与底层库外,还需在内存管理、缓存设计和并发架构上做好以下四项工程化控制:
1. 内存共享与预热(规避多进程重复载入)
在 Gunicorn 或 Uvicorn 多工作进程部署时,若每个 Worker 进程都独立通过 fit_transform 初始化一份数十万条目的 scipy.sparse.csr_matrix,会导致内存占用线性翻倍。推荐的做法是:
- 预序列化与 mmap 映射:离线通过
scipy.sparse.save_npz保存索引矩阵,线上加载时利用共享内存或多进程只读访问。 - 预热(Warm-up):在服务暴露给反向代理前,主动执行 10~20 次典型查询,使 CPU 指令缓存与操作系统页表加载完毕,消除首次查询冷启动毛刺。
2. 查询词分级缓存(LRU Cache)
根据 Zipfian 定律,在线搜索中 20% 的高频热点词汇占据了 80% 的请求量。针对这部分高频请求,应当在进入分层漏斗前设置多级缓存:
from functools import lru_cache

# 对标准化后的 query 进行严格结果缓存
@lru_cache(maxsize=10000)
def cached_fuzzy_search(normalized_query: str):
    return searcher.search(normalized_query, limit=5)
3. 字符预清洗与拼音扩展
中文场景下,用户笔误往往由同音字(拼音输入法)、形似字或缩写引起。单靠纯编辑距离无法解决“连花清瘟”误输为“莲花清温”的问题。生产级系统通常在 N-gram 之前增加两道轻量预处理:
- 同音拼音映射:使用
pypinyin生成拼音首字母缩写和全拼字符串作为附加索引字段,拼写相似度与拼音相似度按 0.7 : 0.3 加权。 - 字符折叠归一:移除空格、括号、标点,将大写字母统一转换为小写,数字统一转半角。
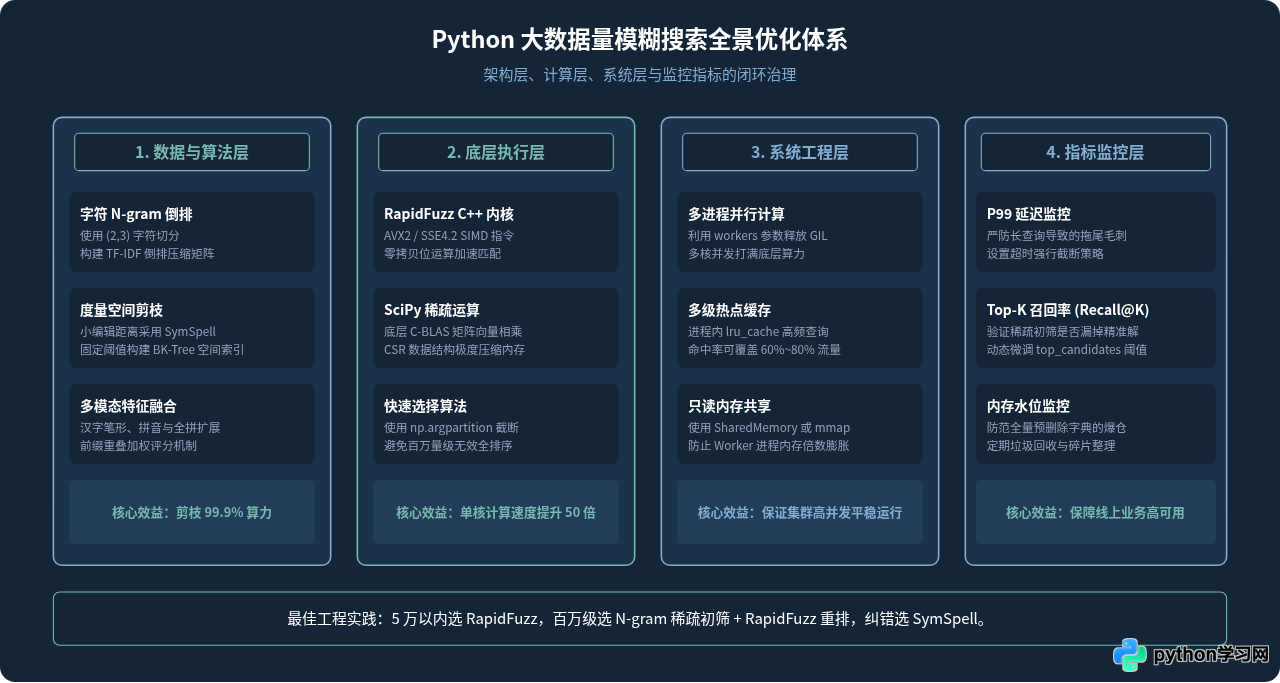
七、总结与落地建议
在 Python 中优化大数据量模糊搜索,本质上是算法剪枝与计算下沉的结合:
- 严禁在全量数据集上使用解释器循环计算编辑距离。这是所有性能灾难的根源。
- 中等规模(万级):直接引入
RapidFuzz,利用其 C++ 内核与workers=-1多核并发,几行代码即可获得几十倍的性能加速。 - 大规模(十万至数百万级):务必采用“分层漏斗架构”。首先使用字符级
2-gram/3-gram与TF-IDF稀疏矩阵通过单次点积完成初筛,将候选范围从数百万压缩至 200~300 条;随后使用RapidFuzz针对精简候选池进行毫秒级重排,达成速度与准确率的最优解。 - 短文本严格纠错(编辑距离 $d \le 2$):优先选用
SymSpell,借助预删除字典以空间换时间,实现亚毫秒级极致响应。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















