


Python中for循环与while循环的区别及适用场景

在 Python 编程中,for 循环与 while 循环是最基础且核心的流程控制语句。两者的本质区别在于驱动机制:for 循环基于可迭代对象(Iterable),核心是遍历已知范围或集合中的每一项元素;while 循环基于条件表达式(Condition),核心是依据布尔值的真假决定是否继续执行。理解这一差异,是选择正确循环结构、写出整洁安全代码的关键。
一、核心运行机制与执行流程对比
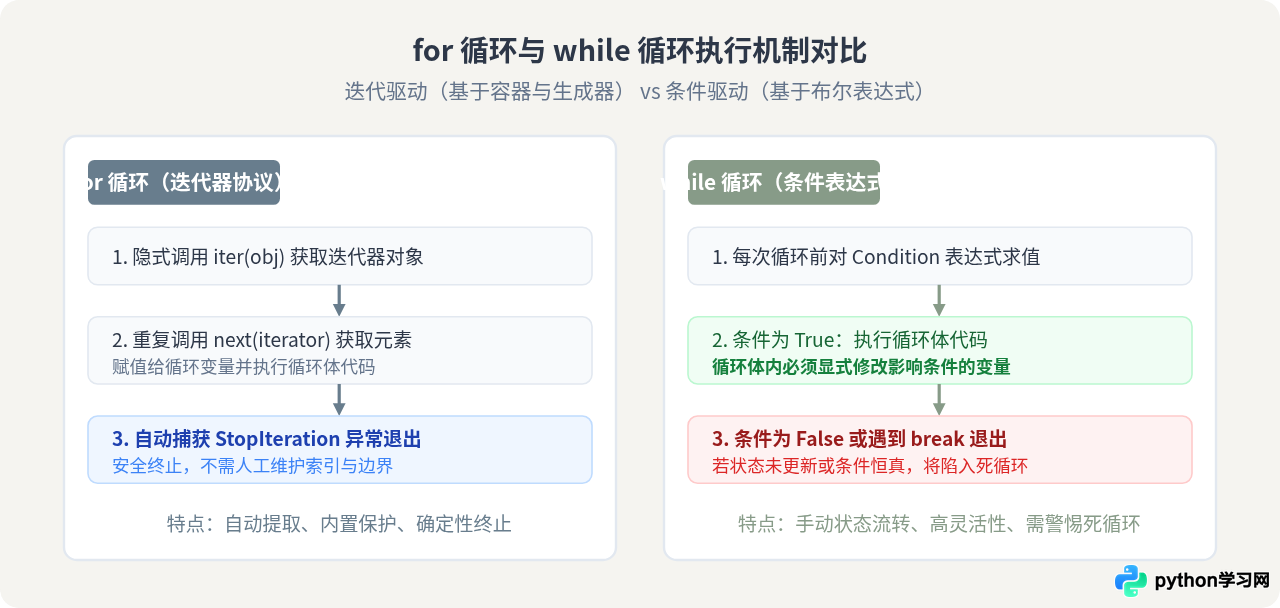
从底层设计来看,Python 的 for 循环与其他语言传统的“计数器型 for 循环”有显著差异。Python 的 for 并不依赖索引递增,而是严格遵循迭代器协议(Iterator Protocol)。当执行 for item in iterable 时,解释器首先调用 iter() 获取迭代器,随后反复调用 next() 提取元素,直到捕获 StopIteration 异常自动退出。
相对而言,while 循环直接依赖布尔逻辑判断。只要指定的条件计算结果为 True,代码块就会持续执行。退出条件的达成完全取决于循环体内对状态变量的更新或显式触发的 break 语句。
二、for 循环的使用方法与典型场景
当任务具备“已知集合”、“固定次数”或“针对序列的每个元素执行处理”的特征时,for 循环是绝对的首选。在 Python 中,不仅列表、元组、字符串支持遍历,字典、集合、生成器以及打开的文件对象均可直接用于 for 循环。
1. 遍历容器与解包赋值
处理列表或字典时,直接通过 for 提取元素是最符合 Python 惯用法(Pythonic)的写法:
# 遍历列表
fruits = ["apple", "banana", "cherry"]
for fruit in fruits:
    print(fruit)

# 遍历字典的键值对
user_roles = {"alice": "admin", "bob": "editor"}
for username, role in user_roles.items():
    print(f"用户: {username}, 权限: {role}")
2. 固定次数迭代与计数需求
如果需要执行特定次数的重复任务,无需定义额外的计数器变量,配合 range() 函数即可完成:
# 重复执行5次
for i in range(5):
    print(f"当前迭代序号: {i}")

# 需要同时获取元素及其索引时,使用 enumerate
colors = ["red", "green", "blue"]
for index, color in enumerate(colors, start=1):
print(f"第 {index} 个颜色是: {color}")enumerate() 可以彻底避免通过 range(len(items)) 配合索引访问元素的写法,代码更清晰,可读性更强。
三、while 循环的使用方法与典型场景
与 for 循环不同,while 循环不关心是否有现成的容器或固定长度,它只关心“当前的条件是否满足”。这使得 while 特别适合处理循环次数事先无法预知、依赖外部输入、等待网络响应或维持长期运行的场景。
1. 状态改变驱动的循环
例如,实现数值逼近、二分查找或动态扣减库存等算法,循环何时结束由计算结果实时决定:
# 模拟对半折半逼近
target = 100
step = 0
while target > 1:
    target /= 2
    step += 1
print(f"经过 {step} 次折半,剩余值为: {target}")
2. 守护式交互与无限轮询
在网络服务监听、命令行菜单交互以及轮询等待外部状态时,通常使用 while True 搭配条件 break 实现安全退出:
# 命令行交互式输入验证
while True:
    user_input = input("请输入正整数(输入 'q' 退出): ").strip()
    if user_input.lower() == 'q':
        print("用户主动退出程序")
        break
    if user_input.isdigit() and int(user_input) > 0:
        print(f"接收到有效输入: {user_input}")
        break
    print("输入格式错误,请重新输入!")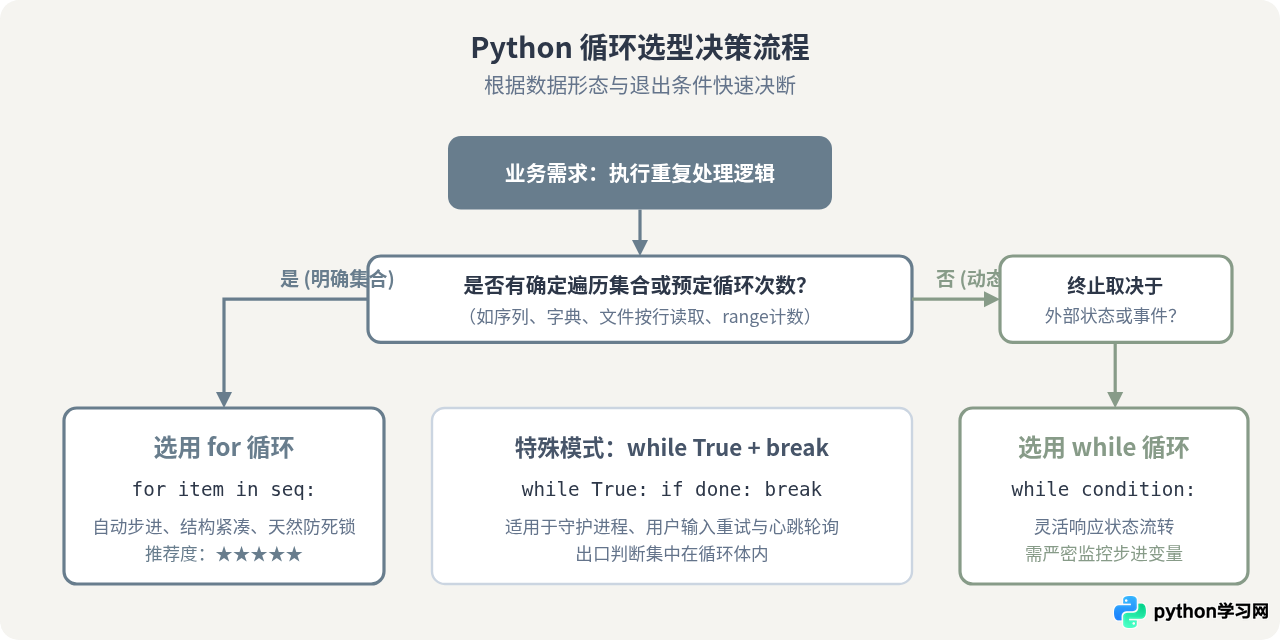
四、关键差异深度剖析与防坑指南
为了让选择依据更加清晰,我们可以从控制机制、变量生命周期和运行风险三个维度审视两者的差异:
- 变量维护方式:
for循环在进入每次迭代时会自动为目标变量赋值,迭代结束后变量依然保留在当前作用域,但其步进无需手动干预;while循环要求在进入循环前初始化变量,并在循环体内部明确写出递增或状态修改代码(如i += 1)。 - 代码简洁度与 Python 惯例:在绝大多数处理集合、列表推导式、生成器表达式的场合,
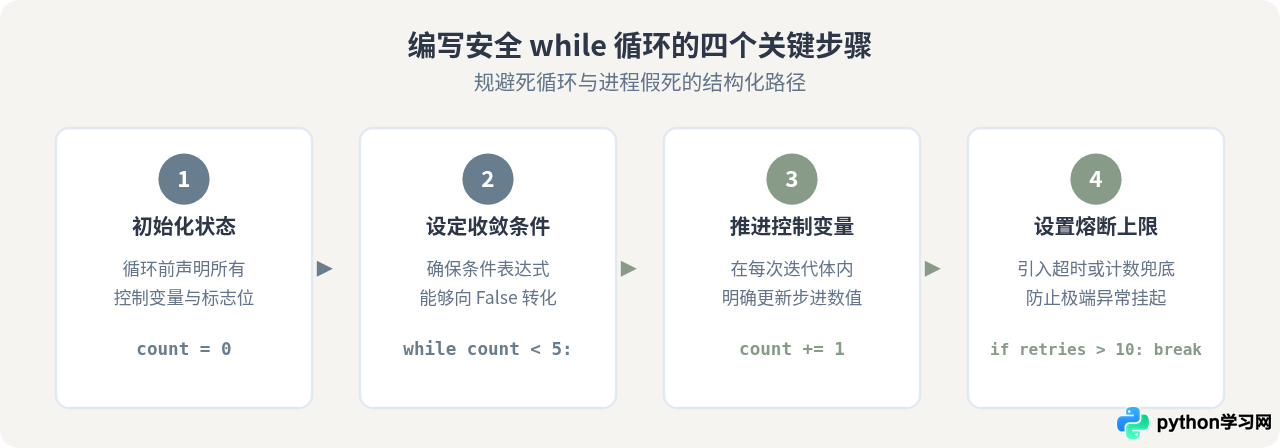
for循环不仅代码量少,而且意图直观。使用while遍历列表属于反模式,不仅冗长,而且容易因为漏写自增导致程序卡死。 - 死循环风险:
for循环遍历有限容器时,具有天然的停机保证;而while循环一旦逻辑分支漏掉了步进语句,或者外部事件未按预期发生,就会永久占用 CPU 资源。
for 循环内部通过 remove() 或 del 修改正在遍历的原列表长度。由于底层迭代器依赖内部游标位置,增删元素会导致索引偏移,引发漏跳元素或逻辑异常。如果需要过滤,请使用列表推导式 [x for x in lst if cond] 或遍历原列表的切片副本 for x in lst[:]:。
五、特征与选型总结矩阵
为了在实际编码中快速做出抉择,下表对两种循环的核心特征进行了全面归纳:
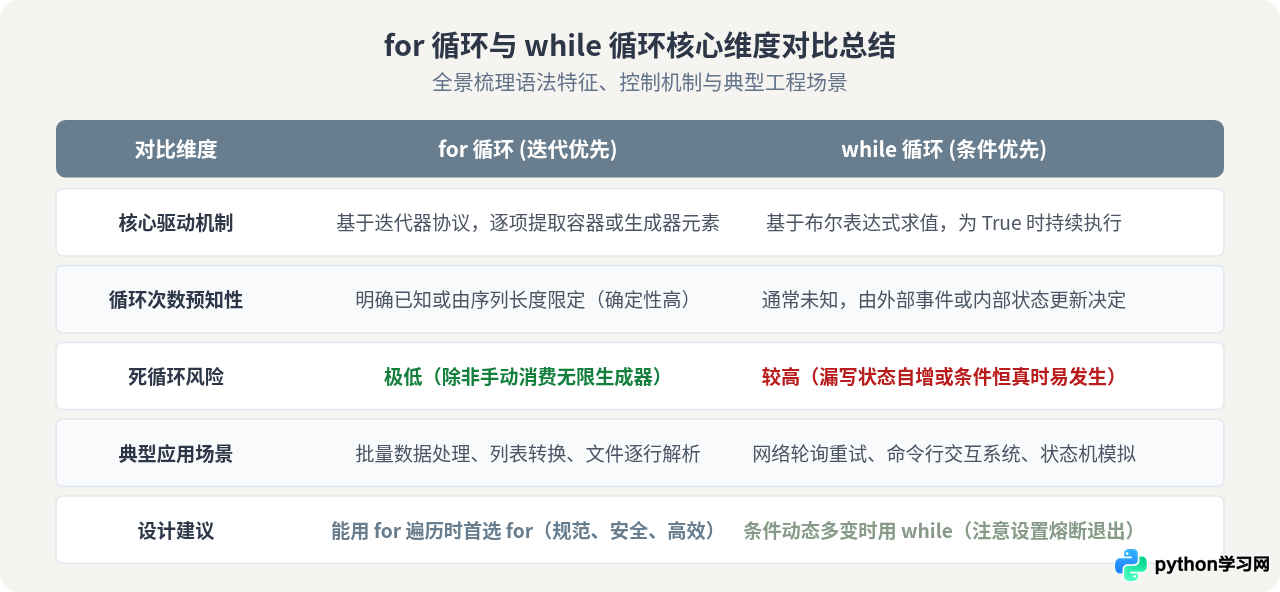
总结而言,在日常 Python 开发中,只要面对的是序列容器、范围计数或生成器对象,优先使用 for 循环,这能够最大限度利用 Python 简洁优雅的迭代器机制;只有当迭代没有现成边界、循环依赖外部信号或动态布尔计算时,才使用 while 循环,并务必在编写时同步确认状态步进与兜底退出保护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















