


Python导入SQL数据速度慢?批量插入与事务优化技巧

一、瓶颈根源:为什么逐条 INSERT 会极度缓慢?
初学者最常用的写入方式通常是在 Python 中遍历列表或数据表,每次调用 cursor.execute("INSERT INTO table VALUES (...)")。当数据量较小时(如数百条),这种写法并无明显异常;但一旦数据规模上升到数万条以上,总耗时可能从几秒飙升至数十分钟。
深入到底层交互机制,每次单条插入都会带来三重主要开销:
- 网络延迟与数据包往返(Round-Trip Time):每次
execute()都要经历一次完整的客户端发送数据、服务器接收并应答的过程。哪怕本地回路延迟只有 0.5 毫秒,10 万次独立交互仅仅在等待网络确认上就需要消耗 50 秒。 - 日志同步落盘(WAL / Redo Log fsync):默认情况下,大多数数据库处于自动提交(Auto-commit)状态。每次执行单条语句都会自动开启事务并立刻提交,数据库必须将重做日志强制写入物理磁盘以保证持久性(ACID)。机械硬盘或云盘的每秒 IOPS 限制直接决定了单条写入的吞吐上限。
- 语法解析与执行计划开销:数据库服务端必须为每一次接收到的独立 SQL 字符串进行语法词法解析、权限检查并生成执行计划。
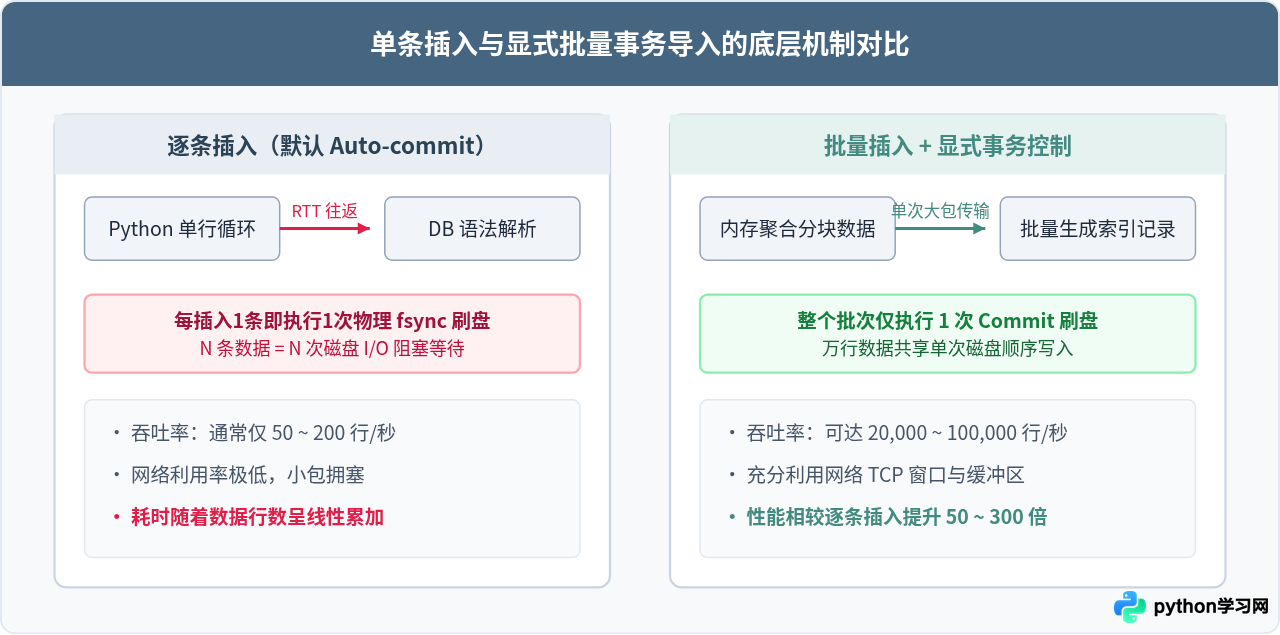
二、核心优化一:显式事务管理(禁用逐条自动提交)
提升导入速度的第一步也是成本最低的一步:关闭连接的 autocommit,改用手动提交事务。
在很多 Python 数据库驱动(如 sqlite3、psycopg2、pymysql)中,驱动虽然对某些命令有事务管理,但如果业务代码中显式或隐式开启了 autocommit=True,或者在每条语句后都调用 conn.commit(),数据库就会将每一行看作一个独立事务。
正确的做法是使用上下文管理器或显式 begin() / commit(),让一个事务包含数千至数万行数据:
import pymysql

conn = pymysql.connect(
    host='127.0.0.1', user='app_user', password='password',
    database='analytics_db', autocommit=False  # 明确关闭自动提交
)

cursor = conn.cursor()
try:
    sql = "INSERT INTO user_logs (user_id, action, create_time) VALUES (%s, %s, %s)"

    # 哪怕依然使用单条循环,放入单事务后速度也能提升10倍以上
    for row in dataset:
        cursor.execute(sql, row)

    conn.commit()  # 所有数据执行完毕后,执行唯一一次提交
except Exception as e:
    conn.rollback()  # 遇到异常时原子性回滚
    raise e
finally:
    cursor.close()
conn.close()三、核心优化二:重构批量插入语法
显式事务解决了磁盘频繁刷盘问题,但如果仍然在 Python 循环中反复调用 cursor.execute(),网络通信的往返次数依然没有减少。要解决网络开销,必须使用真正的批量语法。
1. 原生多值插入(Multi-row INSERT)
标准 SQL 允许在单个 INSERT 语句后追加多组 VALUES:
INSERT INTO user_logs (user_id, action, create_time) VALUES
  (101, 'login', '2026-10-21 10:00:00'),
  (102, 'click', '2026-10-21 10:00:01'),
  (103, 'logout', '2026-10-21 10:00:05');
这种语法将成百上千条记录打包为一条 SQL 语句发送给服务端,数据库仅需解析一次 SQL 语法树,网络交互次数也减少到原来的几千分之一。
2. cursor.executemany() 的底层行为差异
很多开发者直接调用 cursor.executemany(sql, rows),但发现不同驱动的表现截然不同:
- PyMySQL:默认情况下
executemany在内部仅仅是执行了一个 Python 层的for循环,逐条向服务端发送请求,性能提升有限。 - psycopg2 (PostgreSQL):
executemany同样是逐条发送;但在psycopg2.extras中提供了execute_batch和execute_values,其中execute_values才是真正组装成多值 SQL 发送,性能相差数倍。 - SQLAlchemy:在 2.0 版本中对 bulk 插入进行了大量优化,底层会根据连接驱动自动启用优化的批处理模式。
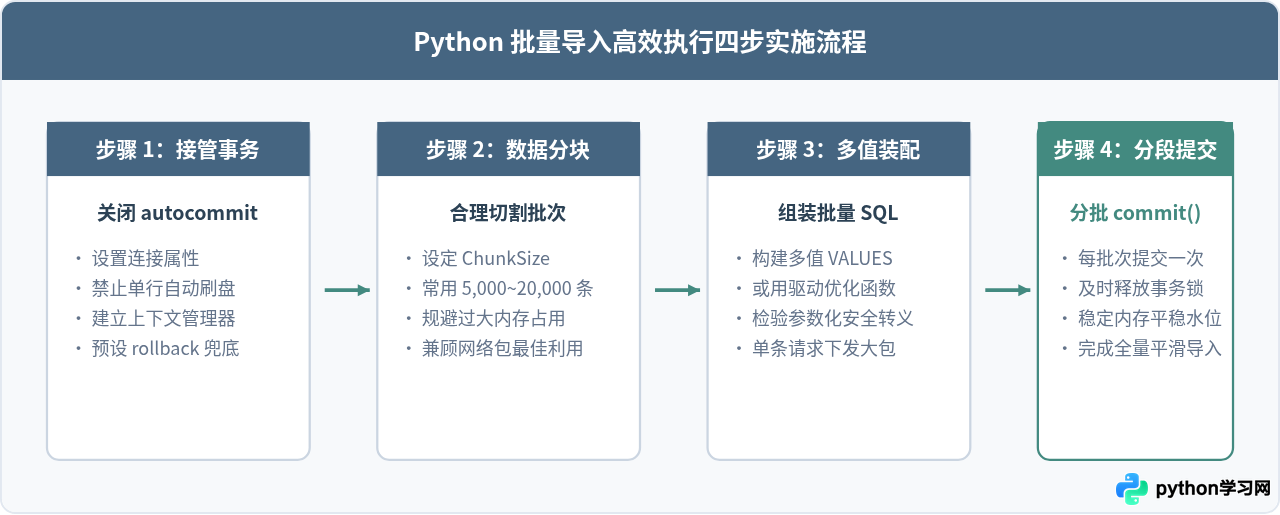
四、主流方案完整代码示例
1. 使用 PostgreSQL 的 psycopg2.extras.execute_values
在连接 PostgreSQL 时,官方推荐的最高效批处理工具是 execute_values,它会自动将参数元组列表重写为高吞吐的多值 SQL 语法:
import psycopg2
from psycopg2.extras import execute_values

def bulk_insert_postgres(data_rows, chunk_size=10000):
    conn = psycopg2.connect("dbname=analytics user=postgres host=127.0.0.1 password=secret")
    cursor = conn.cursor()

    insert_query = """
    INSERT INTO access_records (ip_address, endpoint, response_time, created_at)
    VALUES %s
    """

    try:
        # 按指定大小分块执行
        for i in range(0, len(data_rows), chunk_size):
            chunk = data_rows[i:i + chunk_size]
            execute_values(cursor, insert_query, chunk, page_size=chunk_size)
            conn.commit()  # 每个分块提交一次
            print(f"成功导入第 {i + len(chunk)} 行数据")
    except Exception as err:
        conn.rollback()
        raise err
    finally:
        cursor.close()
        conn.close()
2. 使用 Pandas 的 to_sql(配合 method='multi')
在数据分析与清洗场景中,大部分数据最终沉淀在 Pandas DataFrame 中。很多人直接调用 df.to_sql('table_name', engine),发现速度奇慢无比。
这是因为默认情况下,Pandas 会将 DataFrame 中的每一行转化为单个 INSERT 语句发送。只需要调整两个关键参数:chunksize 与 method='multi',导入速度即可发生质的飞跃:
import pandas as pd
from sqlalchemy import create_engine

engine = create_engine("mysql+pymysql://user:pwd@127.0.0.1:3306/db_name")

df = pd.DataFrame(large_data_dict)

# 关键参数:
# chunksize=10000:控制每次写入批次,防止内存撑爆
# method='multi':告诉 SQLAlchemy 将单批次的多行合并为单个 INSERT INTO ... VALUES (...), (...) 语句
df.to_sql(
    name='analytics_result',
    con=engine,
    if_exists='append',
    index=False,
    chunksize=10000,
    method='multi'
)
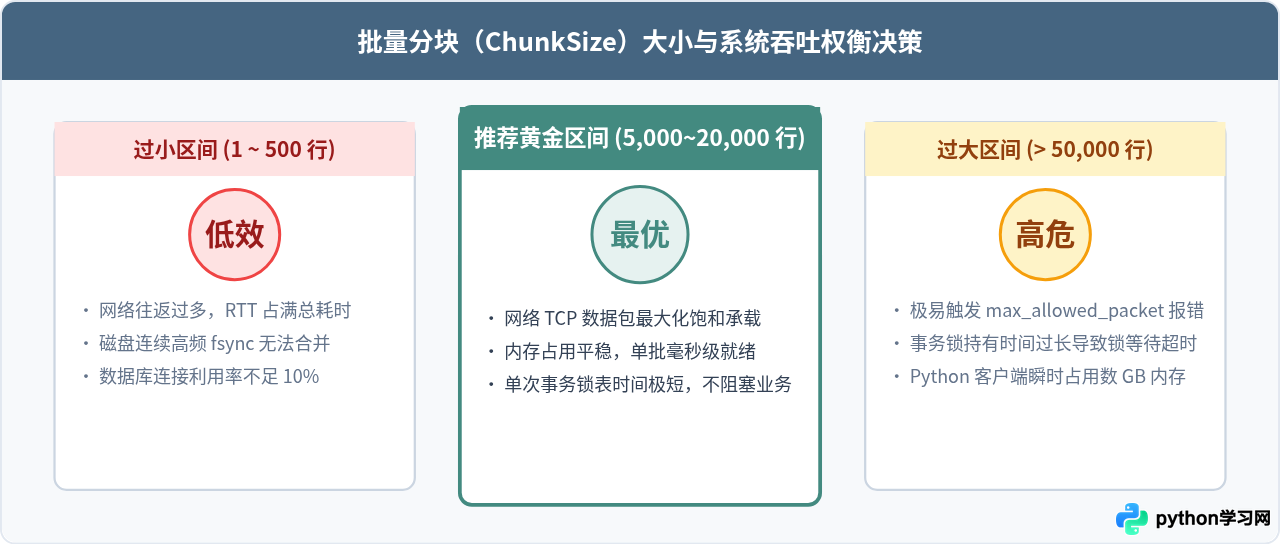
五、批次大小(ChunkSize)的选择与权衡
很多开发者容易走向另一个极端:既然单批越大越快,那是否把 100 万条数据打包进一个单一的 INSERT 语句中最好?
答案显然是否定的。批次过大会迅速触发一系列新的瓶颈:
- 数据库数据包大小上限:MySQL 默认的
max_allowed_packet通常为 16MB 或 64MB。若一次性组装的数据包超过该值,服务端会直接拒绝连接并抛出PacketTooBigException。 - SQL 占位符数量上限:SQLite 对单条 SQL 中的参数数量有硬性上限(早期版本为 999,后续版本为 32766);如果表有 10 个字段,每批最多只能放 3200 行。
- 客户端内存峰值:在 Python 内存中维持一个庞大的 SQL 字符串与海量参数对象,会造成瞬时内存激增,甚至引发 OOM。
六、极致吞吐场景:使用数据库原生文件导入命令
当数据量达到千万级以上,即使使用多值批量插入,SQL 解析和网络传输仍会占据一定的时间。若追求极致性能,最佳路径是绕过 SQL 语法层,直接利用数据库底层的二进制/文本批量流导入协议:
| 数据库类型 | 底层原生导入协议 | Python 对应实现 | 吞吐量量级(行/秒) |
|---|---|---|---|
| PostgreSQL | COPY FROM STDIN (BINARY / CSV) | cursor.copy_expert() / copy_from() |
150,000 ~ 400,000 |
| MySQL | LOAD DATA LOCAL INFILE | PyMySQL (local_infile=True) | 100,000 ~ 300,000 |
| SQLite | .import / 内存临时表合并 | PRAGMA synchronous = OFF | 80,000 ~ 200,000 |
| 通用 SQL | INSERT INTO ... VALUES (...),(...) | 分块显式事务 + 多值拼接 | 20,000 ~ 80,000 |
以下是使用 Python 配合 PostgreSQL copy_expert 将内存中的数据高速写入数据库的代表性模式:
import io
import psycopg2

def high_speed_copy_import(records, conn):
    # 在内存中构建轻量 CSV 流,无需在磁盘生成临时文件
    csv_buffer = io.StringIO()
    for row in records:
        csv_buffer.write("\t".join(map(str, row)) + "\n")
    csv_buffer.seek(0)

    with conn.cursor() as cursor:
        # 直接使用 COPY 命令,绕开 SQL 解析器与规则校验开销
        cursor.copy_expert(
            "COPY destination_table (col1, col2, col3) FROM STDIN WITH (FORMAT text)",
            csv_buffer
        )
    conn.commit()
七、优化总结与技术选型矩阵
面对 Python 向 SQL 导入数据慢的问题,不需要盲目更换高性能服务器或重构数据库集群,依据数据量级和代码依赖选择恰当的优化手段才是根本:
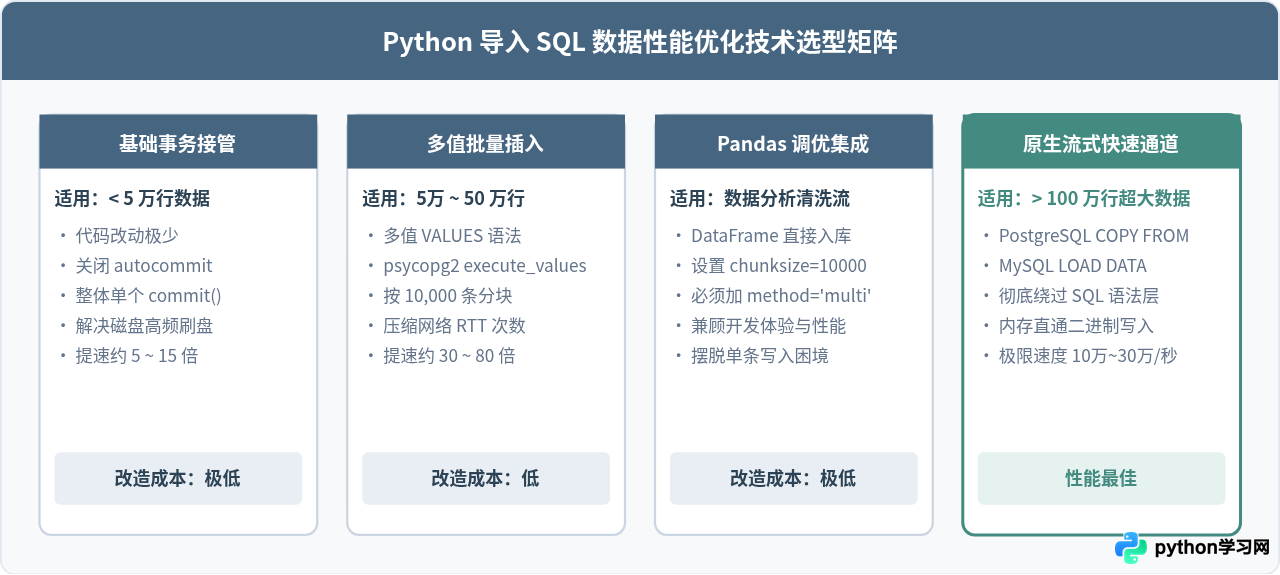
按照上述四个层级进行递进优化:普通业务代码首选显式事务 + 多值批量分块(ChunkSize 5000~20000),不仅能够消除网络 RTT 与频繁 fsync 磁盘瓶颈,还能确保业务在高并发下拥有良好的锁控制与异常回滚安全性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















