


Python爬虫数据持久化:将结果保存为CSV、JSON或MySQL的代码示例
本文详细介绍Python爬虫抓取数据后的三种主流持久化方式:CSV、JSON与MySQL数据库。包含结构设计、完整可运行代码、常见编码与事务问题避坑指南及技术选型对比。
网络爬虫将网页中的非结构化或半结构化数据提取出来后,下一步核心工作是数据持久化——将内存中的变量安全写入磁盘文件或数据库系统。本文针对初学者最常采用的表格文本(CSV)、树形文档(JSON)和关系型数据库(MySQL)三种存储载体,提供规范的存储流水线代码与常见问题解决方案。
一、爬虫数据持久化的整体流程与选型
在编写爬虫脚本时,数据生命周期通常包含四个阶段:发送请求并获取响应、解析提取字段、在内存中规整数据、执行持久化写入。不论最终落盘的目标是文本还是数据库,在内存中将单条记录封装为字典(dict)、将多条记录汇聚为列表(list[dict])是最稳妥的标准方式。
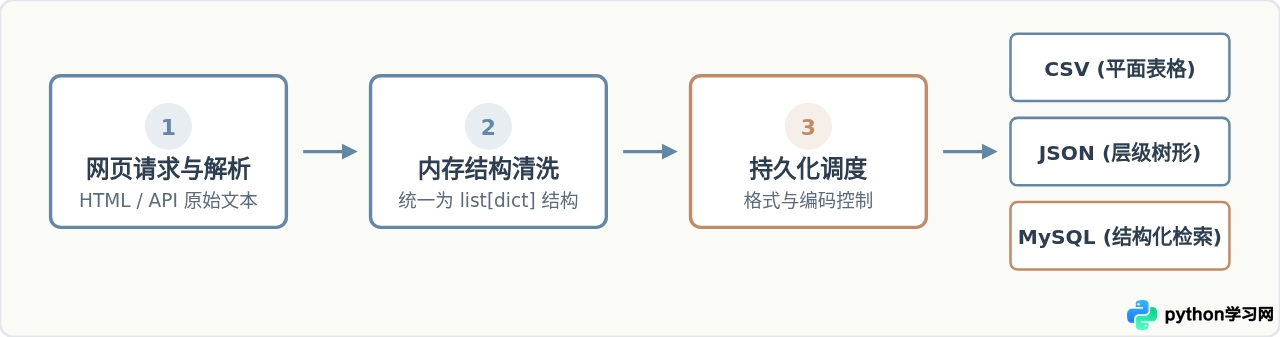
图 1:爬虫数据由抓取清洗到持久化落盘的标准流向架构
为了使下文的代码示例具备一致性与可对比性,我们假设爬虫已经从某个图书网页解析出三条图书字段,构成如下标准的结构化输入列表:
# 标准的内存样本数据,后文所有存储示例均复用此变量
crawled_books = [
    {
        "id": 101,
        "title": "Python网络爬虫实战",
        "price": 59.80,
        "tags": ["Python", "爬虫", "后端"],
        "summary": "详细讲解HTTP协议、网页解析与数据持久化流程。"
    },
    {
        "id": 102,
        "title": "MySQL核心技术与原理",
        "price": 89.00,
        "tags": ["数据库", "SQL", "存储"],
        "summary": "深入剖析事务隔离级别、B+树索引以及高并发优化。"
    },
    {
        "id": 103,
        "title": "自动化测试指南",
        "price": 45.50,
        "tags": ["测试", "DevOps"],
        "summary": "介绍单元测试、集成测试与CI/CD流水线搭建。"
    }
]
二、方案一:将数据保存为 CSV 文件
CSV(Comma-Separated Values)是一种平面二维表格格式,兼容 Microsoft Excel 与各种数据分析软件。在 Python 中,内置的 csv 模块即可满足读写需求,推荐使用 csv.DictWriter,它能够直接根据字典键与表头字段名对齐,避免因列顺序错乱导致的数据污染。
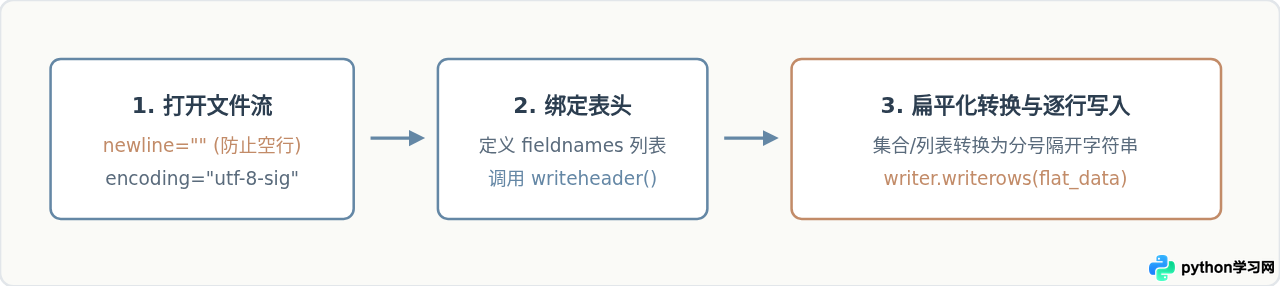
图 2:CSV持久化操作执行链与核心参数控制
2.1 完整操作代码
import csv

def save_to_csv(data: list[dict], filepath: str):
    """
    将爬虫数据写入CSV文件。
    注意:CSV不能直接存储嵌套数组或字典,写入前需将列表转换为扁平字符串。
    """
    if not data:
        print("无数据需要写入。")
        return

    # 1. 扁平化处理:将 tags 列表序列化为普通字符串
    flattened_data = []
    for item in data:
        row = item.copy()
        if isinstance(row.get("tags"), list):
            row["tags"] = "; ".join(row["tags"])  # 使用分号拼接列表元素
        flattened_data.append(row)

    # 2. 从首条数据中推导表头字段
    headers = list(flattened_data[0].keys())

    # 3. 写入文件(指定 utf-8-sig 防止 Excel 中文显示乱码,newline="" 避免出现空行)
    with open(filepath, mode="w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=headers)
        writer.writeheader()      # 写入列名行
        writer.writerows(flattened_data)  # 批量写入所有行

    print(f"成功将 {len(data)} 条数据保存至 CSV 文件: {filepath}")

# 运行持久化
save_to_csv(crawled_books, "books_output.csv")- 空行问题:在 Windows 平台下使用
open()写 CSV 时,如果不显式声明newline="",标准库每次换行会自动写入额外的\r,造成输出文件出现隔行空行。 - Excel 打开乱码:纯
utf-8编码的 CSV 在 Windows Excel 中经常出现中文乱码。使用utf-8-sig会在文件起始写入 BOM(Byte Order Mark)字符,提示 Excel 正确识别 UTF-8 字符集。 - 类型扁平化:CSV 仅支持一维文本,不支持复合数据类型。对于
tags这种数组,必须先通过"; ".join()或json.dumps()转换成单字段文本。
三、方案二:将数据保存为 JSON 文件
如果爬取的原始数据层级较深(包含嵌套字典、数组等树形结构),JSON(JavaScript Object Notation)是最自然的存储介质。Python 的内置模块 json 支持将内存结构序列化为文本文件。
3.1 完整操作代码
import json

def save_to_json(data: list[dict], filepath: str):
    """
    将原生爬虫结构保存为标准的格式化 JSON 文件。
    """
    # ensure_ascii=False 允许原生输出中文字符而非 \uXXXX 转义序列
    # indent=4 保持输出具备良好的可读排版
    with open(filepath, mode="w", encoding="utf-8") as f:
        json.dump(data, f, ensure_ascii=False, indent=4)

    print(f"成功将数据序列化保存至 JSON 文件: {filepath}")

# 运行持久化
save_to_json(crawled_books, "books_output.json")
若爬虫抓取的数据规模非常庞大(例如数十万条记录),使用单个完整的数组写入 JSON 文件会导致内存开销过高。此时推荐使用 JSON Lines(.jsonl) 格式,每抓取一条数据,向文件中追加写入一行紧凑的 JSON 字符串:
def save_to_jsonl(data: list[dict], filepath: str):
    """
    流式写入:每条数据占用独立一行,适合超大规模爬虫的断点续传与低内存写入。
    """
    with open(filepath, mode="a", encoding="utf-8") as f:
        for item in data:
            line = json.dumps(item, ensure_ascii=False)
            f.write(line + "\n")

    print(f"增量写入 JSON Lines 文件完成: {filepath}")

# 运行流式写入
save_to_jsonl(crawled_books, "books_stream.jsonl")- 转义字符:
json.dump()默认参数ensure_ascii=True,会将中文字符转义为\u4e2d\u6587。在处理中文抓取任务时,必须显式声明ensure_ascii=False。 - 不可序列化对象:若抓取的字段包含
datetime日期时间对象,必须先通过.strftime("%Y-%m-%d %H:%M:%S")转换为字符串,否则json.dump()会抛出TypeError: Object of type datetime is not JSON serializable。
四、方案三:将数据入库保存至 MySQL 数据库
当爬虫采集的数据需要频繁按条件查询、跨表关联、防重复入库或并发处理时,单机文件往往难以应对,关系型数据库 MySQL 是此时最标准的选择。在 Python 生态中,PyMySQL 库是纯 Python 实现的轻量数据库驱动,无需复杂的系统依赖即可快速部署。
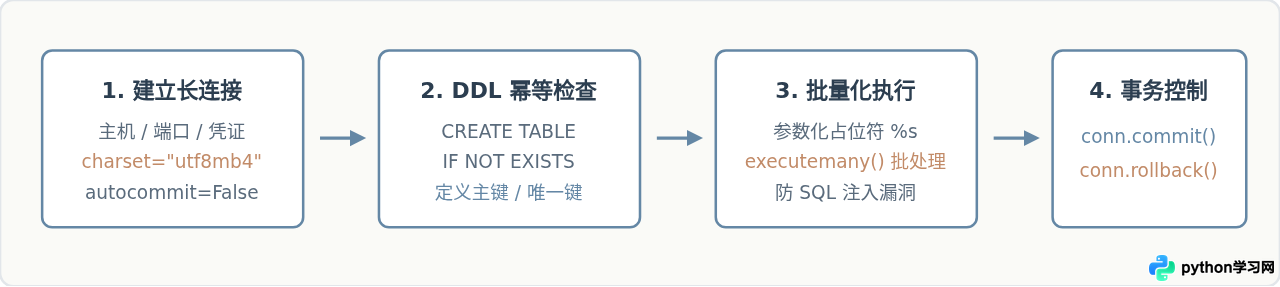
图 3:MySQL 数据库持久化安全交互与事务控制时序
4.1 前置环境依赖
在编写数据库入库逻辑前,需要使用 pip 安装驱动模块:
pip install pymysql4.2 完整操作代码
import json
import pymysql

# 数据库连接配置
DB_CONFIG = {
    "host": "localhost",
    "port": 3306,
    "user": "root",
    "password": "your_password",
    "database": "crawler_db",
    "charset": "utf8mb4",
    "cursorclass": pymysql.cursors.DictCursor
}

def init_table(cursor):
    """
    初始化数据表结构:包含主键去重、字符集与存储引擎声明
    """
    create_table_sql = """
    CREATE TABLE IF NOT EXISTS `tbl_crawled_books` (
        `book_id` INT PRIMARY KEY,
        `title` VARCHAR(255) NOT NULL,
        `price` DECIMAL(8, 2) NOT NULL,
        `tags` JSON NULL,
        `summary` TEXT NULL,
        `created_at` TIMESTAMP DEFAULT CURRENT_TIMESTAMP
    ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
    """
    cursor.execute(create_table_sql)

def save_to_mysql(data: list[dict]):
    """
    将爬虫数据批量存入 MySQL 数据库,支持去重更新与事务回滚。
    """
    if not data:
        return

    # 1. 整理入库元组数据(列表或复合对象需转为合法字符串或 JSON)
    records_to_insert = []
    for item in data:
        record = (
            item["id"],
            item["title"],
            item["price"],
            json.dumps(item.get("tags", []), ensure_ascii=False),  # MySQL JSON 列
            item.get("summary", "")
        )
        records_to_insert.append(record)

    # 2. 插入逻辑(使用 ON DUPLICATE KEY UPDATE 实现重复数据自动覆盖更新)
    insert_sql = """
    INSERT INTO `tbl_crawled_books` (`book_id`, `title`, `price`, `tags`, `summary`)
    VALUES (%s, %s, %s, %s, %s)
    ON DUPLICATE KEY UPDATE
        `title` = VALUES(`title`),
        `price` = VALUES(`price`),
        `tags` = VALUES(`tags`),
        `summary` = VALUES(`summary`);
    """

    conn = None
    try:
        # 3. 建立连接并获取游标
        conn = pymysql.connect(**DB_CONFIG)
        with conn.cursor() as cursor:
            init_table(cursor)
            # 批量执行数据入库
            affected_rows = cursor.executemany(insert_sql, records_to_insert)

        # 4. 显式提交事务
        conn.commit()
        print(f"数据入库成功,共处理影响行数: {affected_rows}")

    except pymysql.MySQLError as e:
        # 异常时必须回滚,防止局部脏数据产生
        if conn:
            conn.rollback()
        print(f"MySQL 写入异常,已执行回滚。错误详情: {e}")
    finally:
        # 5. 关闭物理连接释放资源
        if conn and conn.open:
            conn.close()

# 运行数据库写入(请确保本地MySQL已创建 crawler_db 数据库)
# save_to_mysql(crawled_books)- SQL 注入与占位符:切勿使用 Python 字符串拼接(如
f"INSERT ... VALUES ('{title}')")构造 SQL,这极易引发注入风险或因字符串中含有单引号导致语法报错。必须严格使用参数化形式传递数据(%s作为参数占位符)。 - 忘记 Commit:PyMySQL 默认关闭自动提交(autocommit=False)。执行
executemany()后如果不调用conn.commit(),数据只存在于事务缓存中,脚本退出后数据库中依然是空的。 - 必须使用 utf8mb4:MySQL 中的
utf8仅支持最多 3 字节的字符,遇到爬取的 Emoji 表情符或生僻字会直接抛出Incorrect string value异常中断程序。因此表、数据库与连接参数中必须统一指定为utf8mb4。
五、三种持久化方式的对比与总结
在实际爬虫工程中,持久化方式的选择取决于采集规模、数据结构复杂度与后续应用场景:
| 持久化媒介 | 典型应用场景 | 优势 | 局限与注意事项 |
|---|---|---|---|
| CSV | 小规模爬虫、一次性分析任务、需要直接在 Excel 中交付或汇报数据。 | 通用性强,文件直观可直接双击打开;写入性能开销极低。 | 不支持复杂的层级嵌套结构;字段包含英文逗号或换行时需严格转义。 |
| JSON / JSONL | API 爬取、半结构化数据、字段格式动态多变或层级较深的数据抓取。 | 原生支持嵌套字典和数组;JSONL 格式支持免加载大文件的高速追加。 | 大文件全量读取较占内存;不便于非技术人员直观审查与表格化查看。 |
| MySQL | 长期运行的采集系统、百万级以上数据、多线程/分布式爬虫断点去重。 | 支持事务保证、高并发并发写、高效的多条件复杂检索与唯一键自动排重。 | 需要提前规划表结构与字段类型;需要维护数据库实例,部署成本相对较高。 |
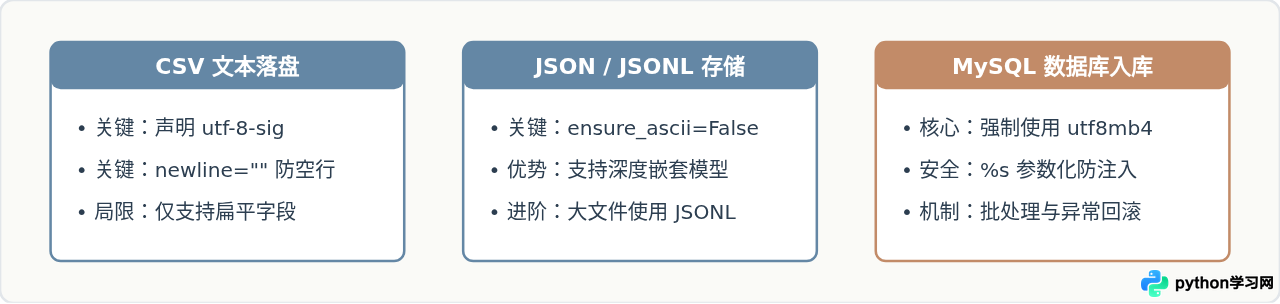
图 4:Python 爬虫三种主流持久化核心配置与技术特征总结
在设计一个稳健的爬虫程序时,建议统一在解析层先输出规范的字典结构。如果任务为临时抓取或快速检验,可优先采用 CSV 或 JSON;若需要长期保持高可用增量抓取,则应建立好 MySQL 表结构并配合事务机制进行批量落盘。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















