


Python深拷贝与浅拷贝的区别:修改副本为何影响原对象

从一个典型的修改异常切入
很多开发者在日常编写业务逻辑时,都会遇到类似这样的怪事:为了保存配置初始值或列表快照,特地调用了 copy() 方法生成一个新列表。然而在后续对副本做局部调整时,原本打算作为备份的原始数据竟然不知不觉被一同篡改了:
import copy

origin_data = [["item-1", "item-2"], 100]
shallow_copy = origin_data.copy()

# 尝试在副本中为第一个元素追加一项
shallow_copy[0].append("item-3")

print("副本内容:", shallow_copy)
# 输出: 副本内容: [['item-1', 'item-2', 'item-3'], 100]

print("原对象内容:", origin_data)
# 意外输出: 原对象内容: [['item-1', 'item-2', 'item-3'], 100]
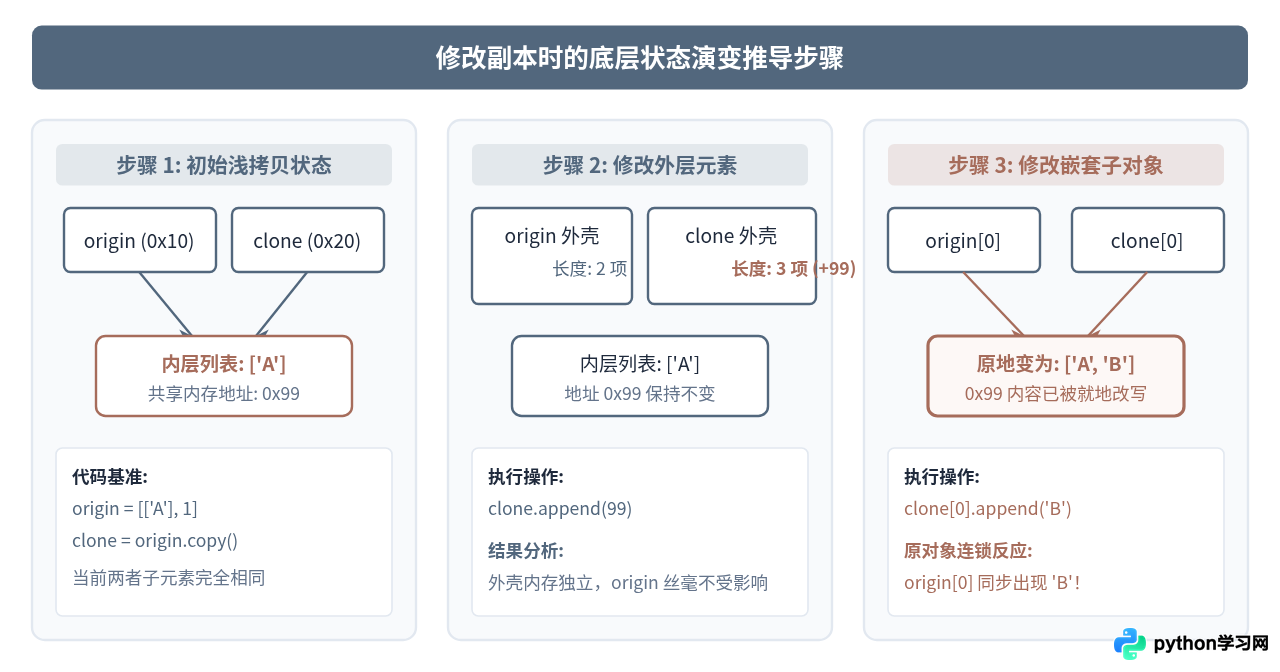
明明没有直接操作 origin_data,原对象的第一个子列表却凭空多出了 item-3。而更有趣的是,如果接下来对外层元素执行修改,比如 shallow_copy.append(200),原对象却又完全不受影响。这种“有时独立、有时绑定”的现象,常常让人误以为 Python 的拷贝机制不稳定。要理清背后的逻辑,必须看清变量在内存中到底是如何被组织与引用的。
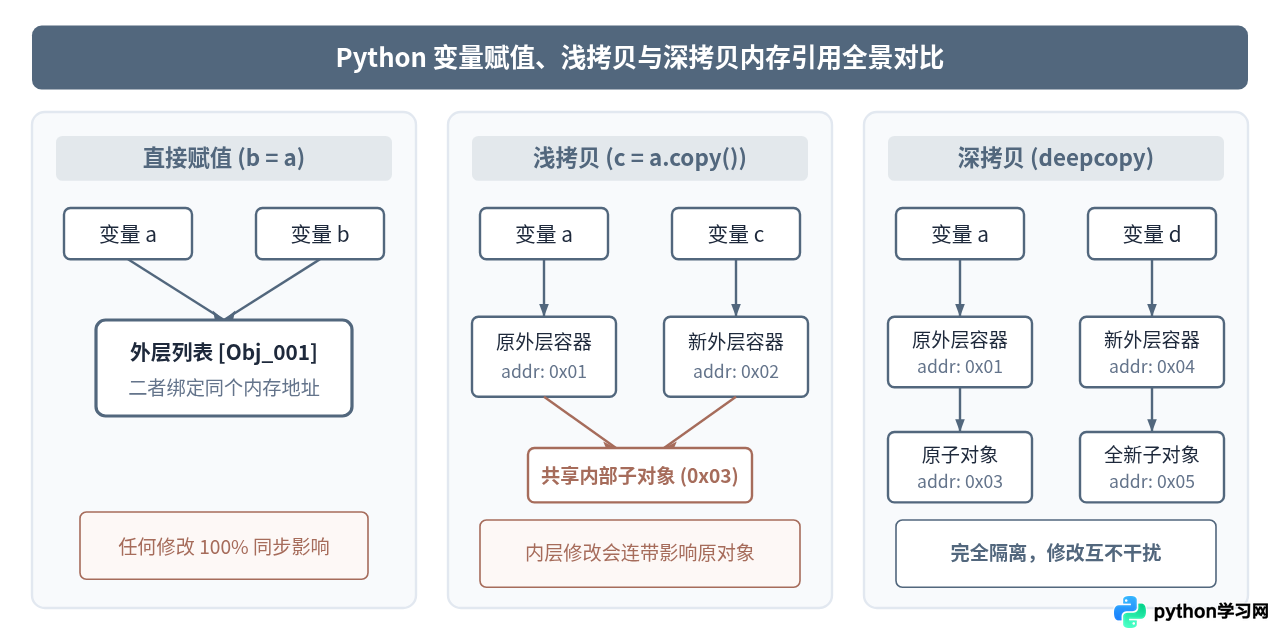
内存视角:浅拷贝究竟“拷贝”了什么
在 Python 的对象模型中,变量名本质上是一张“便利贴”,贴在堆内存中具体的对象上。一个复合型对象(例如 list 或 dict)本身并不把子元素的内容直接塞在外壳里,而是保存了一组指向各子元素内存地址的指针。
理解浅拷贝的关键在于:浅拷贝只开辟了一块新内存来存放新的外层容器,然后把原容器里记录的一串内存指针原样照抄了进去。我们借助 Python 内置的 id() 函数打印出各自的真实内存地址,便能看得一清二楚:
origin = [["sub_item"], 10]
clone = origin.copy()

print("外层容器地址对比:")
print("origin ID:", id(origin))
print("clone  ID:", id(clone))
# 输出结果不同,证实外壳确为两块独立内存

print("\n内部嵌套元素地址对比:")
print("origin[0] ID:", id(origin[0]))
print("clone[0]  ID:", id(clone[0]))
# 输出结果完全一致!说明内部列表根本没被复制由此可见,clone 虽然拥有自己独立的外壳地址,但它的第一项 clone[0] 所记录的地址与 origin[0] 完完全全重合。既然两个变量名最终指引到了堆内存中的同一块连续空间,那么针对该空间发起的任何原地修改操作(如 append、pop、键值赋值),自然会在两个变量的视角下同时展现出来。
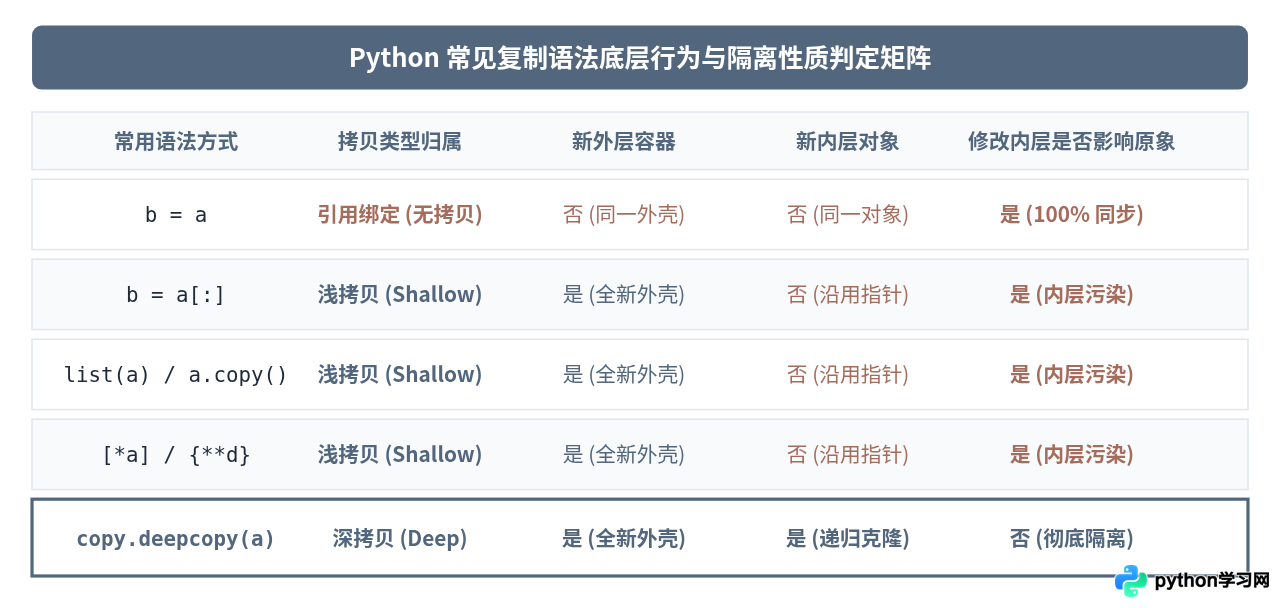
常见的浅拷贝陷阱:你以为的“全新对象”
很多开发者之所以掉入浅拷贝的坑,是因为 Python 提供了很多看似在“重新生成数据”的便捷语法,而这些语法无一例外都属于浅拷贝。如果不加留心,很容易在不知情中写下隐蔽的共享引用:
- 列表完整切片:
new_list = old_list[:]虽然创建了一个新列表容器,但内部子元素地址全部未变。 - 工厂函数构造:
new_list = list(old_list)或new_dict = dict(old_dict),同样仅仅遍历了旧容器并把指针插入新容器。 - 对象的 copy() 方法:如
list.copy()、dict.copy()或set.copy(),标准库明确将其定义为 Shallow Copy。 - 解构推导或星号展开:
[*old_list]或{**old_dict},语法现代化且书写优雅,但本质依然是逐项复制指针引用。
深拷贝的实现原理与使用代价
当业务必须确保“无论副本如何变动,原对象必须纹丝不动”时,唯一的标准答案是引入 Python 标准库提供的 copy.deepcopy()。深拷贝绝不是简单的两层循环,它在底层包含一套非常健壮的对象树遍历机制:
import copy

config_origin = {
    "server": "127.0.0.1",
    "ports": [8080, 8081],
    "env": {"DEBUG": True}
}

config_snapshot = copy.deepcopy(config_origin)

# 随意修改嵌套对象
config_snapshot["ports"].append(9000)
config_snapshot["env"]["DEBUG"] = False

print("原配置 ports:", config_origin["ports"])
# 稳定输出: [8080, 8081] - 完全未被修改!

print("原配置 env:", config_origin["env"])
# 稳定输出: {'DEBUG': True} - 保持原始状态!
深拷贝的核心机制主要体现在两点:
- 递归构造:遇到字典、列表、集合或自定义类实例等可变对象时,深拷贝会逐层深入下去,为每一个层级都调用构造逻辑生成全新实例。
- 备忘录字典(memo 机制):为了防止对象内部存在相互引用或循环引用(例如
node.next = node)导致递归进入无限死循环,deepcopy会维护一个以源对象id()为键的内部字典memo。如果当前对象已经被拷贝过,直接复用已创建的对应副本,保证拓扑结构与安全性。
deepcopy 会带来可观的 CPU 与内存负担。
工程实践中的选型路径与总结
在实际编码中,判断该用浅拷贝还是深拷贝,不应凭借直觉猜测,而应根据数据结构的特征和业务流转要求建立清晰的决策路径:
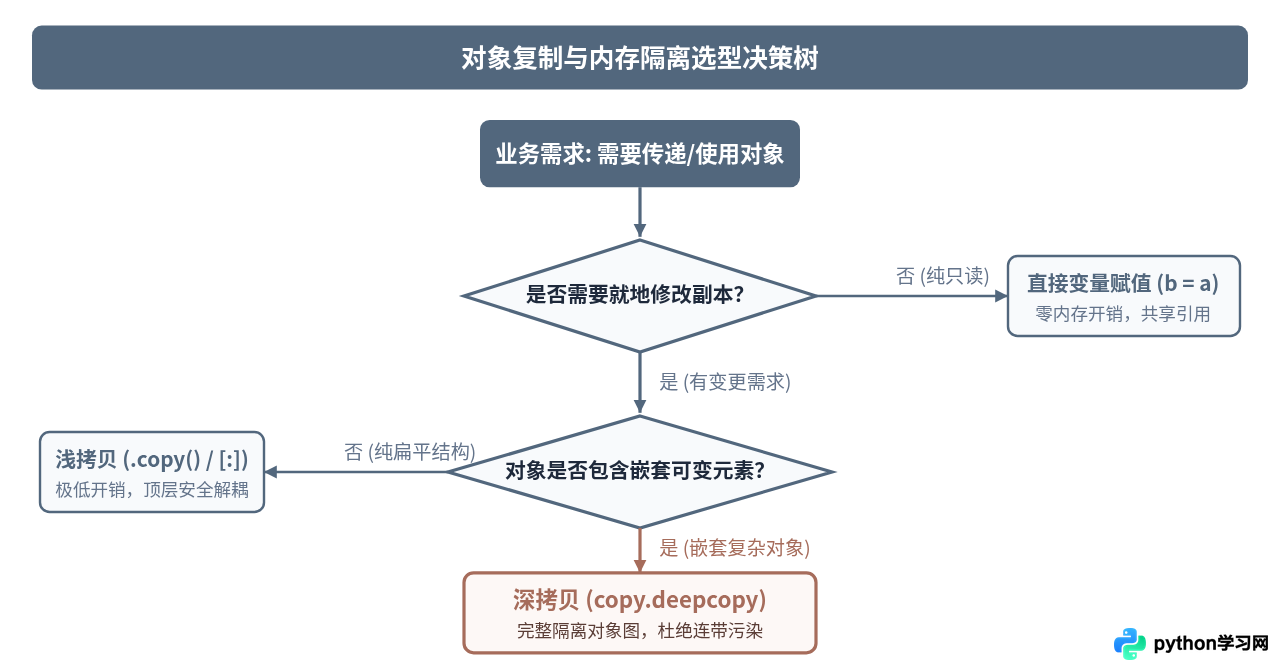
归纳起来,解决“修改副本影响原对象”的根本策略非常单纯:
- 如果只是处理纯扁平列表(如数字、字符串组成的列表),
list.copy()或切片[:]已经足够安全且高效。 - 只要数据结构中嵌套了二级以上的列表、字典或自定义数据模型,且下游逻辑会对内层数据做赋值或追加,就必须坚决使用
copy.deepcopy()。 - 对于无需修改的场景,尽量将内层可变容器设计为不可变元组
tuple或冻结数据类,从类型层面直接封死原地篡改的可能性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















