


从Naive RAG到Advanced RAG:模块化检索与查询转换技术详解

在构建基于大语言模型的应用时,简单的“检索-生成”流程往往难以应对复杂查询。Naive RAG(朴素检索增强生成)虽然实现简单,但在面对多跳推理、模糊指代或长尾知识时,常出现检索内容不相关或缺失关键上下文的问题。Advanced RAG 通过引入模块化的预处理和后处理机制,显著提升了系统的鲁棒性。其中,查询转换技术作为核心优化手段,能够将用户原始问题转化为更适合向量数据库检索的形式。本文将演示如何通过模块化设计,将基础 RAG 升级为支持查询重写的高级架构,并直观展示检索效果的提升。
要实现这一升级,首先需要理解 Advanced RAG 的核心差异:它不再是一个黑盒管道,而是由索引、检索器、重排序器和生成器等独立模块组成的可插拔系统。准备条件包括安装 Python 环境、LlamaIndex 库以及一个可用的向量数据库后端(如 Chroma 或 FAISS)。确保已准备好包含领域知识的文本数据集,用于构建索引。
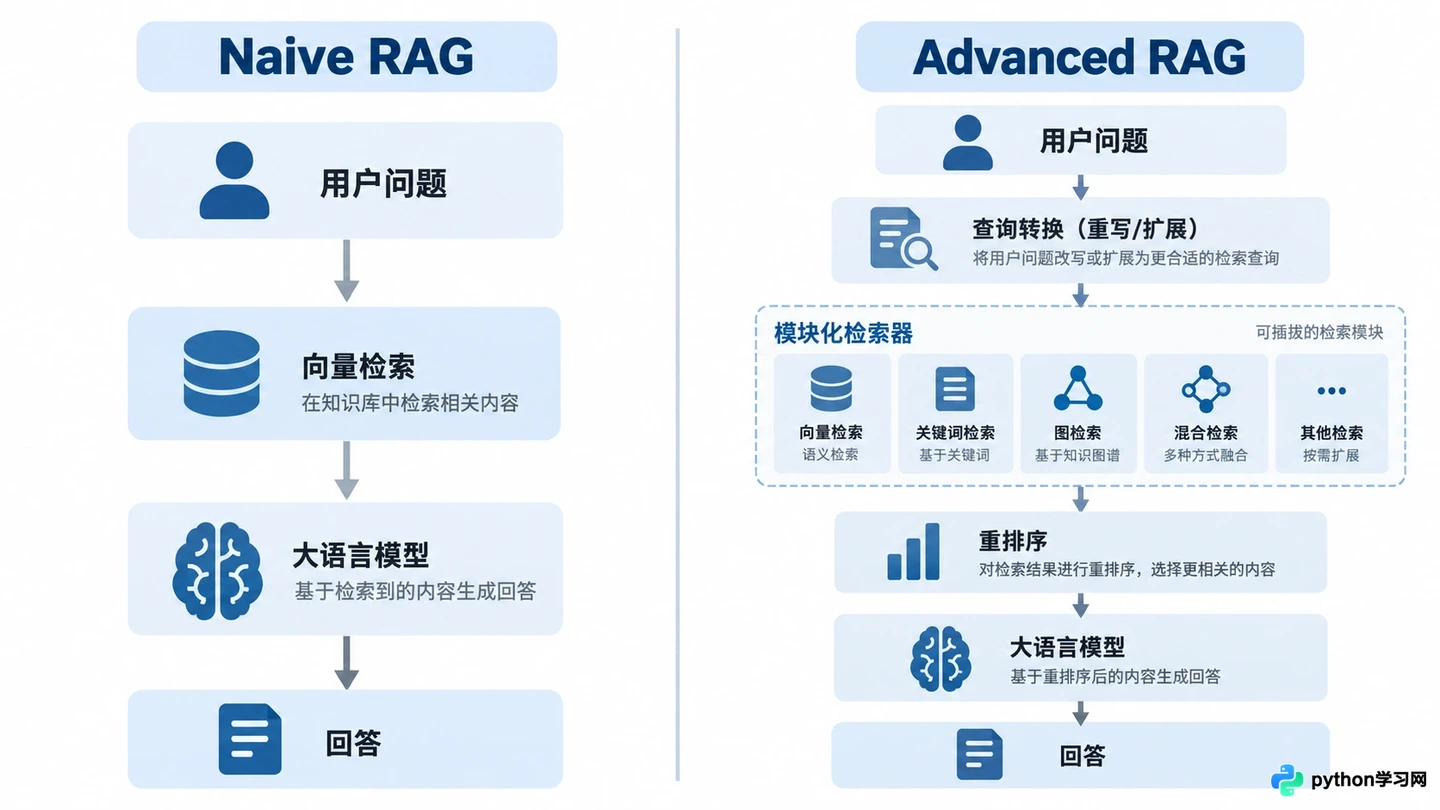
Naive RAG与Advanced RAG架构对比示意图
1. 构建基础 Naive RAG 管道
首先建立一个基准线,使用最简配置实现 RAG 流程。这有助于后续对比优化效果。导入必要的库,加载示例文档,并创建简单的向量索引。
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.llms.openai import OpenAI
from llama_index.embeddings.openai import OpenAIEmbedding

# 加载文档
documents = SimpleDirectoryReader("./data").load_data()

# 创建嵌入模型和LLM
embed_model = OpenAIEmbedding(model="text-embedding-ada-002")
llm = OpenAI(model="gpt-3.5-turbo")

# 构建索引
index = VectorStoreIndex.from_documents(
    documents,
    embed_model=embed_model
)

# 创建查询引擎
query_engine = index.as_query_engine(llm=llm)
此时,直接使用 query_engine.query("公司的报销政策是什么?") 即可得到回答。但在实际测试中,如果用户提问“怎么申请差旅费?”,由于语义匹配偏差,可能无法精准命中包含“报销政策”的文档片段。这就是 Naive RAG 的局限性:它严重依赖原始查询与文档片段的向量相似度。
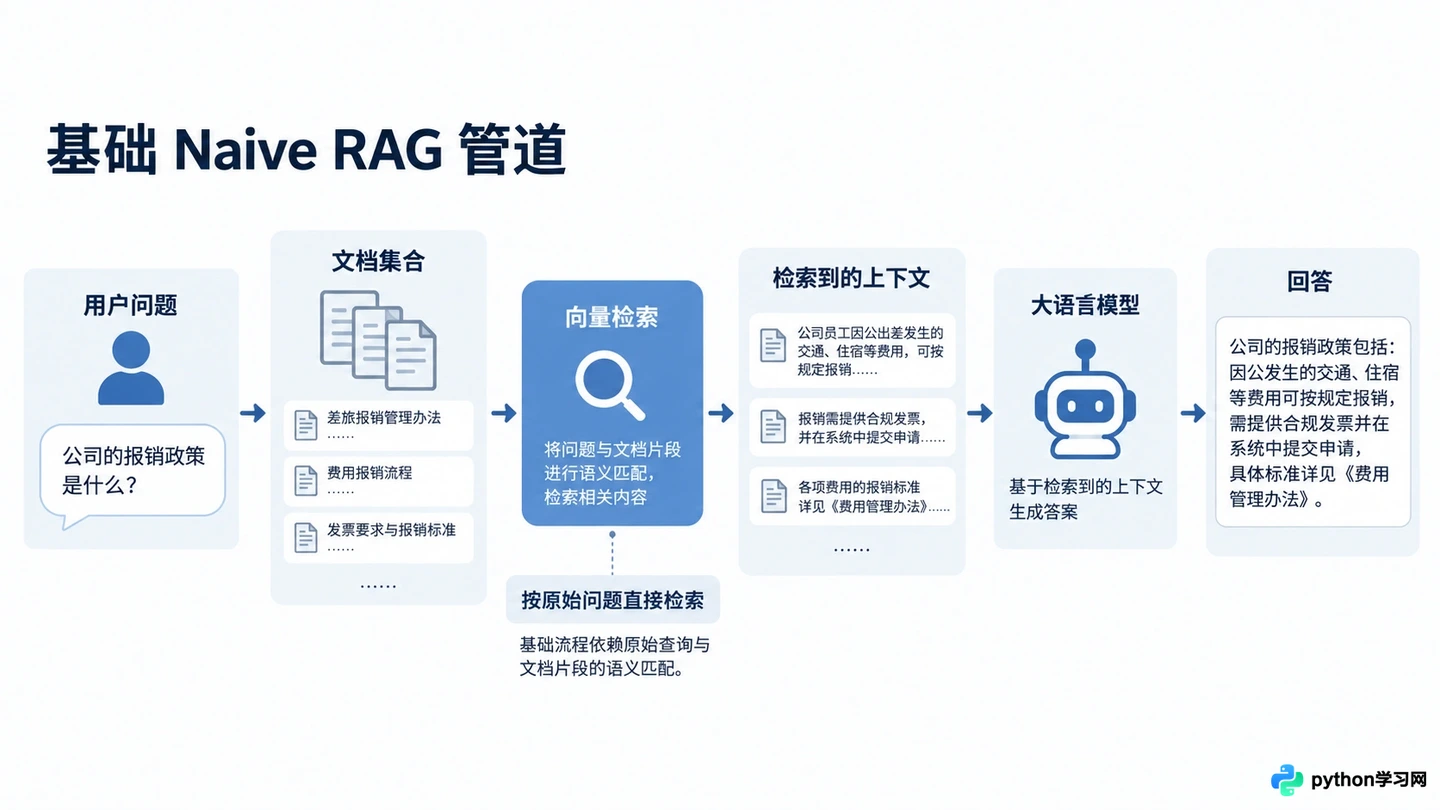
1. 构建基础 Naive RAG 管道
2. 引入模块化检索组件
Advanced RAG 的第一步是将检索过程拆解。我们不再依赖默认的查询引擎,而是手动组装检索器(Retriever)和响应合成器(Response Synthesizer)。这种解耦允许我们在中间插入自定义逻辑。
from llama_index.core.retrievers import VectorIndexRetriever
from llama_index.core.query_engine import RetrieverQueryEngine
from llama_index.core.response_synthesizers import CompactAndRefine

# 定义检索器
retriever = VectorIndexRetriever(
    index=index,
    similarity_top_k=5  # 返回前5个相关节点
)

# 定义响应合成器
synthesizer = CompactAndRefine()

# 组装查询引擎
advanced_query_engine = RetrieverQueryEngine(
    retriever=retriever,
    response_synthesizer=synthesizer
)
通过这种方式,我们可以单独调整 similarity_top_k 参数,观察不同召回数量对最终答案的影响。更重要的是,这个 retriever 对象现在成为了一个独立的模块,可以接受额外的预处理步骤。
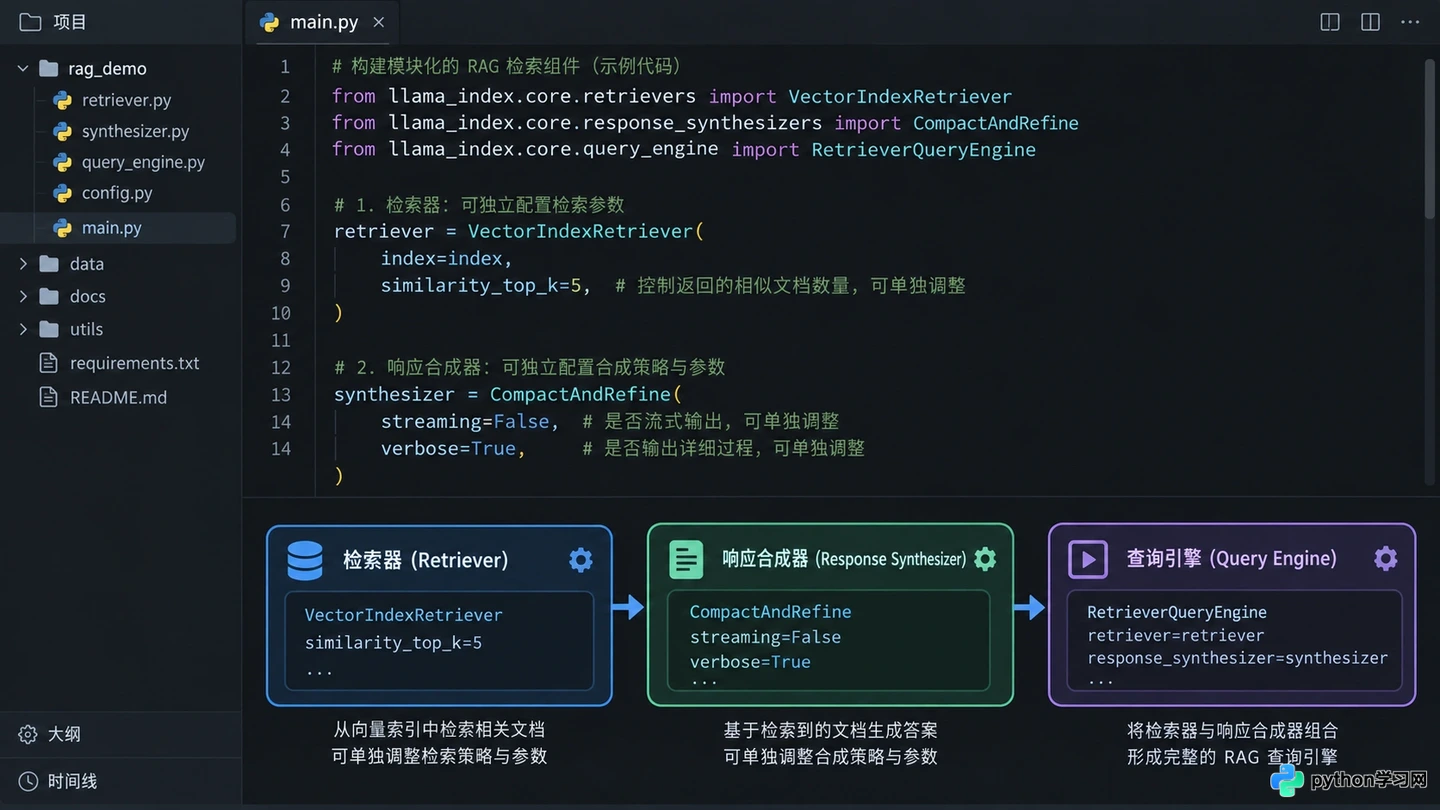
模块化检索组件代码实现界面
3. 实施查询转换技术
查询转换(Query Transformation)是 Advanced RAG 的关键优化点。其核心思想是不直接使用用户原始问题去检索,而是先通过 LLM 对问题进行重写、扩展或分解。常见的策略包括 HyDE(假设性文档嵌入)和 Step-back Prompting(回退提示)。
这里演示一种简单的查询重写策略:让 LLM 根据原始问题生成一个更具体、包含更多关键词的搜索查询。
from llama_index.core.indices.query.query_transform.base import StepDecomposeQueryTransform
from llama_index.core.query_engine import TransformQueryEngine

# 定义查询转换函数
step_decompose_transform = StepDecomposeQueryTransform(
    llm=llm,
    verbose=True
)

# 创建转换查询引擎
transform_query_engine = TransformQueryEngine(
    query_engine=advanced_query_engine,
    query_transform=step_decompose_transform
)
当用户输入“怎么申请差旅费?”时,StepDecomposeQueryTransform 会先调用 LLM 分析该问题,可能将其转换为“公司差旅费报销流程及申请材料要求”。这个新生成的查询在向量空间中与文档内容的匹配度更高。注意观察控制台输出,可以看到转换后的查询语句,这是调试和优化提示词的重要依据。
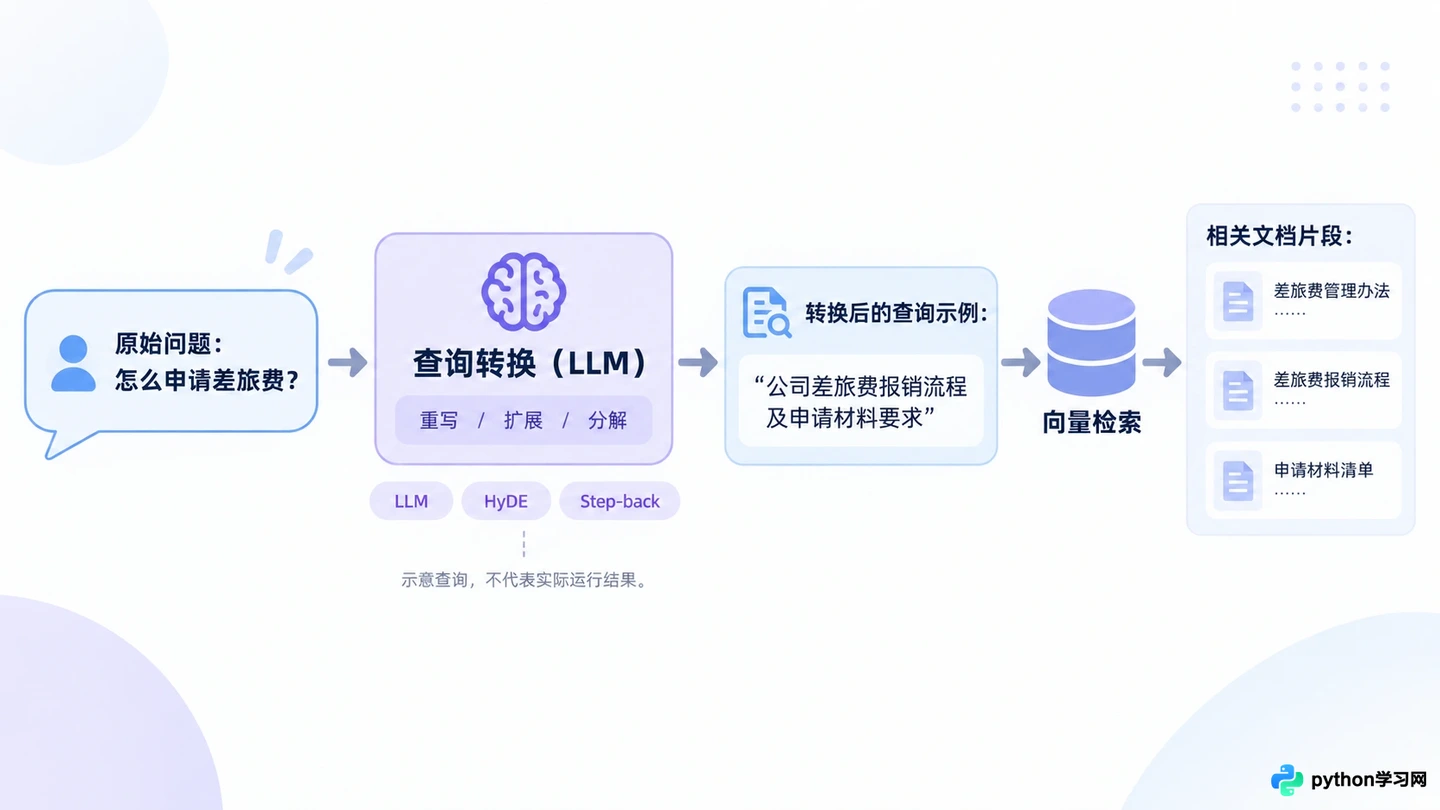
查询转换技术工作流程图
4. 验证优化效果与可编辑性
最后,对比两种引擎的输出结果。使用相同的测试问题,分别调用 Naive RAG 和 Advanced RAG 引擎。
# 原始问题
question = "怎么申请差旅费?"

# Naive RAG 响应
naive_response = query_engine.query(question)
print(f"Naive RAG: {naive_response}")

# Advanced RAG 响应
advanced_response = transform_query_engine.query(question)
print(f"Advanced RAG: {advanced_response}")
在实际运行中,Advanced RAG 通常能提供更完整、结构更清晰的回答,因为它检索到了更相关的上下文。此外,由于采用了模块化设计,你可以随时替换 retriever 为混合检索器(结合关键词和向量),或更换 query_transform 为多查询生成器(Multi-Query Generator),而无需重构整个应用。
工作文件应保留为独立的 Python 脚本或 Jupyter Notebook,以便后续调整 LLM 模型参数或嵌入维度。这种架构不仅提升了检索准确率,还增强了系统的可维护性和可扩展性,为后续引入重排序(Re-ranking)等更高级技术奠定了基础。
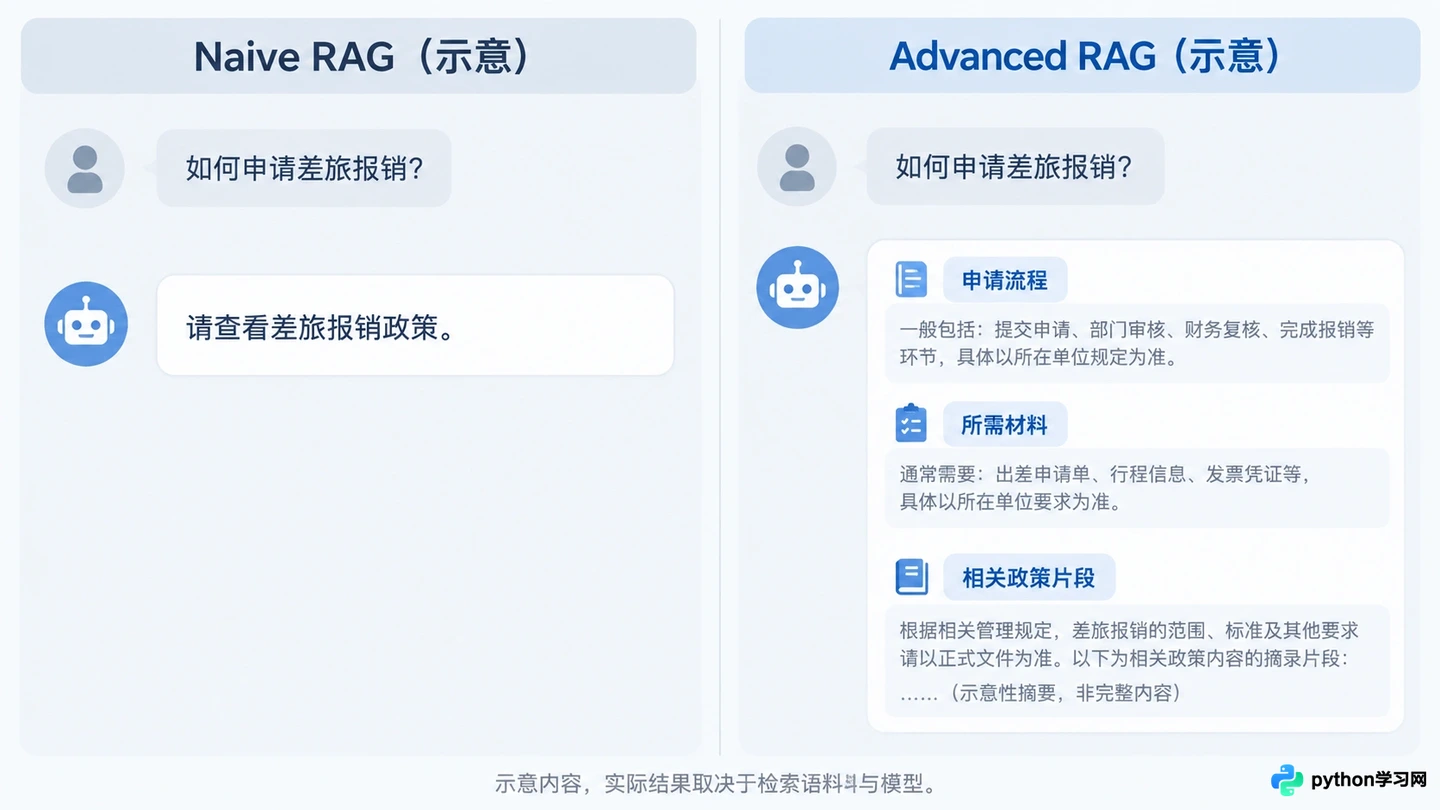
Naive RAG与Advanced RAG响应结果对比
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















