


Python列表切片和dict.copy()是浅拷贝还是深拷贝
全面解答Python中列表切片与dict.copy()属于浅拷贝还是深拷贝。深入剖析底层内存指针、对象可变性带来的认知误区、代码验证与工程选型建议。
明确回答 Python 容器复制机制的核心问题,通过内存引用剖析、实测验证与决策图解,彻底厘清两者的行为边界。
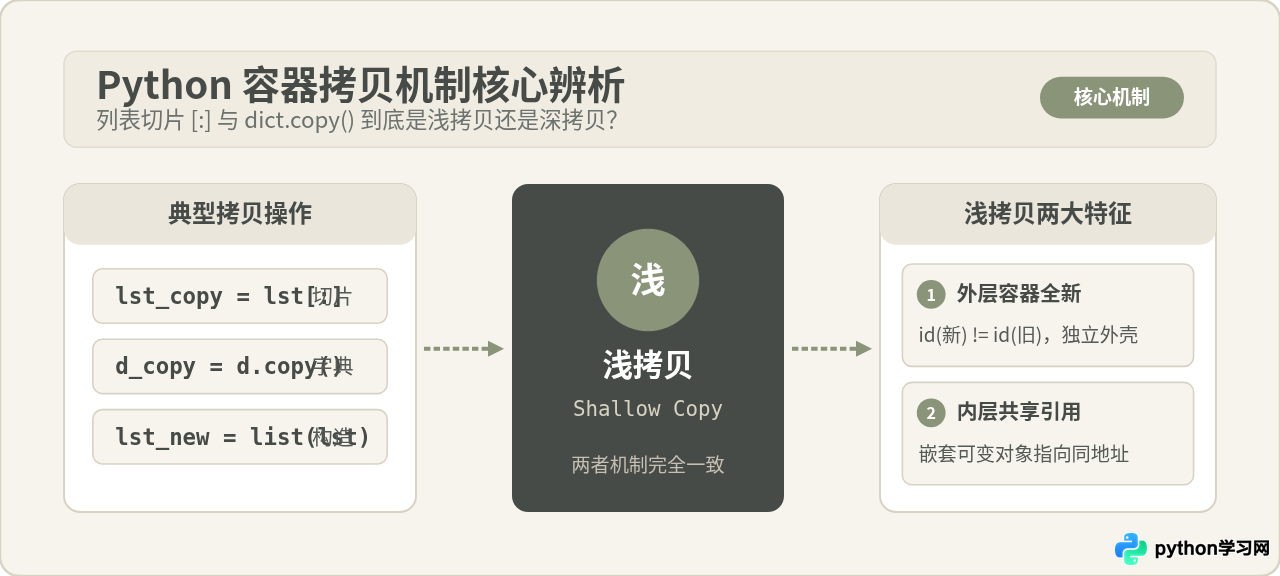
a[:]、a[1:4]),还是字典内置的 dict.copy() 方法,全部都属于浅拷贝(Shallow Copy),而不是深拷贝(Deep Copy)。它们都会在内存中创建一个全新的外层容器对象,但容器内部存放的每个元素,仅仅是复制了原对象中对应元素的“内存指针引用”,并未递归克隆内部元素本体。
一、从内存引用模型看浅拷贝的本质
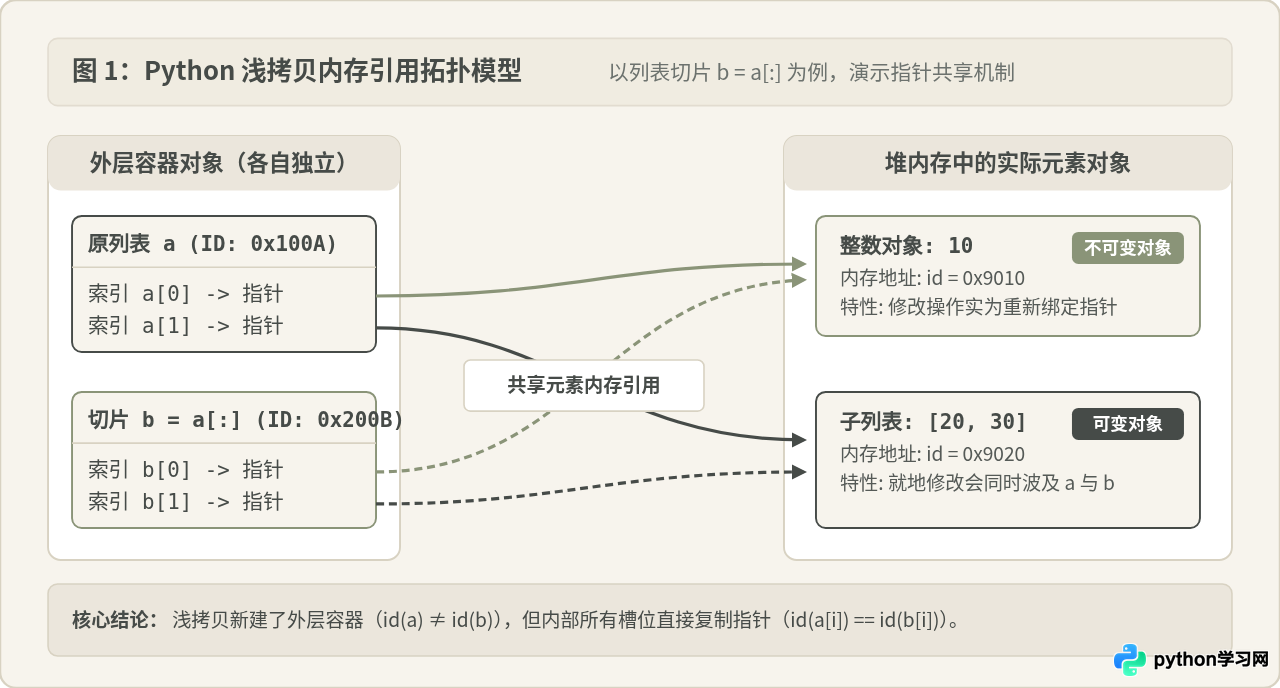
要透彻理解切片与 .copy() 的表现,首先需要区分两个层级:“外层容器本身”与“容器内部持有的元素”。
当执行浅拷贝操作时,Python 在内存堆(Heap)中分配了一块全新的内存空间来容纳新容器,因此新旧容器本身的内存地址(通过内置函数 id() 检验)是完全不相等的。然而,新容器在初始化槽位时,直接把原容器对应槽位存储的对象引用(即物理内存地址)逐一复制过去。这意味着:容器外壳是独立的,而内部元素是共享的。
# 代码示例:验证外层独立与内层共享
a = [10, [20, 30]]
b = a[:]  # 列表切片浅拷贝

print(f"a 的内存地址: {id(a)}")
print(f"b 的内存地址: {id(b)}")
print(f"外层是否为同一对象: {a is b}")  # 结果为 False

print(f"a[0] 与 b[0] 的地址比较: {a[0] is b[0]}")  # 结果为 True(共享不可变对象 10)
print(f"a[1] 与 b[1] 的地址比较: {a[1] is b[1]}")  # 结果为 True(共享可变列表 [20, 30])
# 示例输出:
# a 的内存地址: 4382914368
# b 的内存地址: 4382914880
# 外层是否为同一对象: False
# a[0] 与 b[0] 的地址比较: True
# a[1] 与 b[1] 的地址比较: True
同样的逻辑完全适用于字典的 .copy() 方法:调用 d.copy() 会构造一个包含相同键值对应关系的新哈希表,但如果某个键对应的值是列表、嵌套字典或其他可变对象,新旧字典依然共同指向同一块内存中的目标对象。
二、为什么许多时候它“看起来像深拷贝”?辨析常见混淆
在日常开发中,许多初学者经常会写出如下代码,并得出“切片是深拷贝”的错误推论:
# 容易引起误解的代码
nums1 = [1, 2, 3]
nums2 = nums1[:]
nums2[0] = 999

print("nums1:", nums1)  # 输出: [1, 2, 3]
print("nums2:", nums2)  # 输出: [999, 2, 3]
在这个例子中,修改 nums2[0] 之后,原列表 nums1 确实完全没有受到影响。为什么会出现这种现象?
根本原因在于“元素的可变性”以及“赋值语句的语义”:
- 不可变对象的重新绑定:整数
1是 Python 中的不可变对象(Immutable)。语句nums2[0] = 999并不是将内存中原有的数字1修改成了999(数字 1 根本无法原地修改),而是在堆内存中找到了或创建了整数对象999,并将nums2[0]这个槽位的指针重新指向了999。 - 指针分道扬镳:在这个过程中,
nums1[0]依然指向原来的数字1。因此两者看似完全隔离。这种隔离并非因为切片对数据做了深层复制,而是因为对不可变元素的赋值本质上是一次“指针重定向”。
反之,如果列表元素中包含的是列表、字典、集合或自定义类实例等可变对象(Mutable),并且通过 append()、extend()、字典键修改等方式进行原地修改(In-place Mutation),浅拷贝的局限性就会瞬间暴露:
# 揭露浅拷贝本质的反例
nested1 = [[1, 2], [3, 4]]
nested2 = nested1[:]  # 切片复制

nested2[0].append(999)  # 对子列表进行就地修改

print("nested1:", nested1)  # 输出: [[1, 2, 999], [3, 4]] -> 被连带修改!
print("nested2:", nested2)  # 输出: [[1, 2, 999], [3, 4]]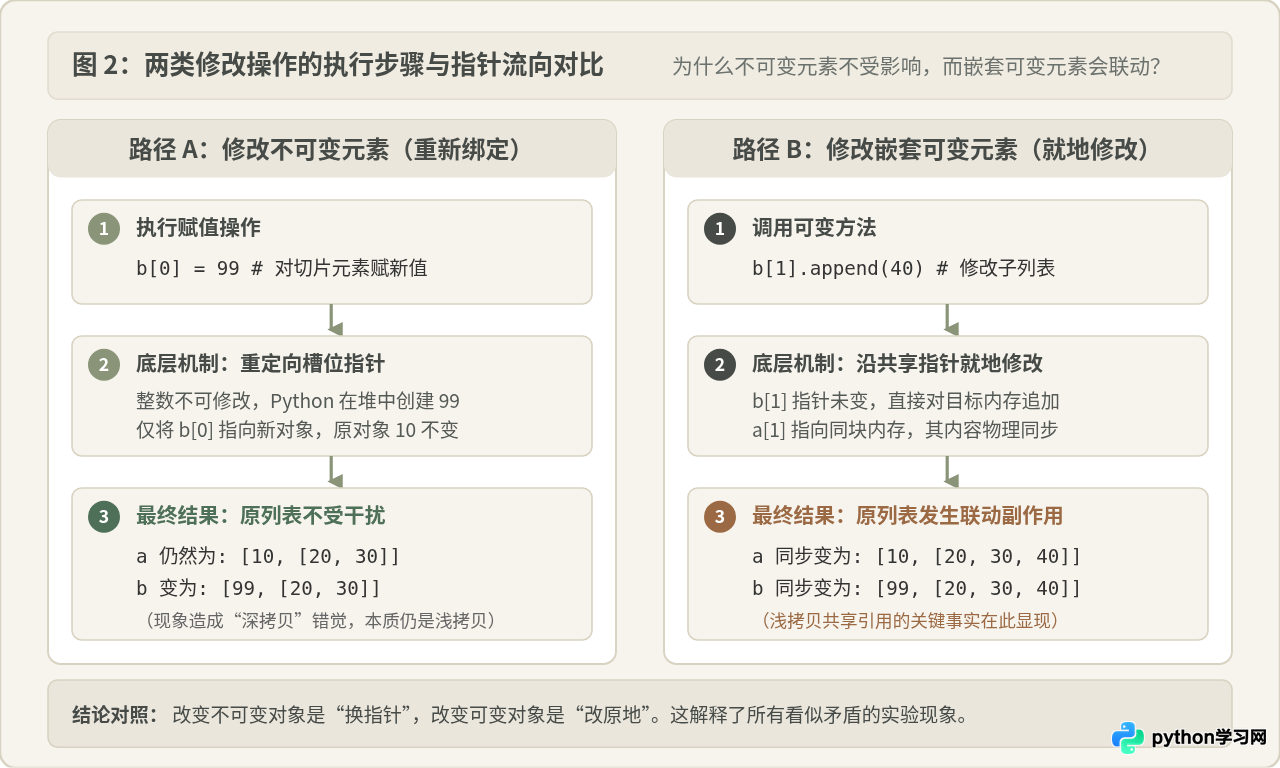
三、实测验证:列表切片与 dict.copy() 的代码行为
为了加深理解,我们分别对列表切片和 dict.copy() 进行完整的操作场景测试。
1. 列表切片的全场景测试
在列表中,切片不仅支持全量复制 a[:],还支持步长切片与区间切片。它们在底层遵循统一的浅拷贝规则:
data = ["Alice", {"level": "admin", "skills": ["Python", "SQL"]}]
copied = data[:]

# 场景 1:修改第一层的不可变字符串元素(指针重绑定)
copied[0] = "Bob"
print(data[0])    # 输出: Alice(原列表不受影响)

# 场景 2:修改第二层嵌套字典的内容(原地修改可变对象)
copied[1]["level"] = "guest"
copied[1]["skills"].append("Docker")

print(data[1]["level"])   # 输出: guest(原列表对应字段被同步改变!)
print(data[1]["skills"])  # 输出: ['Python', 'SQL', 'Docker'](原列表同步更新!)
2. 字典 dict.copy() 的全场景测试
字典的 copy() 同样只做第一层键值引用的复制:
config = {
    "timeout": 30,
    "headers": {"Accept": "application/json", "Cache-Control": "no-cache"}
}

config_backup = config.copy()

# 操作 A:修改第一层的数值键(重新绑定)
config_backup["timeout"] = 60
print(config["timeout"])  # 输出: 30(互不影响)

# 操作 B:在第一层新增一个全新键值
config_backup["retries"] = 3
print("retries" in config)  # 输出: False(顶层结构互相独立)

# 操作 C:修改内层 headers 字典(就地修改)
config_backup["headers"]["Authorization"] = "Bearer token_xyz"
print(config["headers"].get("Authorization"))
# 输出: Bearer token_xyz(原始 config 同样被写入了 Authorization!)dict.copy() 完全等价,全部为浅拷贝:
- 列表相关:
list(old_list)、old_list.copy()、列表推导式[item for item in old_list]; - 字典相关:
dict(old_dict)、字典解包语法{**old_dict}、Python 3.9+ 的合并运算符old_dict | {}。
四、浅拷贝 vs 深拷贝:机制差异与性能对比
如果业务逻辑确实需要与原对象完全断开关联(即修改任意深度的嵌套子对象都绝不影响原对象),就必须使用 Python 标准库中的 深拷贝 copy.deepcopy()。
1. deepcopy 的工作机制
copy.deepcopy() 会沿着对象树进行递归遍历。对于遇到的每一个可变子对象,它都会在内存中新实例化一个对等的副本,并建立全新的引用链条。此外,为了防止对象图中存在循环引用(例如 a.append(a))导致递归死循环,deepcopy 内部维护了一个 memo 备忘录字典,用来记录已访问过并复制的对象地址。
import copy

raw_data = [1, [2, 3]]
deep_cloned = copy.deepcopy(raw_data)

deep_cloned[1].append(999)

print("raw_data:", raw_data)        # 输出: [1, [2, 3]] -> 完好如初
print("deep_cloned:", deep_cloned)  # 输出: [1, [2, 3, 999]] -> 彻底隔离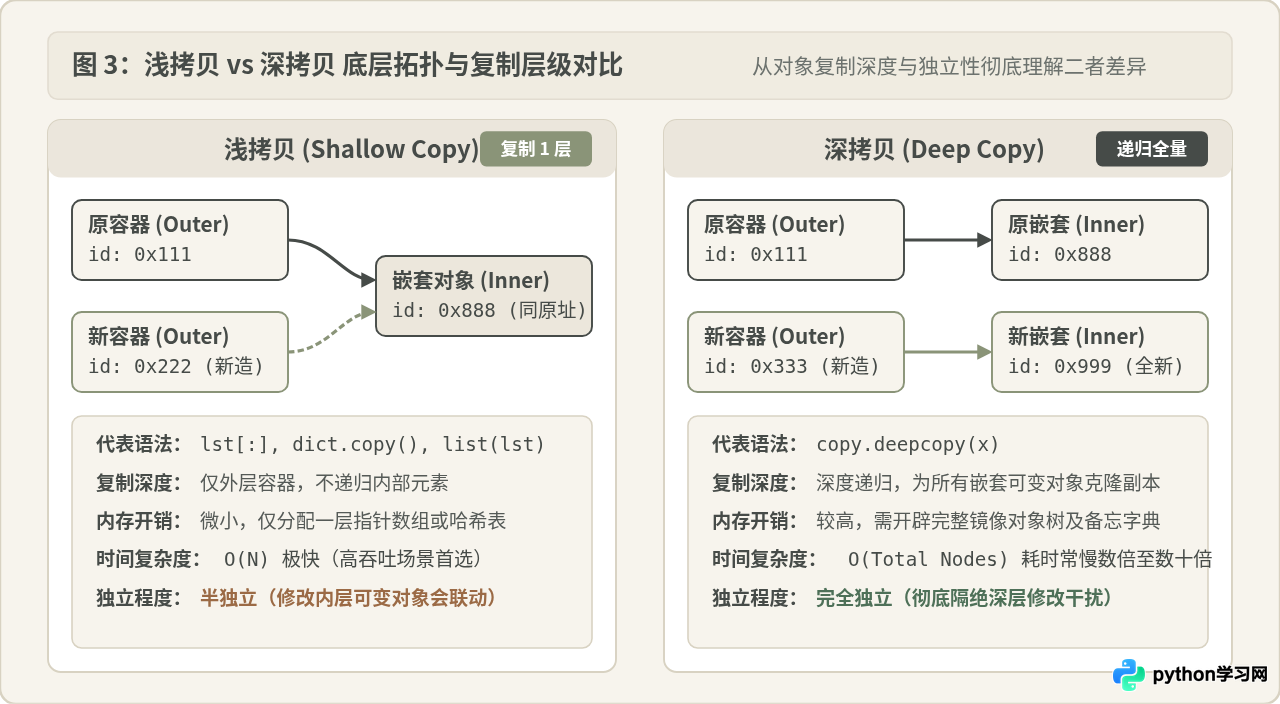
2. 性能与资源消耗权衡
深拷贝虽然保证了数据的绝对隔离,但并非无代价的“万灵药”。在编写高性能代码时,开发者必须明确两者的性能差异:
- 时间开销:浅拷贝的耗时是线性的 $O(N)$,仅仅是向新列表或字典连续拷贝固定大小的指针地址,由于底层是用 C 语言实现的内存批量搬运(如
memcpy),速度极快;而deepcopy需要递归遍历整个对象图、解析类型、调用构造方法、并频繁读写memo字典,执行速度通常比浅拷贝慢 数倍到几十倍 不等。 - 内存占用:浅拷贝仅增加一个外层壳的内存,内部对象零增量;深拷贝则按全量拓扑重新实例化每一个中间容器和可变节点,内存占用可能成倍增加。
五、工程实践中的选型决策与经典避坑
1. 技术选型决策树
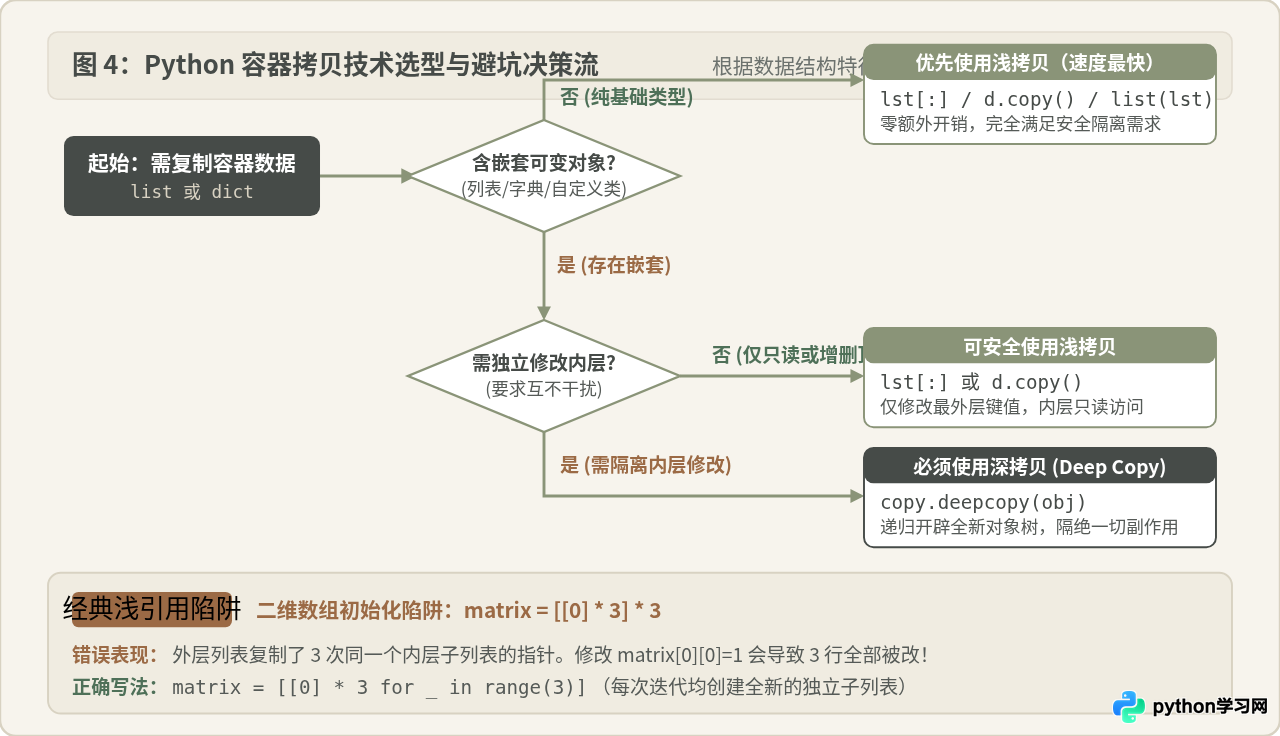
根据数据结构类型与业务读写需求,我们可以清晰地做出最合理的拷贝决策:
- 单层扁平数据(如纯数字、字符串列表、扁平字典):果断采用切片
[:]或.copy()。这不仅执行效率最高,而且天然不存在嵌套可变对象共享引用的安全风险。 - 多层嵌套数据但仅读取或仅变更顶层键:优先使用浅拷贝。只要团队编码规范明确约束“禁止直接原地修改子对象属性”,浅拷贝依然是高并发、高吞吐场景下的首选方案。
- 多层嵌套且需要独立编辑分支状态(如配置多环境覆盖、复杂树形节点操作、仿真回滚):必须使用
copy.deepcopy(),确保环境隔离的健壮性。
2. 经典高频陷阱:乘号初始化的“浅引用幽灵”
在面试与实际编码中,最容易由浅引用引发严重生产事故的场景是二维数组初始化:
# 错误写法:利用乘号复制列表
matrix = [[0] * 3] * 3

matrix[0][0] = 1
print("错误初始化结果:", matrix)
# 输出: [[1, 0, 0], [1, 0, 0], [1, 0, 0]]
# 原因:* 3 操作对内层列表进行了 3 次浅拷贝,3 行实际指向同一子列表!

# 正确做法:使用列表推导式独立实例化每一行
matrix_correct = [[0] * 3 for _ in range(3)]
matrix_correct[0][0] = 1
print("正确初始化结果:", matrix_correct)
# 输出: [[1, 0, 0], [0, 0, 0], [0, 0, 0]]
六、关键知识点速查总结
| 特性 / 操作方式 | 直接赋值 (b = a) | 浅拷贝 (a[:] / d.copy()) | 深拷贝 (deepcopy(a)) |
|---|---|---|---|
| 外层容器对象 | 完全相同 (同一引用) | 全新独立对象 (id(b) != id(a)) | 全新独立对象 (id(b) != id(a)) |
| 第一层不可变元素修改 | 影响原变量 (重绑定指针) | 不影响原变量 (独立槽位) | 不影响原变量 (独立槽位) |
| 深层可变对象修改 | 双方同步联动 | 双方同步联动 (共享内层引用) | 完全独立隔离 (互不干扰) |
| 典型代表语法 | b = a |
a[:], d.copy(), list(a) |
copy.deepcopy(a) |
| 运行性能 | 最高 (仅传递单个指针) | 极高 (C 级别批量复制单层) | 较低 (递归解析与对象构造) |
总结
牢记一条黄金法则:Python 列表切片和 dict.copy() 都是且仅是浅拷贝。当你面对由基础不可变类型构成的容器时,浅拷贝安全且高效;但一旦容器中出现了嵌套列表、字典或自定义对象,并且需要对这些内层对象执行修改时,务必提高警惕,根据业务需求选择深拷贝或规范数据流转逻辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















