


怎么提高RAG知识库检索准确率:分块策略与重排序技巧

在构建基于大语言模型的企业知识库时,最令开发者头疼的往往不是模型本身的智商,而是“它明明知道答案,却找不到那张纸”的尴尬。用户问的是“A项目的预算审批流程”,系统却返回了“B项目的报销规定”,仅仅因为两者都包含“项目”和“财务”这两个高频词。这种检索噪声直接导致大模型产生幻觉或给出无关回答,让原本智能的助手变得不可信。
许多团队在遇到检索不准时,第一反应是更换更强大的向量模型或增加嵌入维度。然而,检索质量的瓶颈往往不在向量空间本身,而在进入向量空间之前的数据处理,以及走出向量空间之后的结果筛选。 如果原始文本被切得支离破碎,或者召回列表中存在大量语义相近但逻辑无关的干扰项,再昂贵的模型也无能为力。提升RAG(检索增强生成)准确率的核心,在于精细化的分块策略与智能化的重排序技巧。
语义完整性优先:告别机械式字符切割
传统的文本分块往往简单粗暴地按固定字符数(如500字)进行切割,这种做法忽略了自然语言的内在结构。当一个完整的逻辑段落被强行从中间切断,前半部分留在块A,后半部分进入块B,向量模型在编码时就丢失了关键的上下文关联。用户查询时,可能只能匹配到片段化的信息,导致召回内容断章取义。
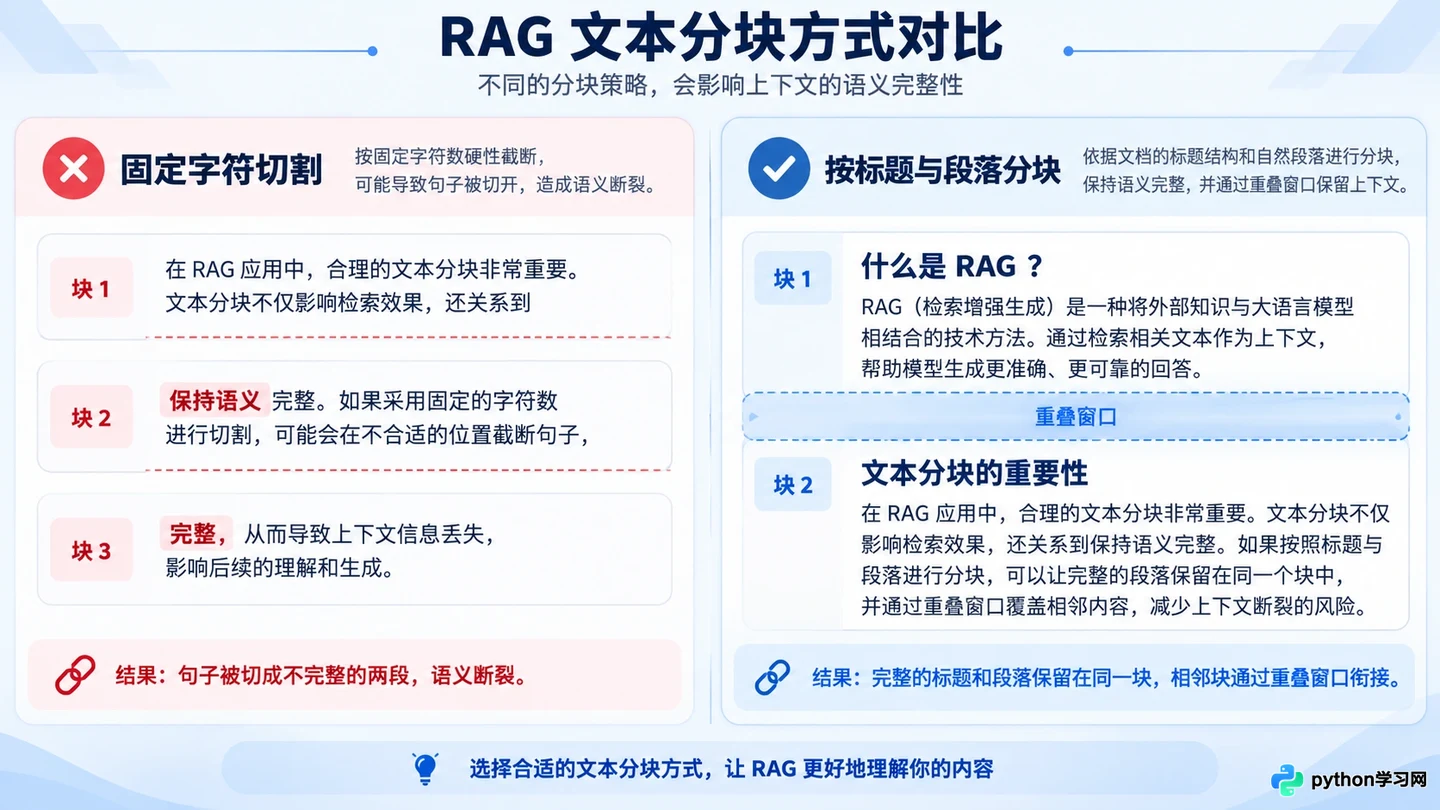
左侧展示传统固定字符切割导致语义断裂,右侧展示基于标题和段落的语义分块保持内容完整,并标注重叠窗口区域。
更有效的策略是采用基于语义结构的分块方法。利用Markdown标题、HTML标签或自然段落作为切割边界,确保每个文本块都是一个相对独立的意义单元。例如,在处理技术文档时,应以三级标题为界,将“安装步骤”、“配置参数”和“故障排除”分开存储。这样,当用户询问“如何配置参数”时,检索到的整个块都是关于配置的完整说明,而不是混杂了安装前缀的碎片。
此外,重叠窗口(Overlap)机制是弥补切割损失的关键手段。在相邻的两个文本块之间保留10%-20%的重叠内容,可以防止关键信息因处于切割边缘而被弱化。这种冗余并非浪费,而是为向量模型提供了更多的上下文锚点,使得处于边界的句子也能被准确编码。在这种场景下,分块不再是简单的物理截断,而是对知识颗粒度的逻辑重构。
混合检索互补:克服单一向量的语义盲区
向量检索擅长捕捉语义相似性,但在处理专有名词、精确匹配或特定术语时往往表现不佳。例如,用户搜索产品型号“X-200 Pro”,向量模型可能会将其映射到语义相近的“高级专业版设备”,从而漏掉真正包含“X-200 Pro”字符串的文档。反之,传统的关键词检索(如BM25)虽然能精准命中术语,却无法理解“怎么重启”和“重新启动方法”之间的同义关系。
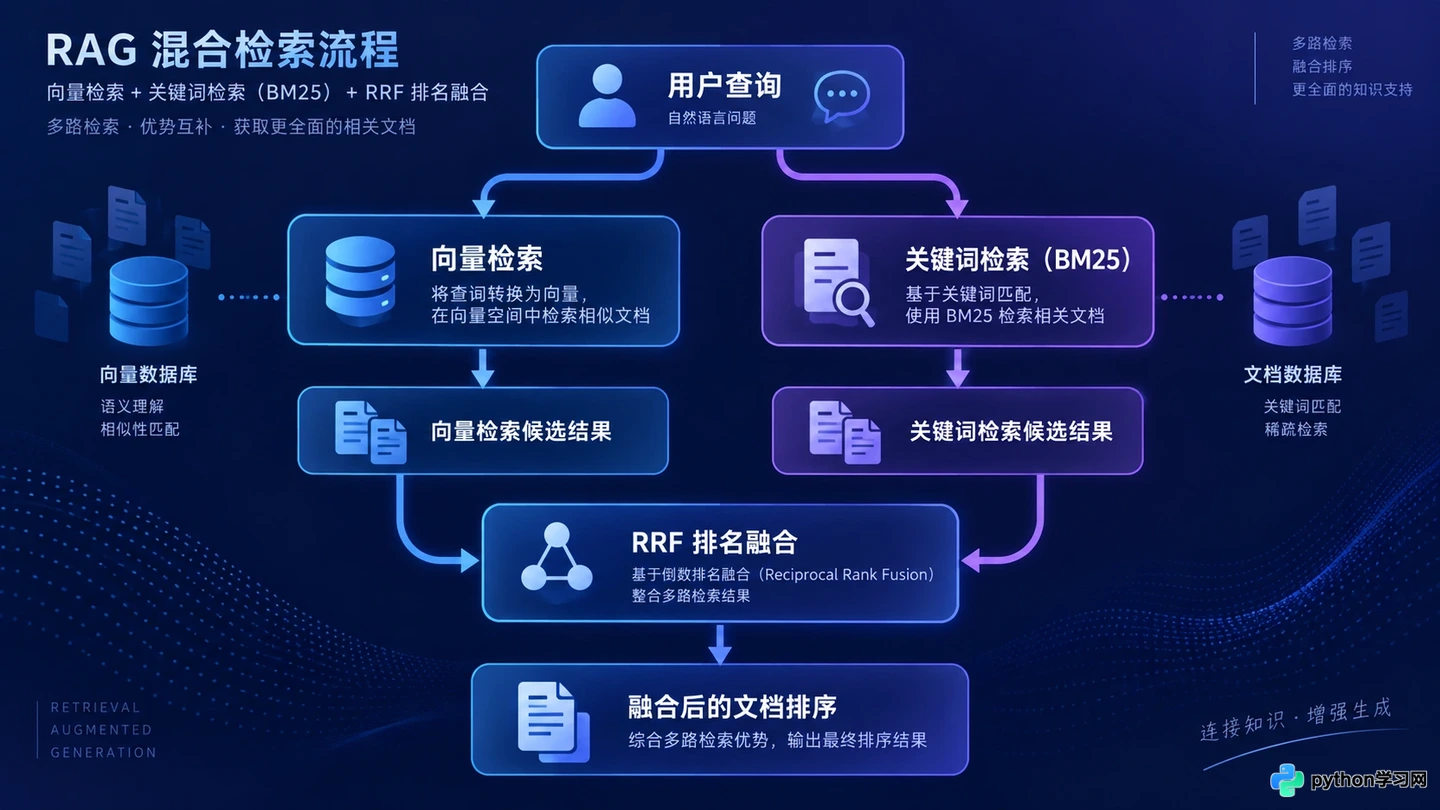
展示查询同时进入向量检索和关键词检索分支,并通过RRF算法融合结果的流程。
因此,单一检索模式难以覆盖所有查询意图。采用混合检索(Hybrid Search)策略,将向量检索的语义理解能力与关键词检索的精确匹配能力结合,是提升召回率的必经之路。在实际操作中,系统同时执行向量搜索和关键词搜索,分别得到两组候选文档列表。关键在于后续的融合算法,通常使用倒数排名融合(RRF)等方法,对两份列表中的文档进行加权排序。那些在两种检索方式中都排名靠前的文档,其相关性置信度最高。这种互补机制有效解决了“懂意思但没词”和“有词但不懂意思”的两难困境。
重排序精筛:用Cross-Encoder修正粗排偏差
即使采用了混合检索,初次召回的前K个文档(通常K=50或100)中仍可能混杂着低相关性的噪声。向量相似度计算为了追求速度,通常采用双编码器架构,将查询和文档分别编码后计算余弦相似度,这是一种“粗排”过程,无法细致比对查询与文档之间的交互细节。
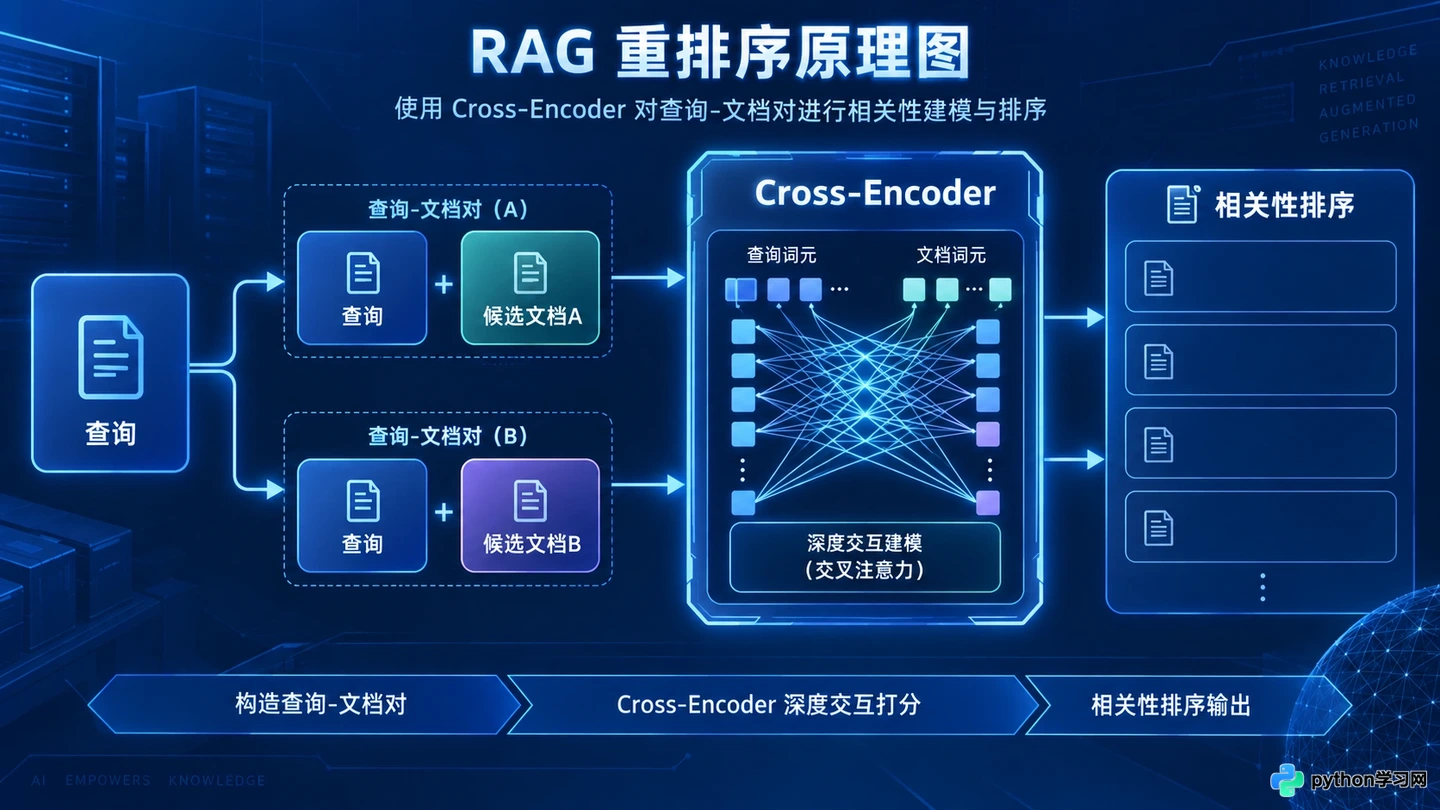
展示Cross-Encoder模型将查询与候选文档拼接输入,进行深度交互计算并输出相关性分数的过程。
此时,引入重排序(Re-ranking)模型成为提升最终准确率的关键一步。重排序模型通常基于Cross-Encoder架构,它将查询语句和每一个候选文档拼接在一起输入模型,进行深度的交叉注意力计算。虽然计算成本较高,但它能精准判断文档是否真正回答了问题,而不仅仅是看起来像。例如,对于查询“Python如何处理空值”,一个包含“Java空指针异常”的文档可能在向量空间中距离很近,但经过重排序模型审视,会被判定为低相关性并降权。
在实际部署中,无需对所有库内文档重排,只需对初筛出的Top 50或Top 100文档进行重排序即可。这一步骤虽然增加了少量延迟,但能显著净化送入大模型的上下文环境。高质量的Top 5胜过嘈杂的Top 20,因为大模型更容易被无关信息干扰而产生幻觉。通过重排序,我们实际上是在用计算资源换取信息的纯度,确保只有最切题的内容参与最终生成。
查询改写与元数据过滤:前置干预的艺术
除了后端检索优化,前端的查询理解同样重要。用户的原始提问往往模糊不清或缺乏背景。例如,用户只输入“报错怎么办”,系统若无上下文,几乎无法检索到有效信息。通过查询改写(Query Rewriting)技术,利用大模型将简短提问扩展为包含背景信息的完整句子,或生成多个不同角度的子查询,可以大幅提升检索的命中率。
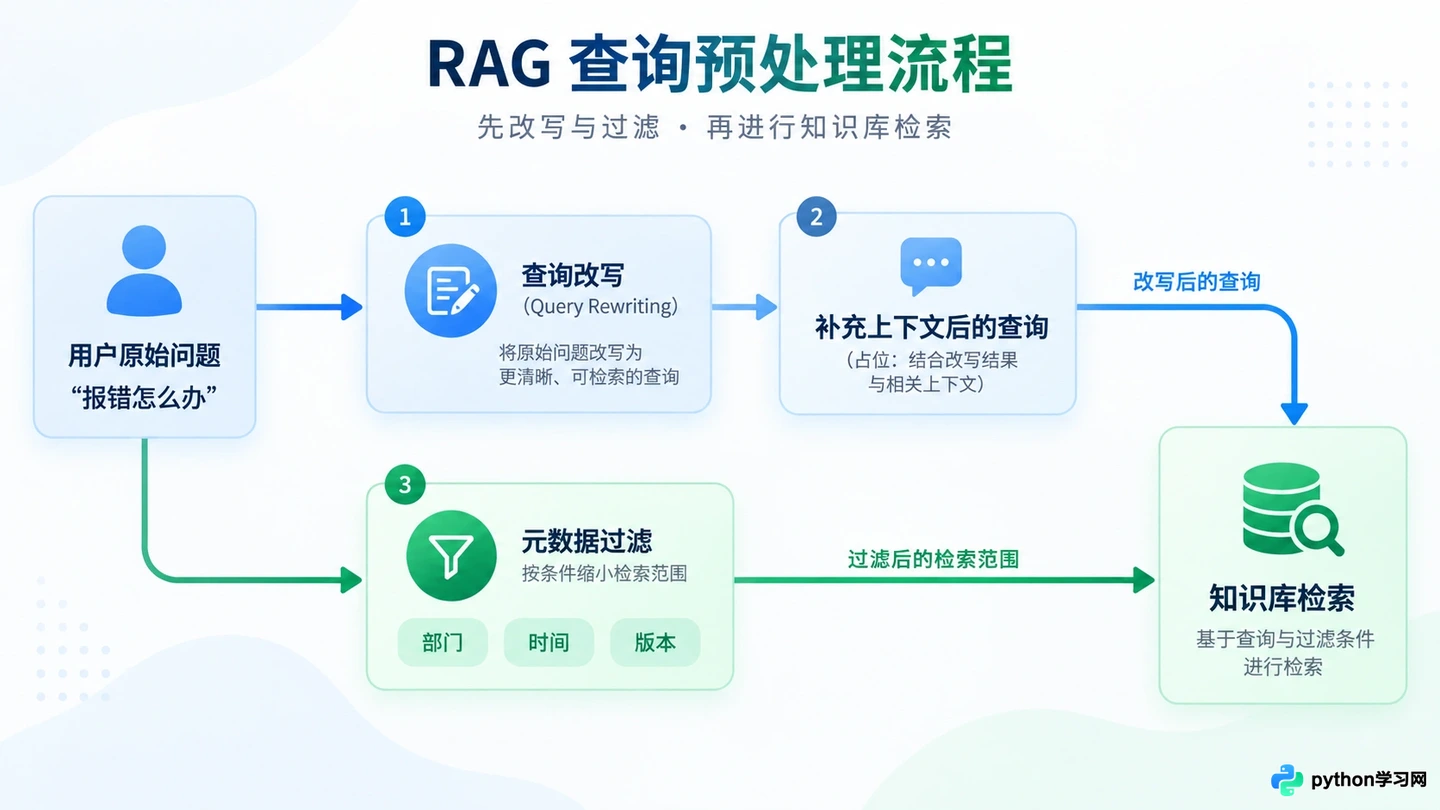
展示用户原始查询经过LLM改写扩展,并结合元数据过滤器缩小检索范围的过程。
同时,元数据过滤(Metadata Filtering)是缩小检索范围的利器。在企业知识库中,文档通常带有部门、时间、版本等属性。如果在检索向量之前,先通过元数据过滤掉“已废弃”或“非本部门”的文档,不仅能减少计算量,更能从源头上杜绝过时或无关信息的干扰。这种“先过滤,后检索”的策略,尤其适用于数据量大、更新频繁的场景。它将通用的语义搜索转化为特定域内的精准查找,避免了大海捞针式的低效匹配。
回到最初的取舍,提高RAG检索准确率并非单纯依赖更强的模型,而是一套组合拳:用语义分块保证输入质量,用混合检索扩大覆盖范围,用重排序模型提纯结果,用查询改写和元数据过滤精准定位。 对于大多数应用场景,优化分块策略和引入重排序带来的收益,远大于盲目升级向量模型。只有当检索到的每一片信息都精准可靠时,大模型的生成能力才能真正转化为业务价值,而不是制造更多看似有理实则荒谬的噪音。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















