


RAG技术是什么:检索增强生成怎么解决大模型幻觉

你有没有遇到过这种情况:问AI一个很具体的公司内部规定,或者昨天刚发生的新闻,它要么一脸茫然说不知道,要么信誓旦旦地编出一套听起来很合理但完全错误的答案?这就是让人头疼的“大模型幻觉”。
其实,这不能全怪AI不够聪明。大多数大语言模型就像是一个在2023年之前读完图书馆所有书的学生,知识都记在脑子里(参数里),但没法实时更新,也没法查阅你没教过它的私密笔记。要解决这个问题,现在最流行的方案就是给AI配一个“实时外脑”,也就是我们要聊的 RAG 技术。
给AI配个“开卷考试”的外挂
RAG 的全称是 Retrieval-Augmented Generation,中文叫“检索增强生成”。名字听着挺唬人,逻辑其实特别生活化。
传统的AI回答问题,是靠“闭卷考试”,全靠记忆硬扛。而 RAG 则是允许 AI “开卷考试”:当你提问时,系统先去一个专门的知识库里检索相关信息,把这些资料连同你的问题一起交给 AI,让它看着资料回答。
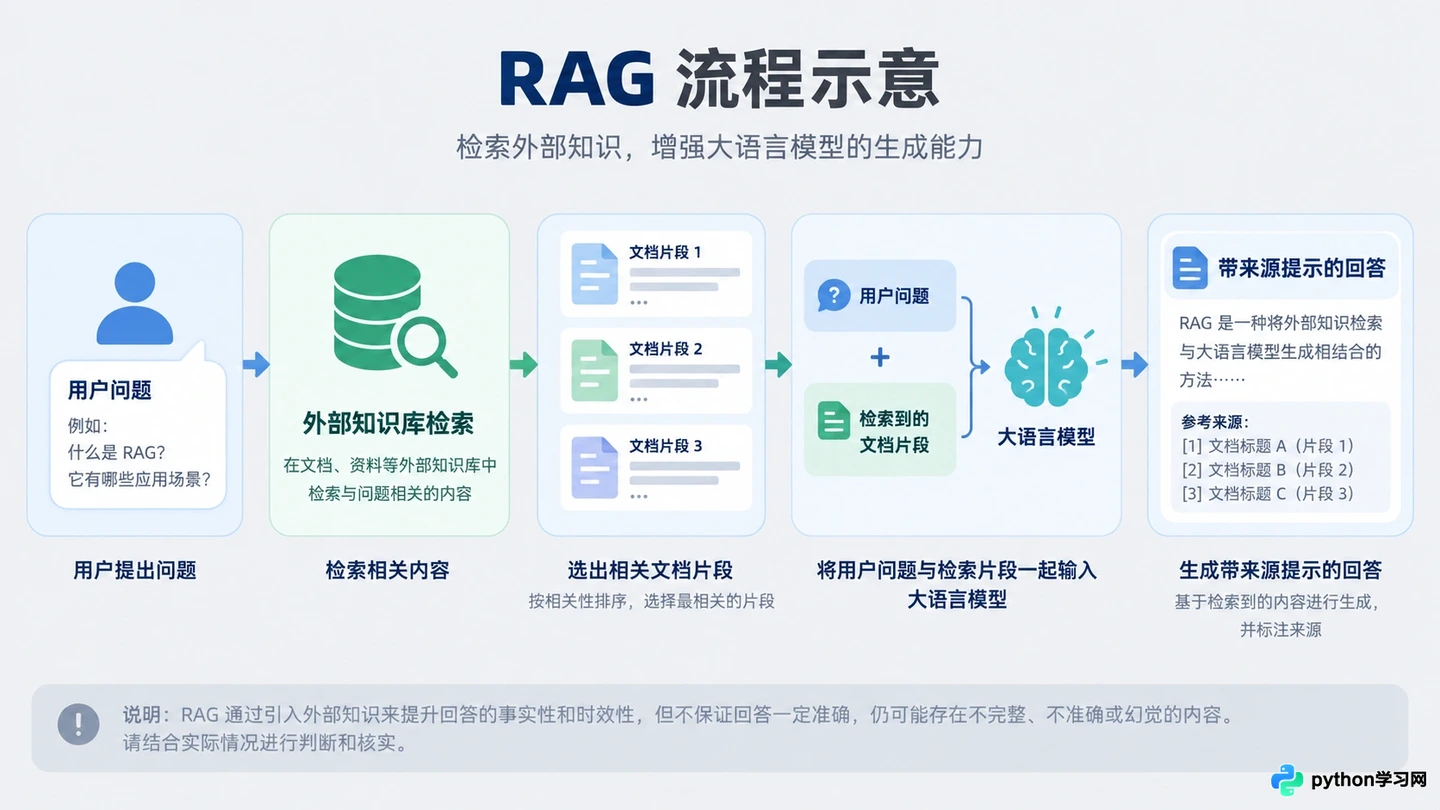
RAG技术通过检索外部知识库增强生成过程
这样一来,AI 不需要重新训练,就能立刻用上最新的、或者你私有的数据。它不再是凭空捏造,而是基于你提供的“小抄”进行总结和组织。如果知识库里没有答案,它也可以老实承认,而不是胡乱猜测。
为什么大模型总爱“一本正经地胡说八道”
要理解 RAG 的价值,得先明白幻觉是怎么来的。大模型本质上是基于概率预测下一个字的。当它遇到知识盲区,为了保持语句通顺和逻辑连贯,它会倾向于选择概率最高的词组合起来。
这就导致了一个现象:对于模糊或未知的问题,AI 可能会把不同来源的信息拼接在一起,生成一段看似专业实则荒谬的内容。比如问它某家未上市公司的高管名单,它可能会把同名公司的信息张冠李戴。
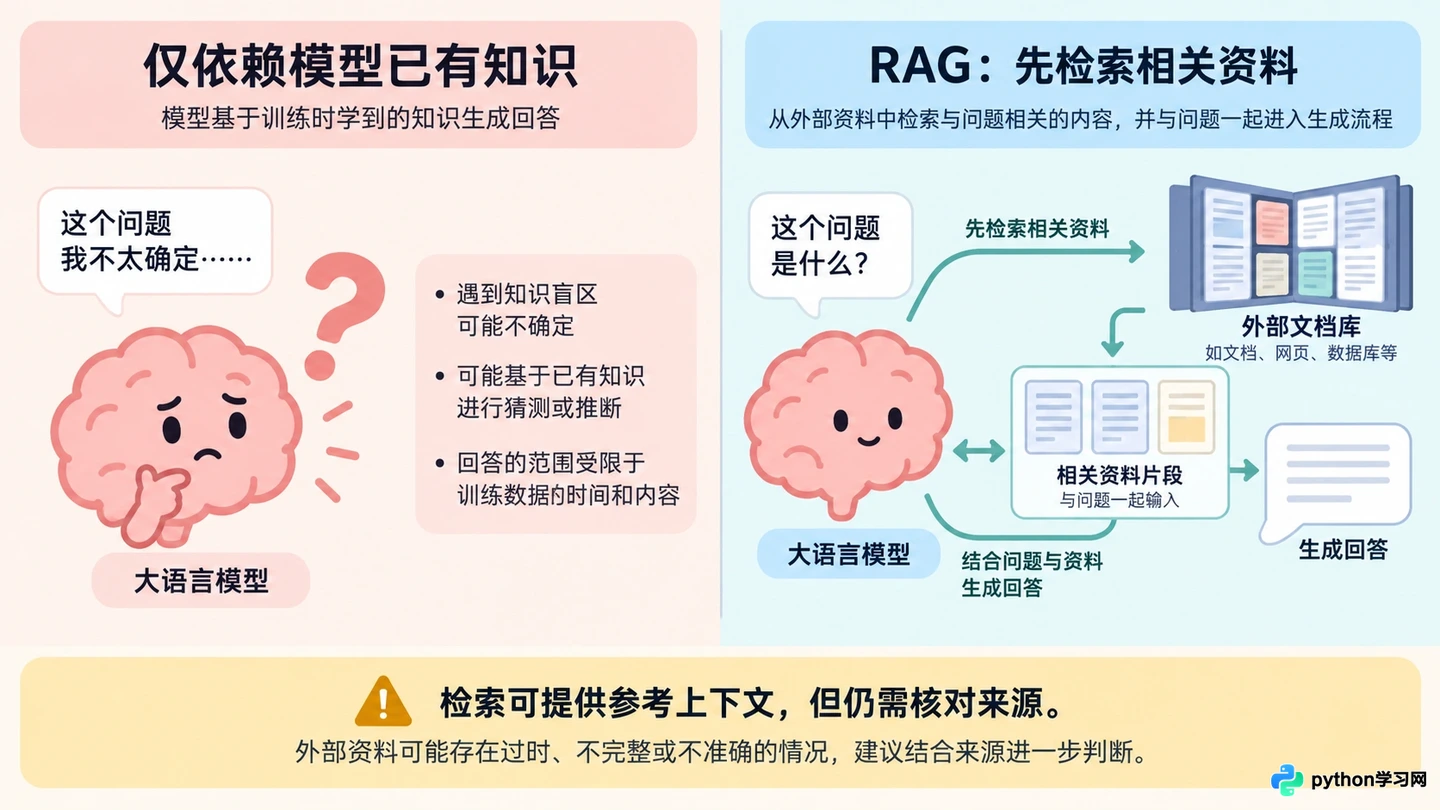
传统大模型依赖记忆 vs RAG依赖检索事实
RAG 的核心作用,就是把这种“概率猜测”变成“有据可依”。通过检索环节,强行给 AI 提供事实依据,大幅压缩了它自由发挥(瞎编)的空间。
RAG 是怎么工作的:三步走策略
虽然背后的技术栈很复杂,但从用户视角看,RAG 的工作流程非常清晰,主要分三步:
- 建立知识库:把你需要的文档、数据库、网页内容清洗后,切成小块,转化成向量存入向量数据库。这一步相当于把书本撕成页,编好索引,方便快速查找。
- 实时检索:用户提问后,系统先在向量数据库里搜索与问题最相关的片段。注意,这里找的是语义相关,哪怕关键词不完全匹配也能找到。
- 增强生成:系统将检索到的片段作为背景信息,和问题一起打包发给大模型。模型根据这些材料生成最终答案,并通常能注明出处。
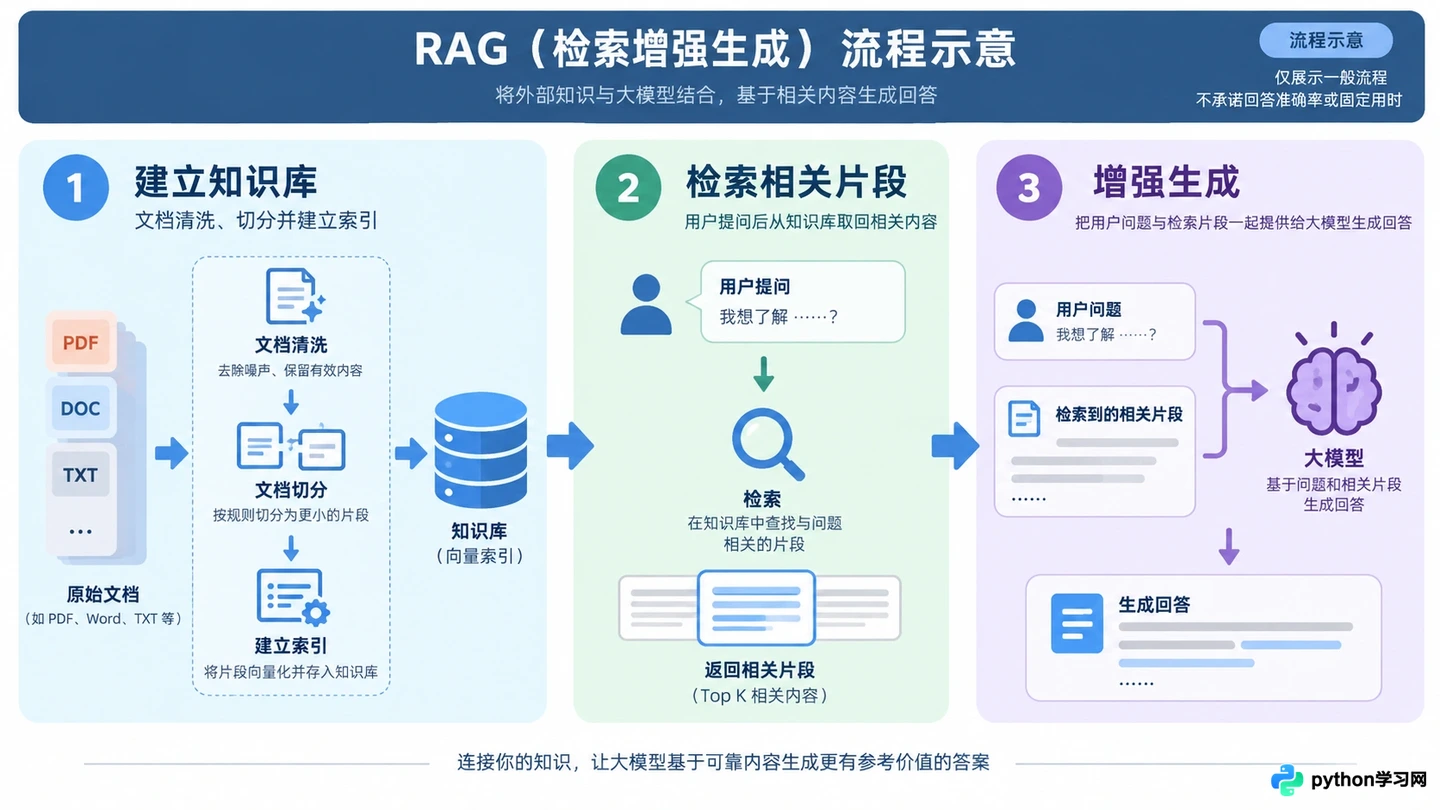
索引、检索、生成的三步流程
这个过程通常在几秒内完成,用户感觉不到中间的检索步骤,只会觉得这个 AI 突然变“懂行”了,而且回答特别精准。
哪些场景最适合上 RAG
并不是所有 AI 应用都需要 RAG。如果你只是让 AI 写首诗、翻译一段话,或者进行创意头脑风暴,原生大模型就够用了。RAG 真正发光发热的地方,是对准确性要求极高的领域:
- 企业智能客服:回答具体的产品售后政策、保修条款,必须一字不差,不能靠猜。
- 内部知识问答:员工查询公司内部的报销流程、IT 支持文档,这些数据不在公网,也不在通用模型的训练集里。
- 专业领域咨询:如法律条文解读、医疗指南查询,需要引用最新的法规或文献,且必须保证来源可靠。
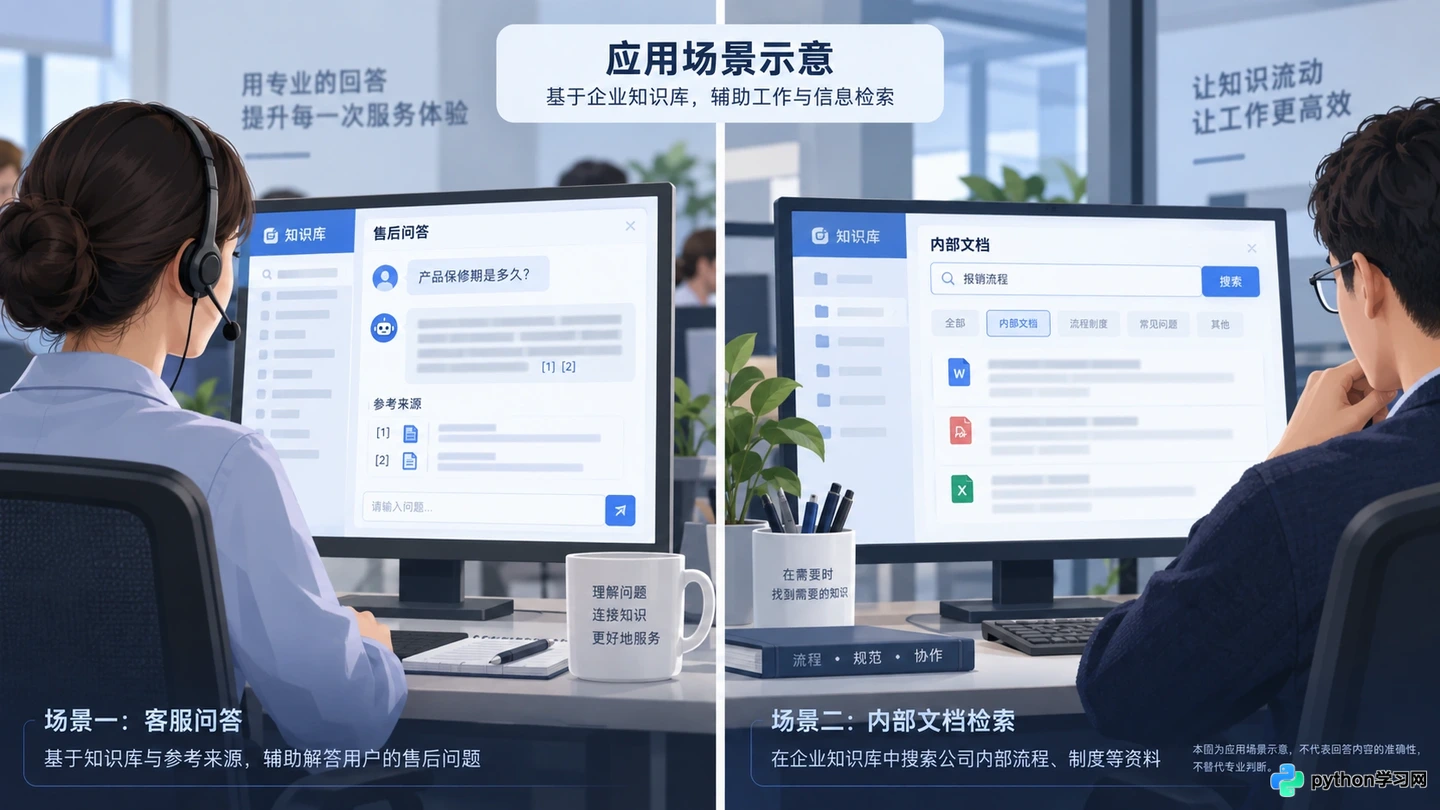
企业客服与内部知识问答是RAG的典型场景
在这些场景下,RAG 不仅解决了“不知道”的问题,更解决了“不敢信”的问题。因为它可以提供引用链接,让用户去核对原文,建立了信任闭环。
写在最后
RAG 技术并不是要取代大模型,而是给大模型装上了“眼镜”和“图书馆”。它让 AI 从单纯的聊天机器人,变成了能处理具体业务、具备专业知识的助手。
当然,RAG 也不是万能的。如果检索回来的资料本身质量很差,或者切片方式不对,AI 依然可能给出糟糕的回答。但对于大多数希望落地 AI 应用的企业和个人来说,RAG 是目前性价比最高、见效最快的解决方案。下次再看到 AI 回答得头头是道且有据可查时,你就知道,它背后大概率藏着一个 RAG 系统在干活。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















