


Python微服务间通信:REST API与gRPC的性能差异及实现方案

一、底层机制剖析:为什么两者存在性能代差
要理解REST API与gRPC的性能差距,不能仅停留在“二进制比文本快”的表层认知,而必须深入到数据序列化协议与网络传输层机制中。
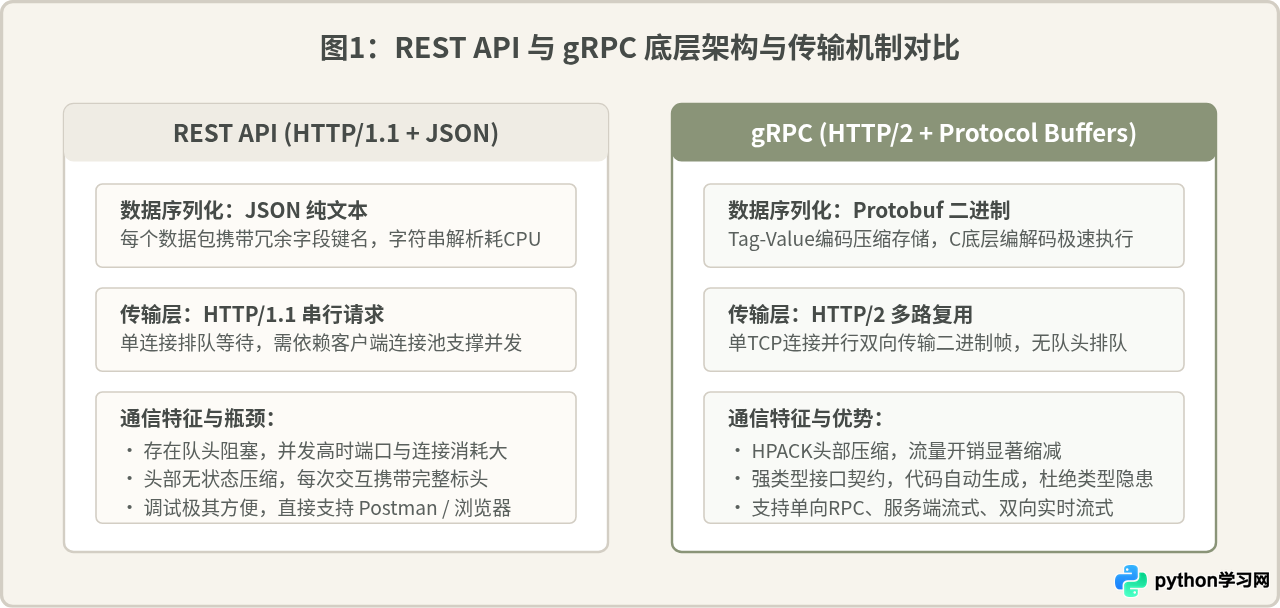
1. 序列化开销:JSON文本与Protocol Buffers二进制
传统的REST API通常采用JSON作为数据交换载体。JSON是纯文本格式,具有良好的可读性,但这种设计在机器间高频通信时伴随明显的性能代价。首先是数据体积冗余:每一个JSON数据包都必须反复携带属性名称字符串(例如 "user_id"、"created_at"),同时数值类型需要转换为字符编码表示。其次是反序列化开销:Python标准库或C加速库在解析JSON时,需要进行严格的字符扫描、词法分析和类型推断。
与此相对,gRPC采用Google开发的Protocol Buffers(Protobuf)。Protobuf是一种强类型的结构化数据存储机制。它在传输时不传递任何字段名,而是通过预先定义的字段编号(Tag)来定位字段,数值采用变长编码(Varint)压缩存储。在Python中,Protobuf生成的编译代码底层可绑定高性能C++解析器,省去了文本解析的状态机开销,大幅降低了Python单进程在处理数据包时的CPU占用。
2. 传输协议差异:HTTP/1.1队头阻塞与HTTP/2多路复用
REST服务通常运行在HTTP/1.1之上。在HTTP/1.1模型下,尽管有Keep-Alive支持长连接复用,但在同一个TCP连接上,请求与响应是严格串行排队的,后一个响应必须等待前一个响应完成,这导致了典型的应用层“队头阻塞(Head-of-Line Blocking)”。当微服务间并发请求突增时,客户端必须通过开启庞大的TCP连接池来分担流量,不仅耗费套接字句柄与内存,每次建立新连接还会引入TCP三次握手与慢启动延迟。
gRPC构建于HTTP/2协议之上。HTTP/2引入了二进制分帧层,允许在单一TCP连接上同时并发交错传输多个双向请求与响应(多路复用 Multiplexing)。此外,HTTP/2内置HPACK算法对请求头进行差量压缩,消除了REST API中大量重复Cookie、User-Agent或通用Header占用的带宽。
二、认知误区辨析:换上gRPC就一定能让Python性能倍增吗?
在技术选型讨论中,常有一种流行说法:“只要把Python微服务间的REST全面替换为gRPC,接口吞吐量就会成倍飙升”。这种说法看似有理,因为gRPC在网络字节和编解码速度上确实占优,但直接套用到Python场景中需要严谨修正。
在Java、Go或C++等编译型、原生多线程语言中,替换为gRPC往往能直接带来线性的吞吐暴涨;但在CPython解释器环境下,微服务的性能瓶颈往往受制于全局解释器锁(GIL)与业务本身的I/O等待(如数据库访问、Redis查询)。
若业务接口主要耗时在SQL查询与业务逻辑计算上(例如耗时50ms,网络传输仅占2ms),将网络传输压缩为0.8ms对总体接口响应时间的改善微乎其微。只有在以下场景下,gRPC的性能优势才会集中体现: (1)数据包结构庞大、嵌套深;(2)微服务调用链深且高并发;(3)跨服务传输密集的批量数据集合;(4)合理搭配了多进程工作模型或异步事件循环。
三、gRPC微服务实现完整落地步骤
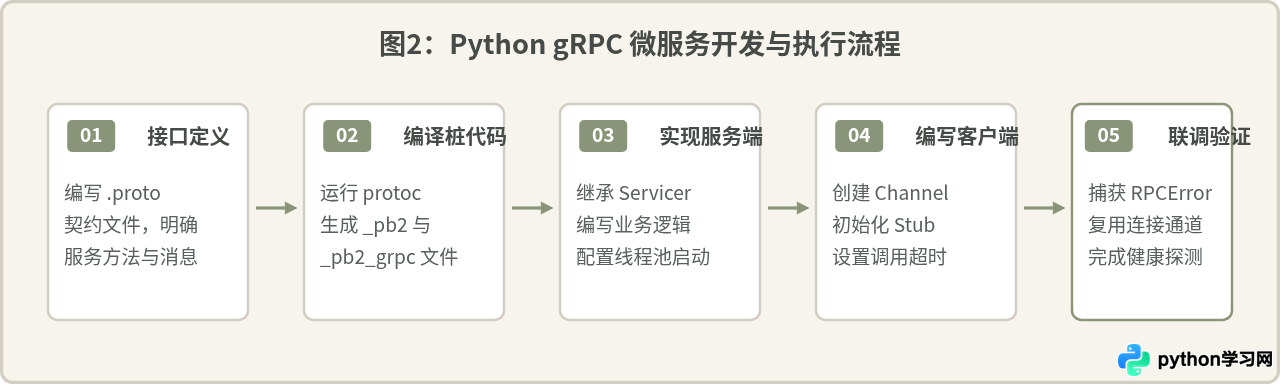
下面演示一个用户服务(UserService)的完整实现流程:从编写强类型契约、编译桩代码,到实现gRPC服务端与客户端调用。
1. 环境安装与准备
在Python环境中使用gRPC,需要安装核心运行库以及用于代码生成的协议编译工具集:
pip install grpcio grpcio-tools2. 编写 Protocol Buffers 契约文件
在项目根目录下创建 user_service.proto 文件。契约明确了接口服务以及入参、出参的数据类型与标识编号:
syntax = "proto3";

package user;

// 用户服务定义
service UserService {
    rpc GetUser (UserRequest) returns (UserResponse);
}

// 请求消息
message UserRequest {
    int32 user_id = 1;
}

// 响应消息
message UserResponse {
    int32 user_id = 1;
    string username = 2;
    string email = 3;
    bool is_active = 4;
}
3. 编译生成 Python 桩代码
在终端中执行以下命令,编译生成通信桩(Stub)与数据编解码模块:
python -m grpc_tools.protoc -I. --python_out=. --grpc_python_out=. user_service.proto
该命令在当前目录生成两个文件:
user_service_pb2.py(包含消息类的序列化与反序列化逻辑)和
user_service_pb2_grpc.py(包含服务端抽象基类与客户端调用存根)。
4. 编写服务端程序 (server.py)
服务端需要继承自动生成的 UserServiceServicer 类,并重写具体的业务逻辑方法。最后通过线程池分配处理并发请求:
import time
from concurrent import futures
import grpc
import user_service_pb2
import user_service_pb2_grpc

class UserService(user_service_pb2_grpc.UserServiceServicer):
    def GetUser(self, request, context):
        # 模拟根据 request.user_id 检索数据库并组装响应
        return user_service_pb2.UserResponse(
            user_id=request.user_id,
            username=f"developer_{request.user_id}",
            email=f"dev_{request.user_id}@example.com",
            is_active=True
        )

def serve():
    # 使用 ThreadPoolExecutor 管理并发工作线程
    server = grpc.server(futures.ThreadPoolExecutor(max_workers=10))
    user_service_pb2_grpc.add_UserServiceServicer_to_server(UserService(), server)

    server.add_insecure_port('[::]:50051')
    server.start()
    print("gRPC UserService 已成功启动,监听端口 50051...")

    try:
        while True:
            time.sleep(86400)
    except KeyboardInterrupt:
        server.stop(0)
        print("服务已平滑关闭")

if __name__ == '__main__':
    serve()
5. 编写客户端程序 (client.py)
微服务间调用的客户端必须重视连接管理:建立一个 grpc.Channel 并长期复用,而非每次请求新建 Channel。
import grpc
import user_service_pb2
import user_service_pb2_grpc

def fetch_user_info(user_id: int):
    # 在生产中,channel 应当作为长生命周期单例维护,跨请求复用
    with grpc.insecure_channel('localhost:50051') as channel:
        stub = user_service_pb2_grpc.UserServiceStub(channel)
        try:
            # 发起 RPC 调用,务必设置明确的超时时间(timeout)
            response = stub.GetUser(
                user_service_pb2.UserRequest(user_id=user_id),
                timeout=3.0
            )
            print(f"成功获取用户: ID={response.user_id}, 用户名={response.username}, 邮箱={response.email}")
            return response
        except grpc.RpcError as rpc_error:
            # 捕获专有的 RPC 异常状态码及详情
            print(f"调用失败: 状态码={rpc_error.code()}, 错误原因={rpc_error.details()}")
            return None

if __name__ == '__main__':
    fetch_user_info(1001)
四、REST API 对比实现与基准比对参考
作为对照,下面展示基于现代异步框架 FastAPI 实现同等功能的 REST API 服务与请求逻辑:
# rest_server.py
from fastapi import FastAPI
from pydantic import BaseModel
import uvicorn

app = FastAPI()

class UserResponse(BaseModel):
    user_id: int
    username: str
    email: str
    is_active: bool

@app.get("/users/{user_id}", response_model=UserResponse)
async def get_user(user_id: int):
    return {
        "user_id": user_id,
        "username": f"developer_{user_id}",
        "email": f"dev_{user_id}@example.com",
        "is_active": True
    }

if __name__ == '__main__':
    uvicorn.run(app, host="0.0.0.0", port=8000)
# rest_client.py
import httpx
def fetch_user_rest(user_id: int):
# 使用长连接 Client 减少重复建连耗时
with httpx.Client(base_url="http://localhost:8000") as client:
try:
response = client.get(f"/users/{user_id}", timeout=3.0)
response.raise_for_status()
user_data = response.json()
print(f"REST获取数据成功: {user_data}")
return user_data
except httpx.HTTPError as exc:
print(f"REST请求异常: {exc}")
return None典型负载与传输性能基准特征
在结构一致的数据集传输实验中,二者表现出如下明显的特征差异:
| 测试指标 / 特征 | REST API (FastAPI + JSON) | gRPC (Python grpcio + Protobuf) | 性能差异成因说明 |
|---|---|---|---|
| 单一数据包载荷体积 | 约 98 Bytes(含完整字段文本) | 约 38 Bytes(二进制纯值与Tag) | Protobuf 无字段键名冗余,数字采用变长压缩 |
| 万次请求整体吞吐耗时 | 基准线(1.0x 相对耗时) | 降低 35% ~ 60% 传输耗时 | 单 TCP 连接多路复用,省去连接排队与TCP握手开销 |
| Python 进程 CPU 消耗 | 较高(JSON 反复词法分析) | 较低(底层 C/C++ 扩展直接解构) | Protobuf 在 CPython 下可绕过纯 Python 文本解析损耗 |
| 网络带宽消耗 | 基准(易受重复标头影响) | 极小(HPACK 压缩 + 二进制流) | 在跨机房或微服务网格通信时能节省可观的公网/内网流量 |
五、生产环境通信治理与混合架构模式
在成熟的微服务架构中,并非“非此即彼”的单选,业界普遍采纳“外网 RESTful、内网 gRPC”的混合拓扑架构。
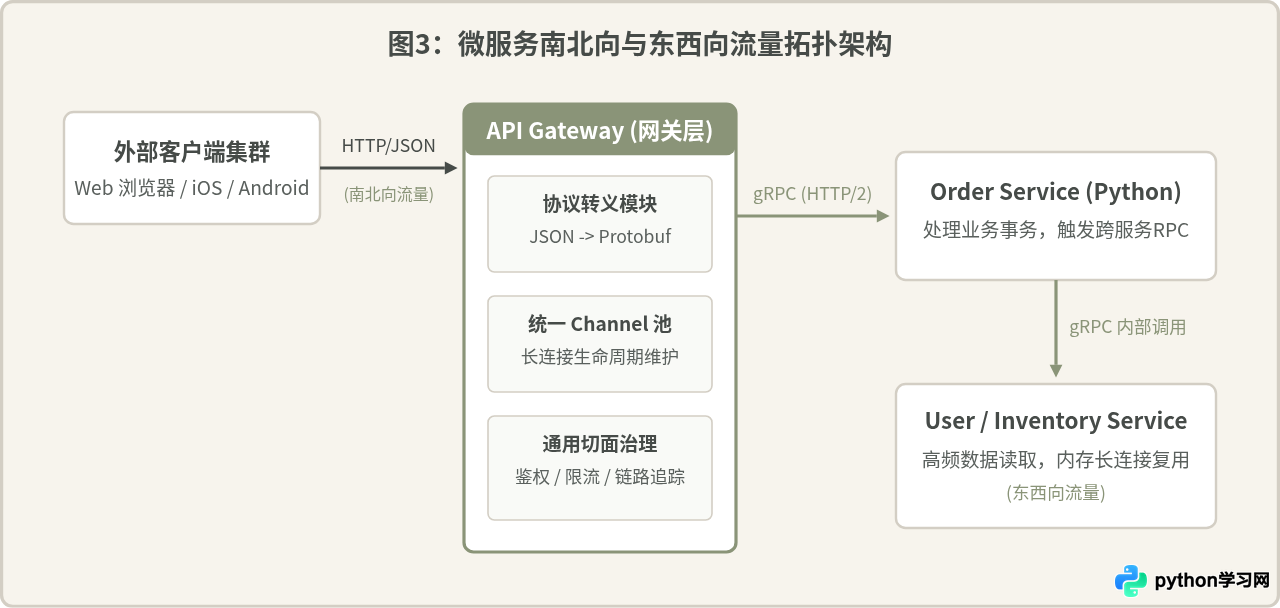
在实现这一架构时,必须特别注意以下两点运维与治理注意事项:
-
保持 Channel 单例与连接复用:创建 gRPC Channel 是重量级操作(包含解析服务名、SSL握手、初始化 HTTP/2 会话等)。千万不要在每一个接口调用内部使用
with grpc.insecure_channel(...),而应在应用启动时初始化全局 Channel,整个进程生命周期内复用。 - 负载均衡注意事项:由于 gRPC 基于 HTTP/2 的长连接多路复用,传统的四层(L4)负载均衡器(如普通 TCP 转发模式下的 LVS / Nginx stream)无法把同一个 TCP 连接上的多个请求分发给不同后端实例,极易引发后端节点负载不均。在生产环境部署时,必须引入能够理解 HTTP/2 帧的七层(L7)代理(如 Envoy、Traefik,或 Kubernetes 的 Ingress / Service Mesh)来进行基于请求的精准负载均衡。
六、综合选型决策指南
最后,通过一张清晰的决策总结图与比对准则,帮助团队在实际微服务项目中快速找到最佳方案:
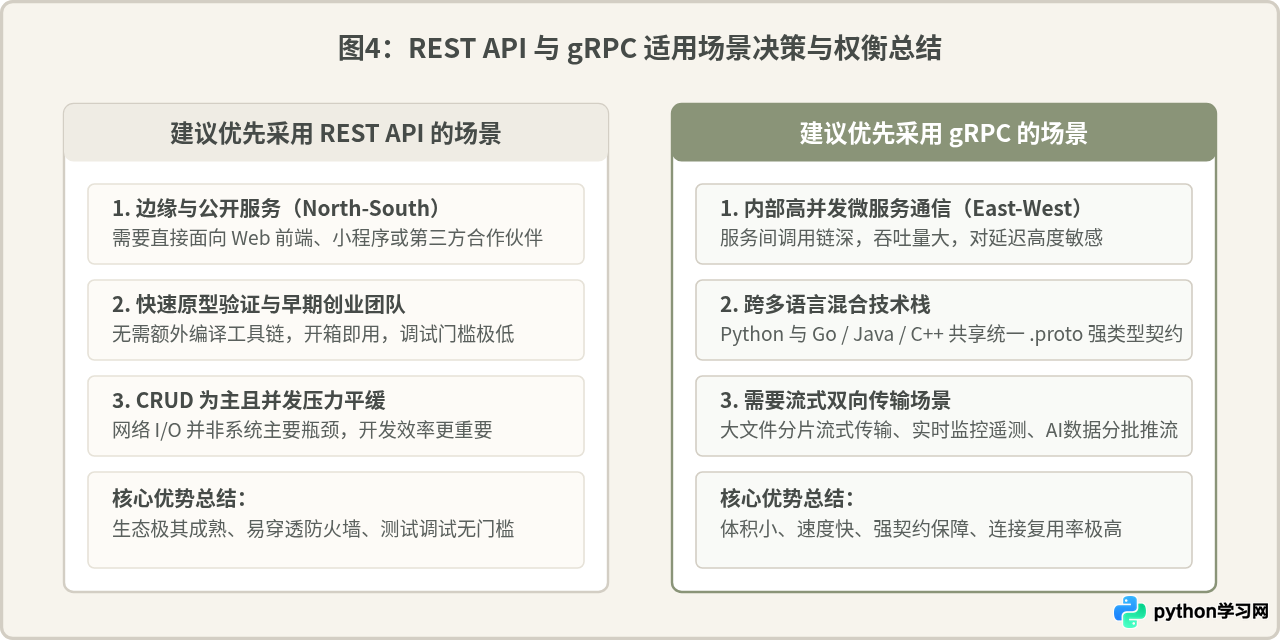
总结而言,对于初建团队或以Web前台直接交互为主的系统,采用 REST API 能够最大限度保留灵活性与调试效率;而当系统演进至中大型规模、服务间网络I/O与序列化成为可度量的瓶颈时,将内部集群改建为 gRPC 通信则是压降延迟、提升硬件利用率的标准解法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















