


Python保存中文网页内容到文件乱码解决

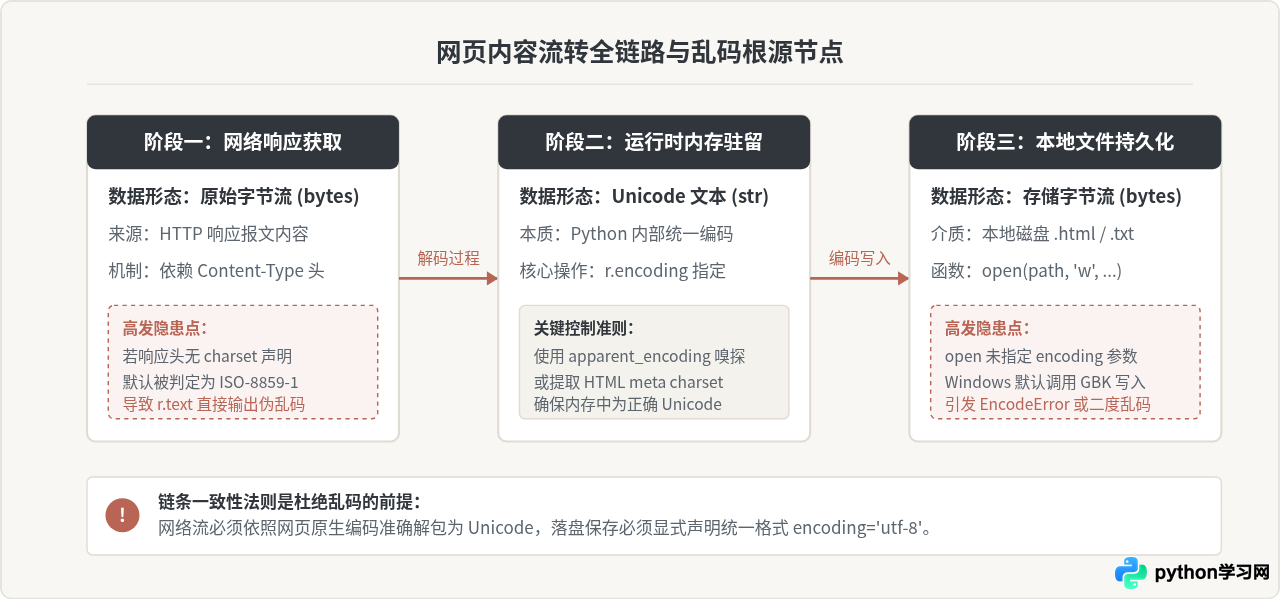
在使用 Python 抓取并保存中文网页时,出现乱码的核心原因在于“网页网络字节流解码为内存字符串”与“内存字符串编码写入本地文件”这两个阶段中存在编码标准不匹配。通常表现为两类经典现象:一是请求库(如 requests)未准确识别网页实际字符集而默认按 ISO-8859-1 解码,使中文变成类似“æµè¯”的拉丁拼贴;二是本地文件写入时省略了编码参数,系统在 Windows 环境下默认使用 GBK 编码写入导致抛出 UnicodeEncodeError 或在 UTF-8 编辑器中展示为乱码。解决该问题的标准路径是:精准确定网页源编码并正确解码,随后在落盘时显式指定 encoding='utf-8' 保存。
一、抓取阶段解码失配的成因与修复
在主流网络爬虫与数据采集中,使用 requests 库获取网页是最常见的操作。然而,很多开发者在获取数据时习惯直接调用 response.text,这就是第一道乱码陷阱的来源。
requests 在解析 response.text 时,会自动根据 HTTP 响应头部的 Content-Type 中的 charset 字段来决定使用何种字符集进行解码。例如:
Content-Type: text/html; charset=UTF-8如果目标服务器在响应头中明确声明了 charset=UTF-8,requests 会自动设置 response.encoding = 'utf-8',此时直接打印或提取文本并不会出现异常。但大量中文网站在响应头中仅输出 Content-Type: text/html,并没有附带具体的编码信息,真正的编码声明实际上隐藏在 HTML 源码的 <meta charset="utf-8"> 标签中。
依据 HTTP/1.1 (RFC 2616) 早期规范,在没有声明字符集的情况下,客户端应当默认将文本视为 ISO-8859-1(西欧字符集)处理。因此,requests 会将原本是双字节或多字节的 UTF-8 或 GBK 字节流强行按照单字节的 ISO-8859-1 解析,最终导致原本的汉字被拆分为无意义的西欧扩展拉丁字符。
针对抓取阶段的精准修复方案
要解决抓取阶段的解码问题,核心在于“跳过不准确的默认猜测,显式重设正确的解码编码”。具体有以下三种可靠做法:
- 使用智能字符集推测:通过
response.apparent_encoding自动检测。该属性由底层charset_normalizer或chardet库通过对字节流的统计学特征进行分析推导,准确率极高。代码为:response.encoding = response.apparent_encoding。 - 根据网页特征手动指定:如果预先明确目标网站为现代站点,可直接将编码硬编码为
response.encoding = 'utf-8';若为早期政企或教育机构网站,则多为gb2312、gbk或gb18030。 - 直接读取原始二进制流:使用
response.content避开任何由requests自动介入的文本解码,完全保留原始字节流。
二、文件写入阶段编码失配的成因与修复
即便在内存中通过 print() 打印出的中文完全正常,如果写入本地文件时不加注意,依然会在打开文件时遇到乱码,甚至直接在程序执行时中断崩溃。
在 Python 3 中,内置的 open() 函数在写入文本模式(mode='w')下,如果未显式提供 encoding 参数,会自动调用当前运行环境的操作系统的默认区域编码(由 locale.getpreferredencoding() 返回):
- 在 Linux 和 macOS 系统中,默认编码绝大多数情况下为
UTF-8,此时省略参数往往恰好能正常工作。 - 在中文版 Windows 操作系统中,系统默认编码普遍为
GBK(代码页 cp936)。
这就导致了严重的跨平台不一致性:在 Windows 环境下,若抓取的网页内容中包含了超出 GBK 字符集范围的字符(例如特殊标点、数学符号、日韩文字或 Emoji 表情),直接调用 open('page.html', 'w').write(text) 会触发经典错误:
UnicodeEncodeError: 'gbk' codec can't encode character '\u2022' in position 128: illegal multibyte sequence即便文本全部在 GBK 编码表内,生成的本地文件也是 GBK 编码保存的,而绝大多数现代文本编辑器(如 VS Code)以及现代浏览器默认以 UTF-8 打开文件,从而再次看到全屏乱码。
注意:避免写出省略编码的 open(filename, 'w')。规范的 Python 工程代码中,任何文本文件的打开都必须显式包含 encoding='utf-8' 参数,以屏蔽不同操作系统的环境差异。
三、两种具体保存方式的实现范例
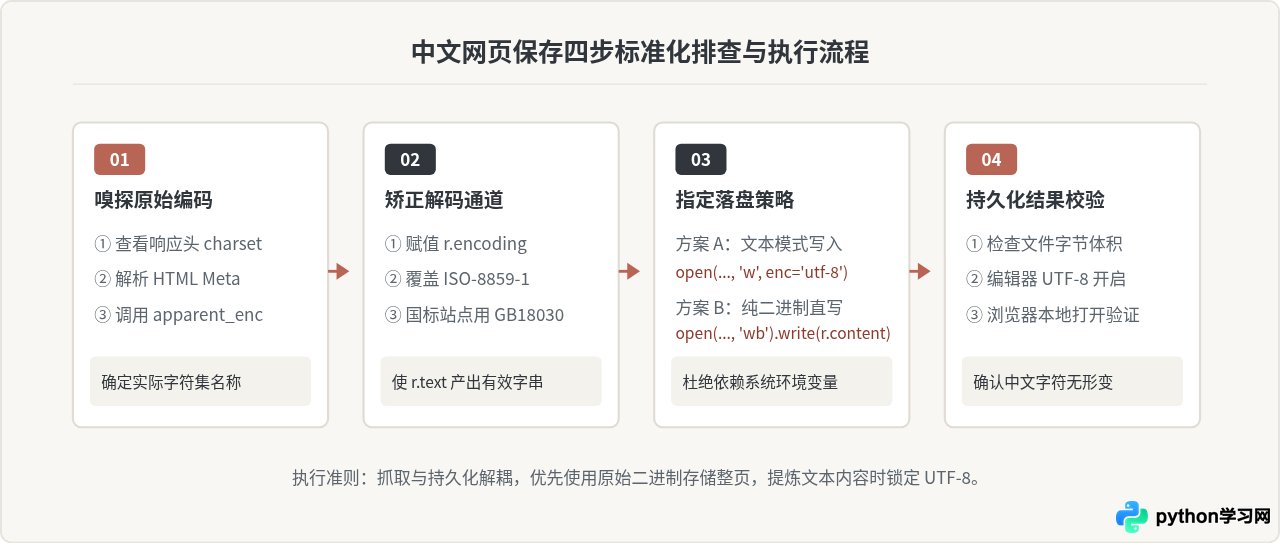
针对保存中文网页的需求,通常分为“整页镜像备份”与“提取纯文本数据保存”两种场景。根据不同的任务目标,对应的代码实现逻辑有所侧重。
1. 场景一:保存完整的 HTML 网页(推荐二进制直写法)
如果目标是将远程网页原汁原味地克隆到本地文件,并在本地浏览器中双击浏览,最稳妥、最抗干扰的方法是直接将 response.content 写入二进制文件,完全不经过 Python 运行时的文本编解码环节。
import requests

url = "https://example.com/chinese_article.html"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

response = requests.get(url, headers=headers)
response.raise_for_status()

# 核心:使用 'wb' 二进制模式写入原始字节流
with open("page_mirror.html", "wb") as f:
    f.write(response.content)

print("网页完整镜像保存完毕。")原理说明:网页文件内部自带 <meta charset="..."> 标签。浏览器在读取本地 .html 文件时,会自行解析其 meta 标签中注明的字符集来渲染字形。直接保存字节流避免了 Python 错误的二次重编码,杜绝了由于转换字符集而破坏原本网页内部声明的情况。
2. 场景二:清洗后保存为文本或指定 UTF-8 HTML 文件
如果需要在 Python 中对网页文本进行清洗、分词、正则提取或内容重组,随后保存到本地文件,则必须经过内存中的 Unicode 字符串转换。此时必须使用正确的解码赋值,并显式指定 encoding='utf-8' 写入。
import requests

url = "https://example.com/chinese_news.html"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

response = requests.get(url, headers=headers)
response.raise_for_status()

# 环节一:正确解码
# 优先根据内容本身推导真实编码,避免依赖可能不准确的 HTTP 头
if response.encoding.lower() == 'iso-8859-1' or not response.encoding:
    response.encoding = response.apparent_encoding

# 环节二:规范写入
# 显式使用 utf-8 编码落盘,跨平台(Windows/Linux/macOS)表现完全一致
with open("article_cleaned.html", "w", encoding="utf-8") as f:
    f.write(response.text)

print("文本处理内容保存完毕。")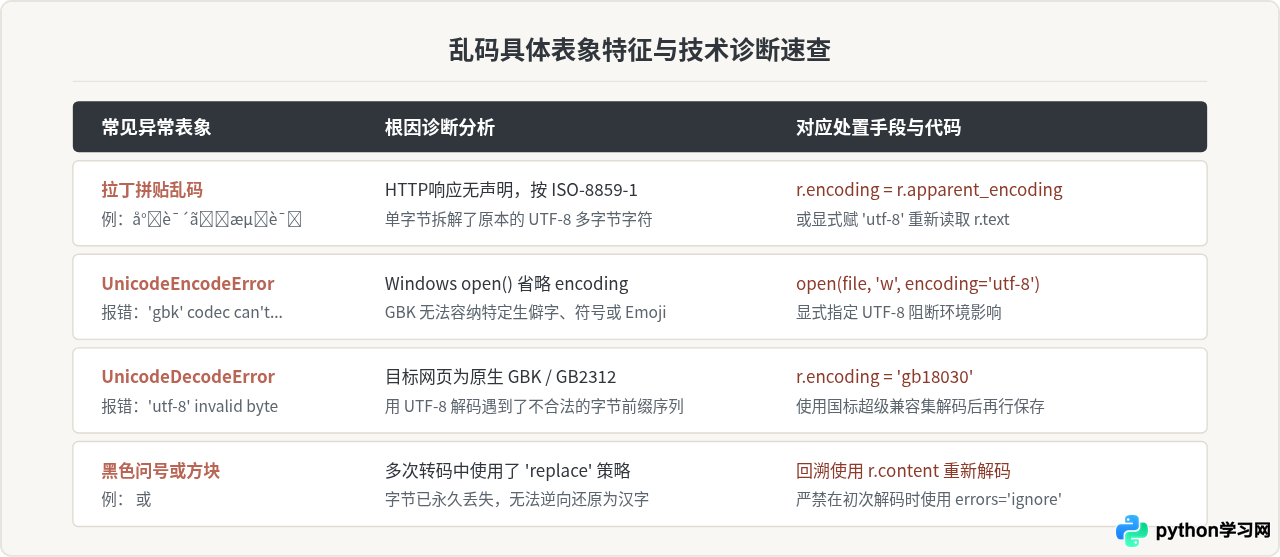
四、复杂与边缘场景排查
在面对部分结构特殊的站点时,即便执行了基础的编码配置,可能依然会遇到意外情况。以下列出三种典型的边界场景与应对机制:
1. 针对国内老旧政企站点的 GB18030 兜底策略
国内部分早期建立的政务、科研院所或高校网站,其 HTML 页面内部声明为 gb2312。然而,在实际内容运营中,往往录入了生僻字(如人名、古地名)、繁体字或特殊符号,这些字符已经超出了严格的 GB2312 标准范围。
如果直接使用 gb2312 或 gbk 解码,经常会遇到个别汉字抛出解码异常。在 Python 中,应当优先选用国标扩展超集 gb18030:
# 针对声称是 gb2312/gbk 的网页,统一采用 gb18030 解码容错性最高
try:
    html_text = response.content.decode('gb18030')
except UnicodeDecodeError:
    html_text = response.content.decode('utf-8', errors='replace')
2. 压缩内容未自动解压导致的假乱码
如果请求头中手动添加了 Accept-Encoding: gzip, deflate, br,但使用了底层库(如自定义 urllib 请求或直接通过 socket 交互),服务器返回的原始字节流是经过压缩的二进制数据。在未解压的情况下直接以文本方式打开,会呈现完全不可读的符号串。在使用 requests 时,库会自动根据 Content-Encoding 头解压,但若自行封装 urllib.request,则需结合 gzip.decompress() 先行解压再执行解码。
3. Windows 记事本的 UTF-8 BOM 兼容
在将保存的 HTML 或文本文件交由非开发人员在 Windows 记事本中打开时,偶发首行中文乱码或出现隐藏占位符。这通常是因为 Python 写入的普通 utf-8 文件不包含 Byte Order Mark (BOM)。如需针对老版本 Windows 工具完全兼容,可显式指定编码为 utf-8-sig:
with open("output.html", "w", encoding="utf-8-sig") as f:
    f.write(response.text)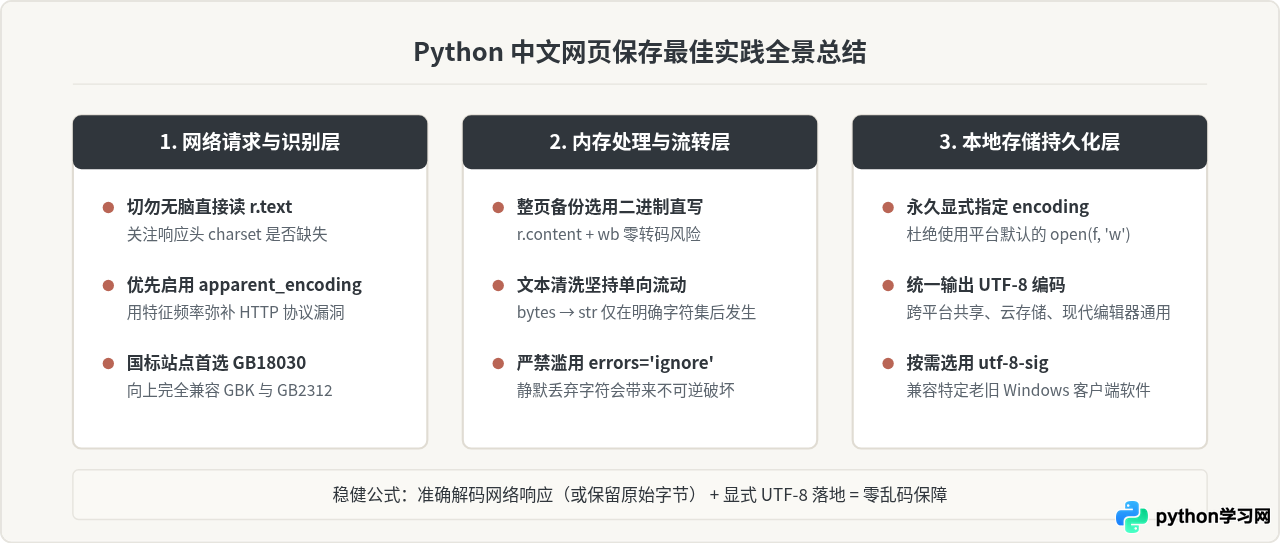
五、工程化通用保存脚本模板
在实际生产环境中,抓取的 URL 来源可能非常多样。以下提供一个具备自动探测、智能回退以及防错落盘机制的通用保存函数,可直接用于实际项目:
import os
import re
import requests

def save_webpage(url: str, output_path: str, as_binary: bool = False) -> bool:
    """
    通用中文网页抓取并安全保存至本地文件

    :param url: 目标网页网址
    :param output_path: 本地保存路径
    :param as_binary: 是否以二进制直接存储原始网页
    :return: 是否保存成功
    """
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/120.0.0.0 Safari/537.36"
        )
    }

    try:
        response = requests.get(url, headers=headers, timeout=15)
        response.raise_for_status()

        # 确保输出目录存在
        output_dir = os.path.dirname(output_path)
        if output_dir and not os.path.exists(output_dir):
            os.makedirs(output_dir, exist_ok=True)

        # 模式一:针对完整页面的二进制安全存储
        if as_binary:
            with open(output_path, "wb") as f:
                f.write(response.content)
            return True

        # 模式二:经过编码矫正后的 UTF-8 文本存储
        # 1. 检测 HTML 中是否有 meta 标签声明字符集
        content_prefix = response.content[:1024].decode('ascii', errors='ignore')
        meta_match = re.search(r'charset=["\']?([\w\-]+)', content_prefix, re.IGNORECASE)

        if meta_match:
            encoding_candidate = meta_match.group(1).lower()
            # 针对国内 GB2312/GBK 统一提升为 GB18030 超集以防生僻字报错
            if encoding_candidate in ['gb2312', 'gbk']:
                response.encoding = 'gb18030'
            else:
                response.encoding = encoding_candidate
        else:
            # 2. 借助 apparent_encoding 进行统计学推断
            response.encoding = response.apparent_encoding or 'utf-8'

        # 3. 显式以 UTF-8 格式落盘保存
        with open(output_path, "w", encoding="utf-8") as f:
            f.write(response.text)

        return True

    except Exception as e:
        print(f"保存网页失败: {url}, 错误信息: {e}")
        return False


if __name__ == "__main__":
    test_url = "https://www.example.com"
    target_file = "downloaded_page.html"
    success = save_webpage(test_url, target_file)
    if success:
        print(f"成功安全保存至: {target_file}")
通过规范化的解码设置与显式的 utf-8 写入流程,无论是在 Windows 还是 Linux 服务器上,无论目标网站采用 UTF-8 还是 GBK 系列字符集,都可以从根本上阻断乱码的生成通道,保障数据资产的准确与完整。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















