


Python列表切片详解:start:stop:step语法与省略规则

sequence[start:stop:step],遵循“左闭右开”的区间提取机制。理解切片的关键在于弄清三元组参数的物理意义、缺省时的隐式推导逻辑,以及步长为负时的反向取样行为。本文将从底层模型、边界计算到常见陷阱展开完整解析。
一、切片核心语法:三元组参数与切分点边界模型
在 Python 中,不仅是列表(list),元组(tuple)、字符串(str)等序列类型都原生支持切片语法。切片表达式包含三个以冒号分隔的参数:
sliced_list = sequence[start:stop:step]这三个参数各司其职,共同决定了最终提取子序列的范围和步进节奏:
- start(起始索引):切片提取的起点位置。提取结果包含该位置对应的元素。
- stop(终止边界):切片提取的终止边界。提取结果不包含该边界位置对应的元素,即经典的左闭右开区间
[start, stop)。 - step(步长与方向):每次移动的索引跨度。默认值为 1,符号决定取样方向(正数向右前进,负数向左后退)。
许多初学者对“左闭右开”感到困惑,常常误算提取结果的长度。最清晰的理解方式是将索引视为元素之间的切分线(边界点),而不是元素本身的格子。
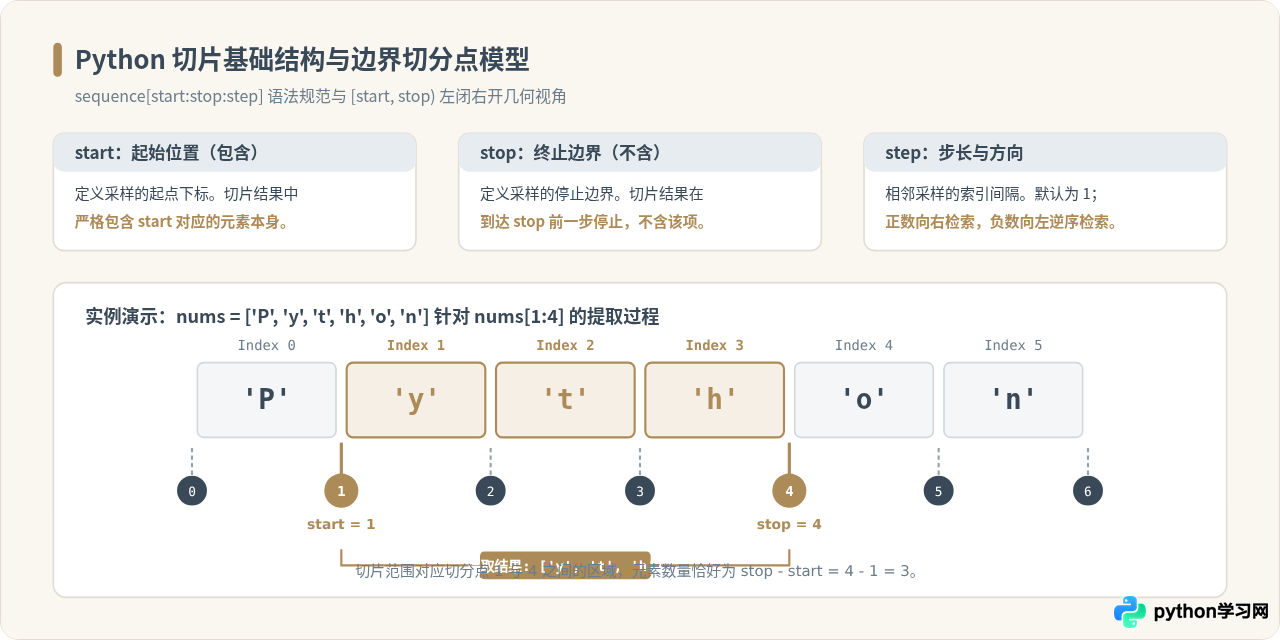
从图 1 可以看出,切分点从 0 开始直到序列长度(len=6)。切片 nums[1:4] 的边界落在切分点 1 与切分点 4 之间,正好框选出 'y'、't'、'h' 三个元素。这种设计的一个极佳优势是:在步长为 1 时,切片返回的元素个数始终等于 stop - start。
二、省略规则深度解析:缺省值的自动推导逻辑
在实际开发中,开发者很少显式写满全部三个参数。例如 nums[:3]、nums[2:] 或 nums[:]。这些省略并非随意截断,而是由 Python 解释器在内部执行严格的默认值补全。
参数省略的核心判断依据是:步长 step 的正负符号。当参数未传入(或显式传入 None)时,解释器会根据前进方向自动判定端点:
| 参数形态 | step 方向 | start 缺省值 | stop 缺省值 | 等效语义 |
|---|---|---|---|---|
[start:stop] |
默认 step = +1(正向) | 0(序列头部) | len(s)(序列尾部切点) | 提取 [start, stop) 范围 |
[:stop] |
正向(step > 0) | 0 | 显式传入 stop | 提取序列前缀(前 stop 项) |
[start:] |
正向(step > 0) | 显式传入 start | len(s) | 从 start 一直提取到末尾 |
[:] |
正向(step > 0) | 0 | len(s) | 生成全列表浅拷贝 |
[::-1] |
反向(step = -1) | len(s) - 1(最后一个元素) | 超出头部之前(包含索引 0) | 翻转整个序列 |
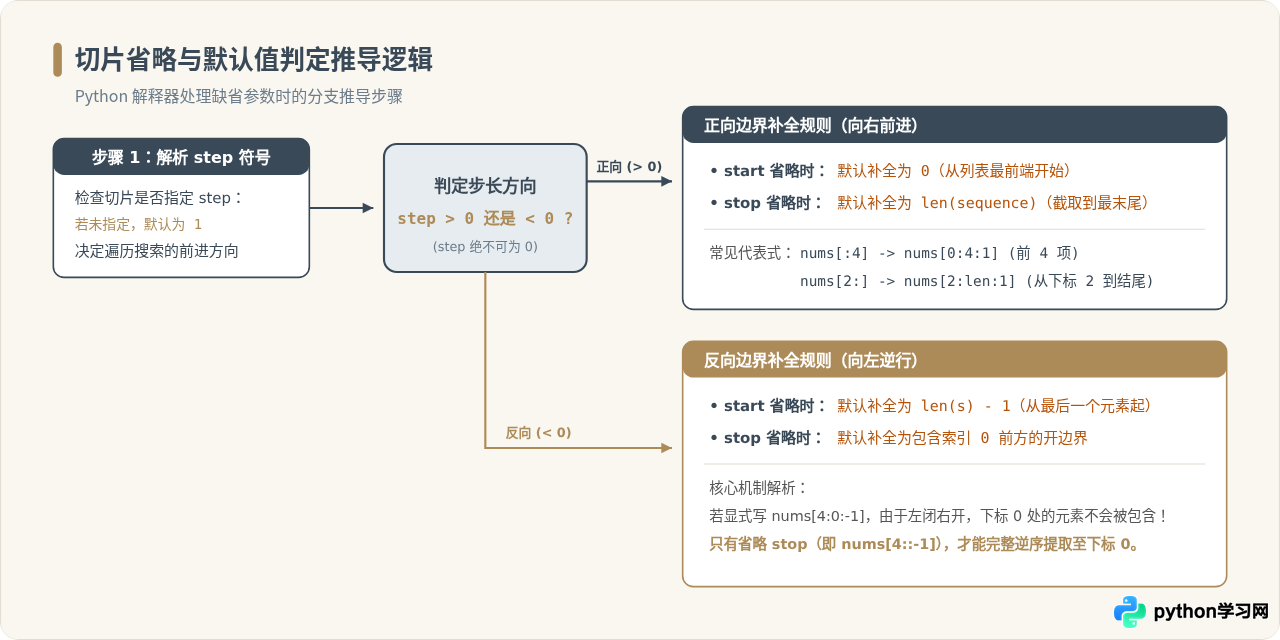
如图 2 所示,省略行为并非固定绑定到索引 0 或末尾,而是自适应步进方向。理解这一点,就能彻底看懂为什么 nums[::-1] 可以完美反转列表,而不需要开发者手动计算末位下标。
三、步长 step 正负控制与逆序切片机制
步长参数(step)是切片中最具表现力但也最容易出错的部分。它不仅控制采样的跳跃幅度,更掌管着遍历的前进方向。
1. 正向跳步提取
当 step > 1 时,切片以固定间隔跳过元素。例如提取奇偶项:
data = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

even = data[::2]   # 提取偶数索引项: [0, 2, 4, 6, 8]
odd  = data[1::2]  # 从索引1开始隔项提取: [1, 3, 5, 7, 9]
2. 逆向提取与经典方向冲突陷阱
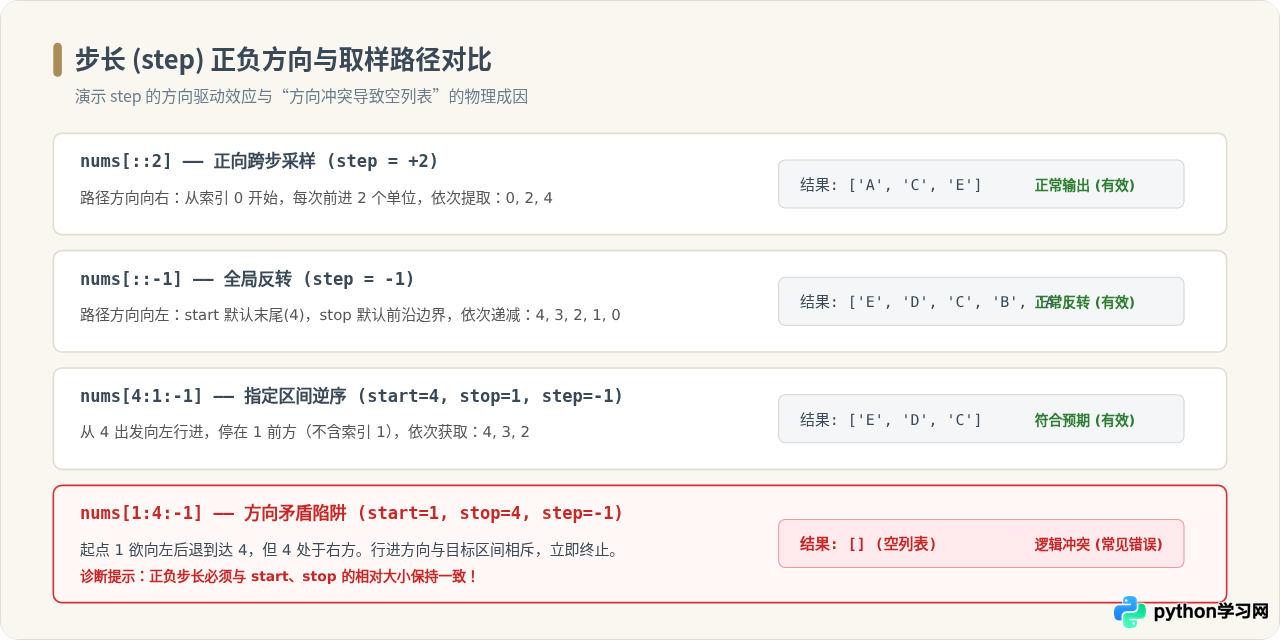
当 step < 0 时,索引每次迭代减少 |step|。这意味着:start 的位置必须在 stop 的右侧(即 start > stop),否则循环一步也无法推进,将直接返回空列表 []。
nums[1:4:-1] 的代码,期望以逆序获取下标 1 到 4 的内容。然而在 Python 中,起点是 1,步长为 -1 要求向左查找,而终点 4 位于 1 的右方。探测方向与目标完全背道而驰,因此立即终止并返回 []。正确的逆序写法应为 nums[4:1:-1](获取下标 4, 3, 2 的元素)。
四、进阶特性:越界容错、浅拷贝与切片赋值
1. 切片超界容错机制
在普通索引访问中,传入不存在的下标会直接抛出 IndexError:
nums = [1, 2, 3]
# print(nums[10])  # 抛出 IndexError: list index out of range
但切片操作具备天然的边界保护机制。无论 start 或 stop 超出序列实际长度多远,Python 都会自动将其截断为合法边界,绝不报错:
nums = [1, 2, 3]
print(nums[1:100])  # 输出: [2, 3]
print(nums[50:100]) # 输出: []
这一特性在处理不确定长度的分批数据、截取文本前缀时非常安全方便。
2. 切片赋值:就地修改原列表
切片不仅能用于读取,当放置在赋值操作符左侧时,能够直接修改、替换、插入或清空原列表的内部元素,且保持列表自身的内存地址(id)不变:
letters = ['a', 'b', 'c', 'd', 'e']

# 1. 替换子区间(元素个数无需相等)
letters[1:3] = ['X', 'Y', 'Z']
print(letters)  # 输出: ['a', 'X', 'Y', 'Z', 'd', 'e']

# 2. 原地清空列表(保留同一对象引用)
letters[:] = []
print(letters) # 输出: []step)进行赋值时,右侧赋值对象的长度必须严格等于切片提取出的位置数量,否则会触发 ValueError: attempt to assign sequence of size X to extended slice of size Y。
五、总结与速查清单
为了在日常编写代码时迅速做出准确判断,以下将 Python 列表切片的核心规则与最佳实践汇总于一张全景知识卡中:
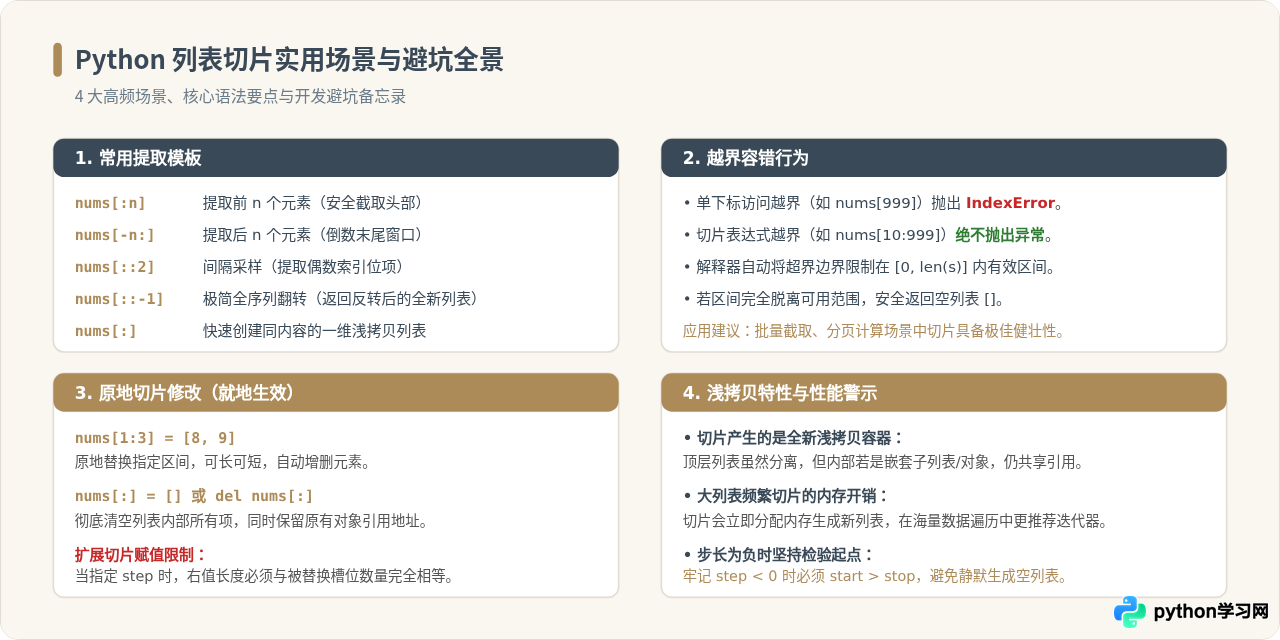
掌握 start:stop:step 的左闭右开模型、自动省略机制以及步长方向约束,不仅能写出更加简洁优雅的 Python 代码,也能彻底杜绝因索引偏移导致的各种隐蔽逻辑错误。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















