


Python sleep延时不准是怎么回事?影响精度的因素与优化

在 Python 开发中,time.sleep() 是最常用来让程序暂停执行的函数。然而很多开发者在尝试实现毫秒级延时或固定频率循环时,会发现传入 time.sleep(0.001) 实际等待时间往往高达 10 到 16 毫秒,甚至在不同系统和机器上波动极大。这是因为 time.sleep() 并非硬件级精确时钟,它的核心语义是“挂起当前线程至少指定时长”,实际唤醒时刻受制于操作系统的时钟中断频率、进程调度机制以及 Python 运行时的开销。理解这些底层机制,并在不同业务需求下选用系统提频、绝对时间对齐或混合休眠方案,是解决延时漂移的关键。
一、为什么 time.sleep 无法做到毫秒级精准?
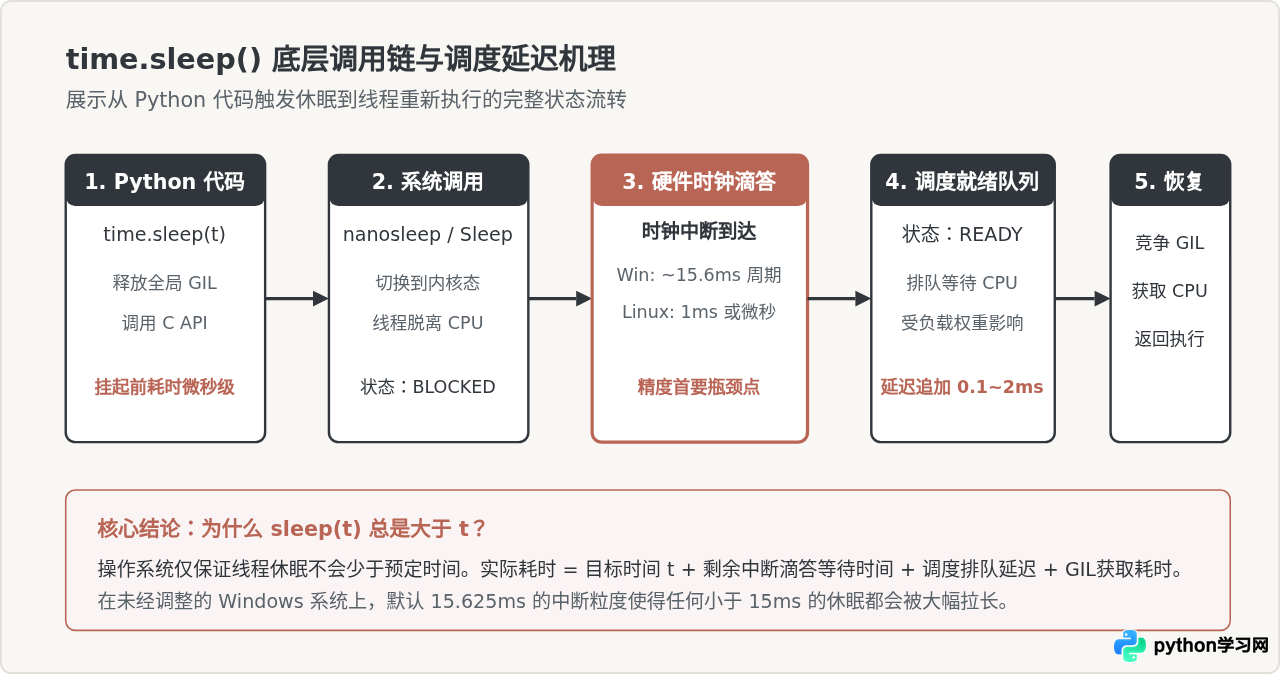
当在 Python 中执行 time.sleep(seconds) 时,Python 解释器并不会占用 CPU 进行倒计时,而是通过 C 语言扩展层调用宿主操作系统的延时系统调用(在 Windows 上通常是 Sleep(),在类 Unix 系统上则是 nanosleep() 或 select())。此时,操作系统内核会将当前线程标记为休眠状态,并将其从可运行队列移出,释放 CPU 核心供其他任务使用。
问题正出在线程被重新唤醒的过程:操作系统调度器依赖周期性的硬件时钟中断(Clock Tick)来检查各个休眠线程是否到期。如果时钟中断的周期是 15.625 毫秒(即每秒约 64 次中断),即便只申请睡眠 1 毫秒,操作系统在下一个时钟滴答到来之前也根本无法发现睡眠已到期。此外,唤醒后线程进入“就绪队列”,还需要等待 CPU 分配时间片,并重新获取 Python 的全局解释器锁(GIL),最终导致恢复执行的时间显著滞后。
二、影响 Python 延时精度的核心因素剖析
要在实践中控制延时误差,必须具体区分不同操作系统平台和运行时机制所带来的影响因素:
1. 操作系统时钟中断分辨率(Timer Resolution)
这是造成毫秒级延时不准的最主要硬件/内核限制:
- Windows 系统:默认的时钟分辨率通常是 15.625 毫秒(基于每秒 64 次的时钟滴答)。当调用
time.sleep(0.001)时,内核计时器直到下一个 15.625ms 边界才会唤醒线程,因此实际测量值普遍落在 15ms 左右。当系统运行 Chrome、大型游戏或特定媒体播放器时,这些程序会请求系统将时钟分辨率提升至 1ms,此时 Python 的 sleep 精度会“神奇地”变高;一旦关闭这些软件,精度又会跌回 15.6ms。 - Linux 系统:现代 Linux 内核普遍启用了高精度定时器(
CONFIG_HIGH_RES_TIMERS),配合nanosleep()能够达到微秒甚至亚毫秒级别的分辨率。但在低配置虚拟机或未开启高精度定时器的内核配置下,精度仍受内核时钟频率(HZ,例如 100Hz 对应 10ms,250Hz 对应 4ms)的限制。 - macOS 系统:macOS 基于 Mach 架构,提供纳秒级的时间原语,休眠精度通常优于 Windows,但依旧存在 0.5 到 2 毫秒的系统级唤醒偏差。
2. 操作系统多任务调度开销与系统负载
现代操作系统是抢占式多任务系统。当休眠时间到期、中断触发后,当前线程只是从“阻塞状态”转入“就绪状态”,并不意味着能立即占用物理 CPU 核心运行。如果此时系统整体负载较高,或者有其他高优先级进程(如编译器、渲染引擎)在满载运行,当前线程可能需要在就绪队列中排队等待分配时间片,产生额外的几毫秒随机延迟。
3. Python 的 GIL 重新竞争与垃圾回收(GC)
time.sleep() 在挂起前会显式释放 GIL,允许其他 Python 线程在休眠期间并发执行。然而在线程休眠结束被操作系统唤醒后,它必须重新申请并持有 GIL 才能执行下一条 Python 字节码指令。如果在同一进程中有 CPU 密集型线程正在持续占用 GIL,休眠唤醒的线程可能面临“已醒来却拿不到解释器执行权”的窘境。此外,Python 的分代垃圾回收机制(GC Stop-the-world)在触发对象清理时也会引入微秒到毫秒级的瞬间停顿。
4. 循环调用中的“时间漂移(Drift)”累积
在编写类似“每隔 100ms 采样一次”的代码时,许多初学者会这样写:
# 错误示例:存在严重累计漂移
while True:
    do_work()          # 耗时例如 15ms
    time.sleep(0.1)    # 计划延时 100ms,实际例如 102ms
在这种结构中,单次循环的周期是 任务执行时间 + 实际休眠时间。即使每次只多出 2 毫秒,在持续运行数千次循环后,总时间漂移就会达到数秒甚至数分钟,完全脱离预期节拍。
三、排查延时精度的四步流程
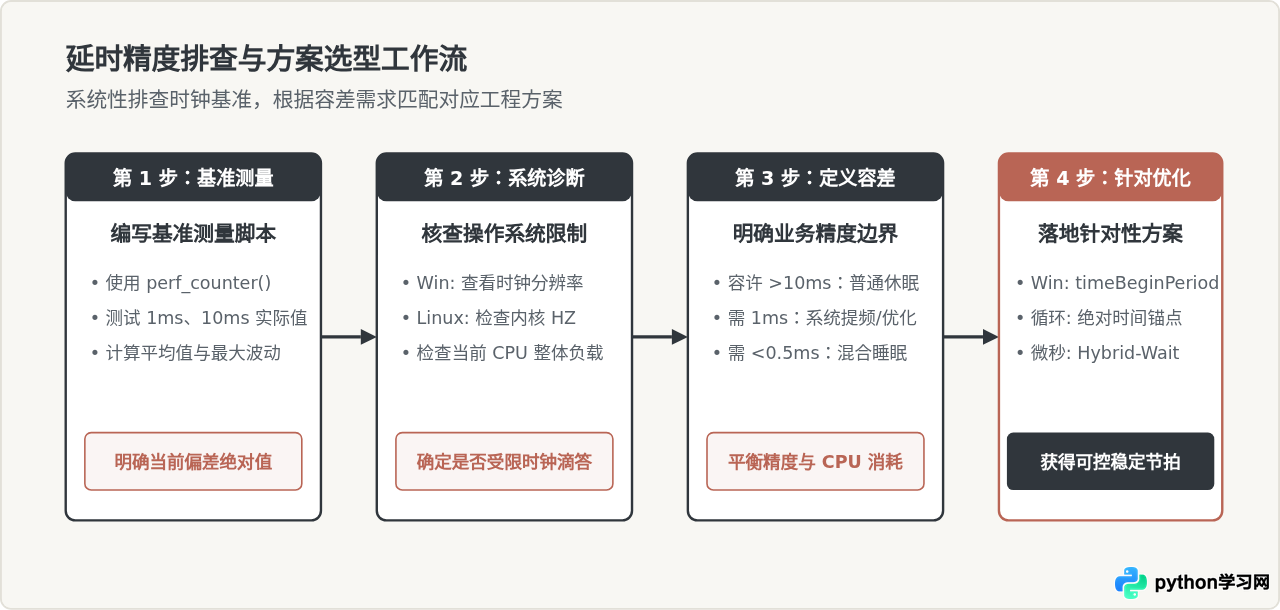
遇到延时偏差时,建议按照如下步骤建立可重复的基准测试,定位精度瓶颈并匹配优化手段:
精度测试验证代码
为了科学评估当前运行环境下的延时真实表现,切勿使用精度受限的 time.time(),必须使用保证纳秒级单调递增的 time.perf_counter() 进行基准测试:
import time

def benchmark_sleep(target_seconds, iterations=10):
    print(f"=== 测试目标休眠时间: {target_seconds * 1000:.2f} ms (重复 {iterations} 次) ===")
    actual_times = []
    for _ in range(iterations):
        start = time.perf_counter()
        time.sleep(target_seconds)
        elapsed = time.perf_counter() - start
        actual_times.append(elapsed * 1000)

    avg_time = sum(actual_times) / len(actual_times)
    min_time = min(actual_times)
    max_time = max(actual_times)
    print(f"平均实际耗时: {avg_time:.3f} ms | 最短: {min_time:.3f} ms | 最长: {max_time:.3f} ms\n")

if __name__ == "__main__":
    benchmark_sleep(0.001)  # 测试 1 毫秒
    benchmark_sleep(0.010)  # 测试 10 毫秒
典型运行输出示例(未经优化的 Windows 系统):
=== 测试目标休眠时间: 1.00 ms (重复 10 次) ===
平均实际耗时: 15.612 ms | 最短: 14.892 ms | 最长: 16.120 ms

=== 测试目标休眠时间: 10.00 ms (重复 10 次) ===
平均实际耗时: 15.704 ms | 最短: 15.110 ms | 最长: 16.350 ms
从示例输出可以清晰观察到:目标 1ms 和 10ms 的休眠最终都被锁定在 15.6ms 附近,直接佐证了操作系统时钟中断分辨率是根本瓶颈。
四、精度优化方案与工程实践
针对不同场景对延时与系统资源的要求,可以采用以下四种递进式的优化方案:
方案一:消除累计漂移——基于“绝对时间基准”对齐
如果业务目标是“以固定频率(例如每 20ms 一次)周期性执行任务”,绝不能每次休眠固定的相对时间。正确的做法是记录下一次循环应当触发的绝对目标时间,动态计算每次需要休眠的差值:
import time

def periodic_task_fixed_frequency(interval=0.02, total_cycles=100):
    # 锚定初始基准时间戳
    next_time = time.perf_counter() + interval
    for cycle in range(total_cycles):
        # 执行业务逻辑
        # do_something()

        # 计算距离下一个预定时间点的剩余时间
        delay = next_time - time.perf_counter()
        if delay > 0:
            time.sleep(delay)

        # 严格按照固定步长推移下一个目标时刻,避免误差滚雪球
        next_time += interval
这种机制即使偶尔某一次任务由于系统卡顿超时,后续循环也会自动压缩休眠时间追赶进度,杜绝长期运行时几分钟级别的累积漂移。
方案二:Windows 平台提升时钟分辨率(timeBeginPeriod)
在 Windows 环境下,可以通过 Python 自带的 ctypes 模块调用 Windows 多媒体 API timeBeginPeriod(1),将系统时钟分辨率从默认的 15.6ms 提升至 1ms。使用完成后必须成对调用 timeEndPeriod(1) 还原,建议使用上下文管理器安全封装:
import sys
import time
from contextlib import contextmanager

@contextmanager
def high_resolution_timer():
    """在 Windows 上临时将全局时钟中断精度提升到 1ms"""
    if sys.platform == "win32":
        import ctypes
        winmm = ctypes.WinDLL("winmm")
        winmm.timeBeginPeriod(1)
        try:
            yield
        finally:
            winmm.timeEndPeriod(1)
    else:
        yield

# 使用示例
with high_resolution_timer():
    start = time.perf_counter()
    time.sleep(0.002)  # 休眠 2ms
    print(f"Windows 优化后耗时: {(time.perf_counter() - start) * 1000:.2f} ms")
# 输出通常稳定在 2.1ms ~ 2.8ms 之间注意:提升时钟中断频率会略微增加系统的唤醒频率和功耗,但在桌面端和外接电源设备上影响微乎其微,非常适合工控通信、UI 刷新与多媒体播放。
方案三:微秒级精度方案——混合等待(Hybrid Sleep / Spin-Sleep)
如果需要实现低于 1 毫秒(例如 200 微秒)的极高精度延时,任何操作系统级的 sleep 挂起都无法满足要求,因为线程上下文切换本身的开销就在数十微秒级别。单纯的 while True: pass 忙轮询虽然精度极高,但会导致单个 CPU 核心占用率飙升到 100%。
最佳的折中工程实践是混合等待(Hybrid Wait):对于较长的等待,先通过 time.sleep() 休眠掉大部分时间,留出约 1.5ms 的缓冲窗口提前唤醒,最后短时间内进行微秒级的紧凑忙等待对齐:
import time

def hybrid_sleep(target_duration):
    """
    兼顾低 CPU 占用与亚毫秒级精度的混合休眠
    target_duration: 目标休眠秒数
    """
    deadline = time.perf_counter() + target_duration

    # 如果剩余时间大于 2 毫秒,先让出 CPU 进行粗粒度休眠
    while True:
        remaining = deadline - time.perf_counter()
        if remaining > 0.002:
            time.sleep(remaining - 0.0015)
        else:
            break

    # 剩余微秒级时间使用紧凑循环忙等待(Busy Wait)精准对齐
    while time.perf_counter() < deadline:
        pass

# 测试 0.5 毫秒(500 微秒)
start = time.perf_counter()
hybrid_sleep(0.0005)
print(f"混合休眠实际用时: {(time.perf_counter() - start) * 1000:.3f} ms")
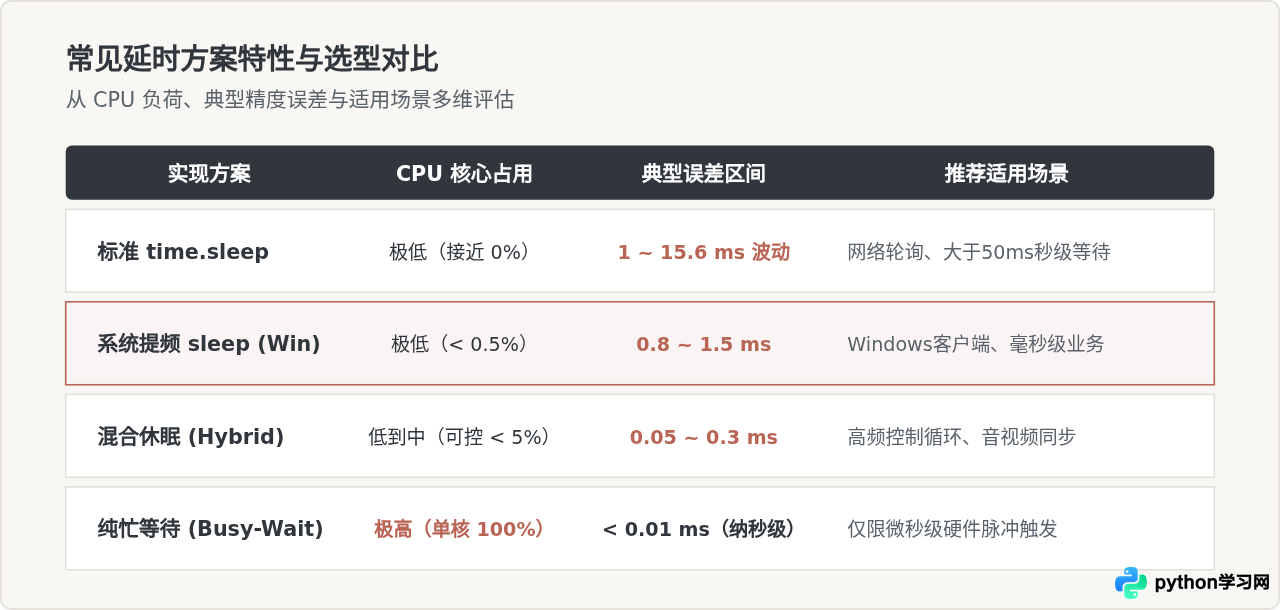
五、不同延时方案的综合性能与选型对比
不同的技术路线在 CPU 开销、误差幅度与环境依赖上存在鲜明的权衡关系:
六、知识总结与工程避坑建议
为了在实际项目中写出稳定、精准的延时控制代码,以下关键准则与总结可作为速查参考:
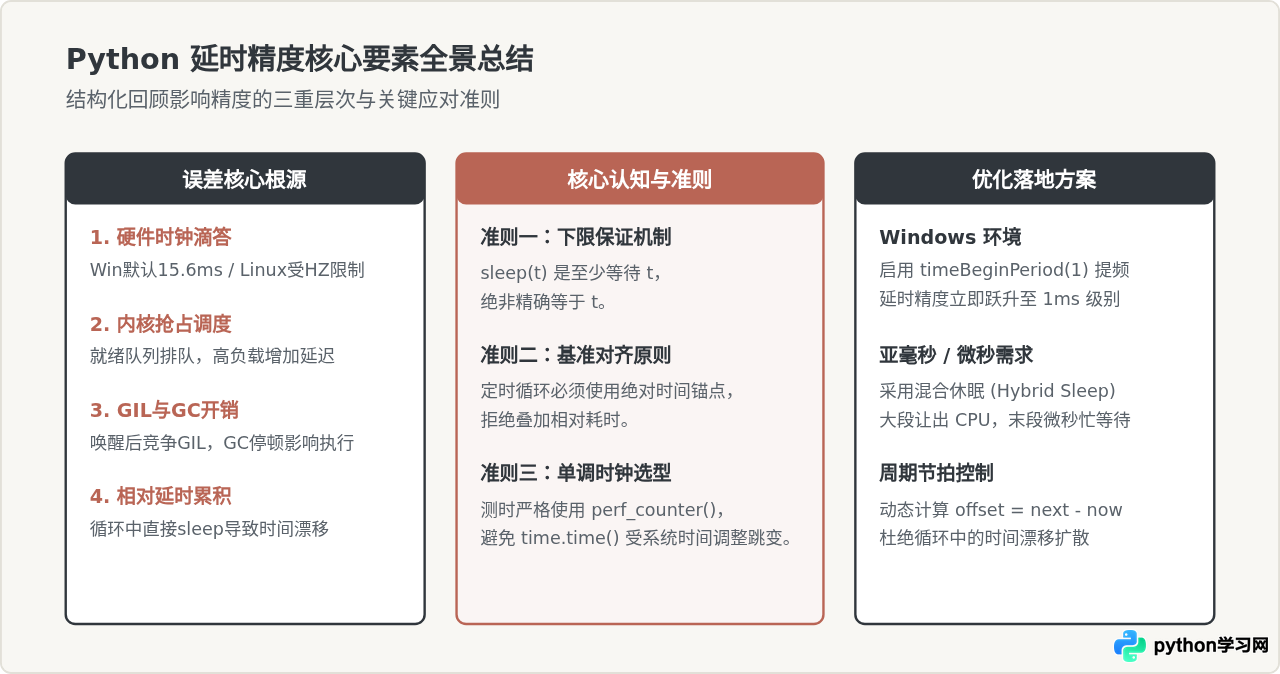
总结:time.sleep() 延时不准是多任务操作系统协同工作下的正常现象。对精度要求不高的秒级任务,直接使用标准 time.sleep() 即可享受极低的 CPU 消耗;若需控制在 1ms 以内,优先在 Windows 下开启系统定时器提频;若需微秒级严格节拍,应结合绝对时间对齐与混合休眠策略,在精度与 CPU 功耗之间取得工程上的最佳平衡。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















