


Python正则提取字符串内容并生成列表的方法

在日常数据清洗与文本解析工作中,我们经常需要从一段混杂着杂质的字符串里提取所有符合特定规则的信息,并将这些信息直接整理为 Python 列表。Python 标准库自带的 re 模块提供了多种实现路径,其中最直接、最常用的是 re.findall() 方法,而在需要字段转换、位置跟踪或逐项清洗的场景下,re.finditer() 结合列表推导式则是更加灵活的选择。本文将系统梳理正则提取并生成列表的核心方法、捕获组对数据结构的影响,以及避免常见匹配陷阱的具体策略。
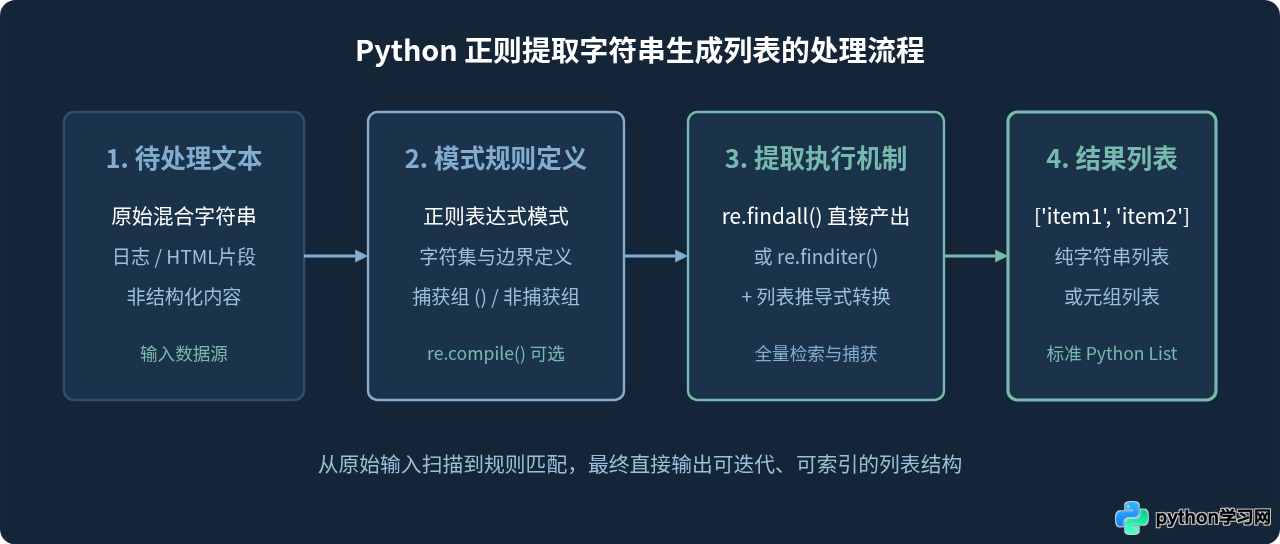
一、使用 re.findall() 直接返回字符串列表
re.findall(pattern, string, flags=0) 是获取列表最直接的函数。它的作用是扫描整个字符串,按从左到右的顺序找出所有非重叠的匹配项,并直接以 Python 列表的形式返回结果。如果没有找到匹配项,则返回一个空列表 []。
示例:提取文本中的所有连续数字
import re

text = "订单A102单价45元,订单B304单价120元,已售出88件。"
# 匹配一个或多个连续数字
pattern = r"\d+"

numbers = re.findall(pattern, text)
print(numbers)
运行结果示例:
['102', '45', '304', '120', '88']re.findall() 提取出的列表元素始终为字符串类型。如果需要进行数值计算或大小比较,还需要对元素进行类型转换,例如使用 [int(x) for x in numbers]。
二、捕获组对 re.findall() 返回列表结构的影响
在编写正则表达式时,圆括号 () 不仅可以用来改变运算优先级,还会创建一个“捕获组(Capturing Group)”。re.findall() 会根据模式中是否包含括号以及包含括号的数量,改变返回列表中元素的形态。这是很多初学者感到困惑的地方。
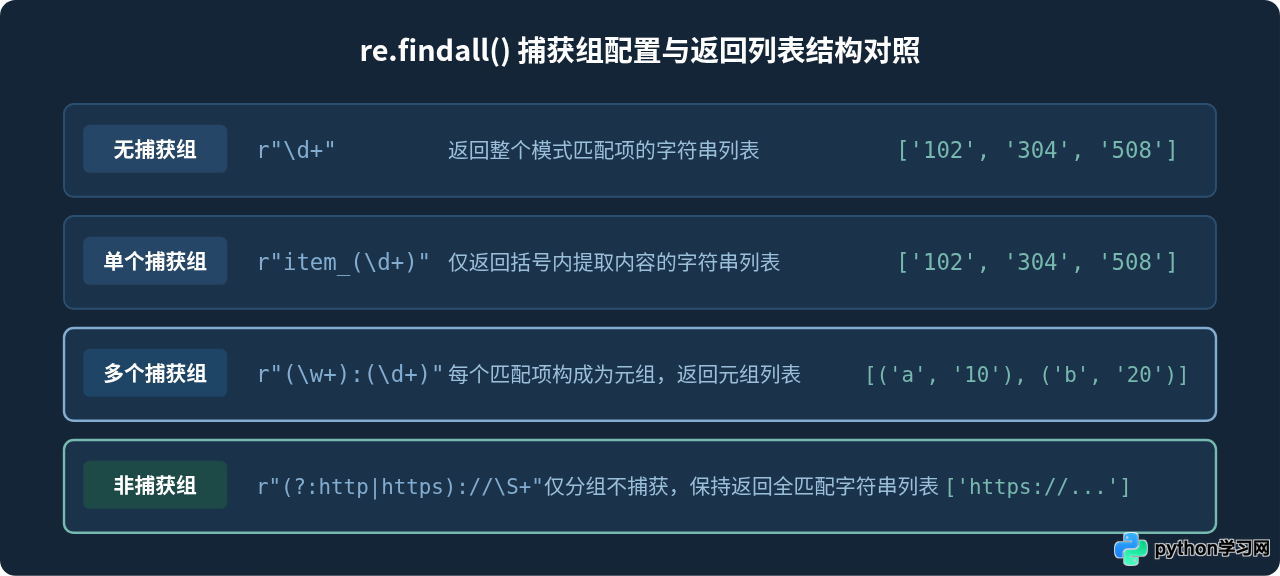
1. 无捕获组:返回完整匹配字符串列表
模式中没有圆括号时,列表每个元素就是每次匹配成功的完整子串。
2. 单个捕获组:只提取组内内容
当只想提取特定标志内部的信息时,将目标部分用括号括起来,findall 会自动忽略括号外的上下文,只把括号内的内容放入列表:
import re

html = '<div class="user">Alice</div><div class="user">Bob</div>'
# 只需要提取人名,因此只对人名部分加括号
pattern = r'<div class="user">(.*?)</div>'

users = re.findall(pattern, html)
print(users)
运行结果示例:
['Alice', 'Bob']3. 多个捕获组:返回由元组组成的列表
当模式中存在两个或更多括号捕获组时,findall 每次匹配都会将各个捕获组按顺序组合成一个元组,最终返回一个元组列表:
import re

log_data = "user=admin;ip=192.168.1.1;status=200\nuser=guest;ip=10.0.0.5;status=403"
# 分别捕获用户名和对应的IP地址
pattern = r"user=(\w+);ip=([\d\.]+)"

records = re.findall(pattern, log_data)
print(records)
运行结果示例:
[('admin', '192.168.1.1'), ('guest', '10.0.0.5')]4. 非捕获组:用 (?:...) 规避元组生成
有时我们需要使用括号来表达“或”关系(例如 (http|https))或者重复出现规则,但又不希望 findall 将其当成捕获组并拆散输出结构。此时应在括号开头添加 ?: 声明为非捕获组:
import re

links = "网站1: https://example.com/a.html, 网站2: http://test.org/b.png"
# 使用 (?:https?://) 匹配协议,但不单独捕获协议名
pattern = r"(?:https?://)[a-zA-Z0-9\.\-_/]+"

url_list = re.findall(pattern, links)
print(url_list)
运行结果示例:
['https://example.com/a.html', 'http://test.org/b.png']三、复杂提取与清洗:re.finditer() 配合列表推导式
re.findall() 虽然简洁,但在实际工程中存在两个局限:一是它会一次性将所有匹配对象生成完整列表,面对超大文本时占用内存较高;二是它直接剥离了匹配元信息(如匹配项在原字符串中的起始索引),且无法在提取过程中即时做数据类型转换。
re.finditer() 则返回一个可迭代的迭代器,每次迭代产生一个 re.Match 对象。将 re.finditer() 与 Python 列表推导式配合,可以在提取的同时完成类型转换、过滤或者字段重组。
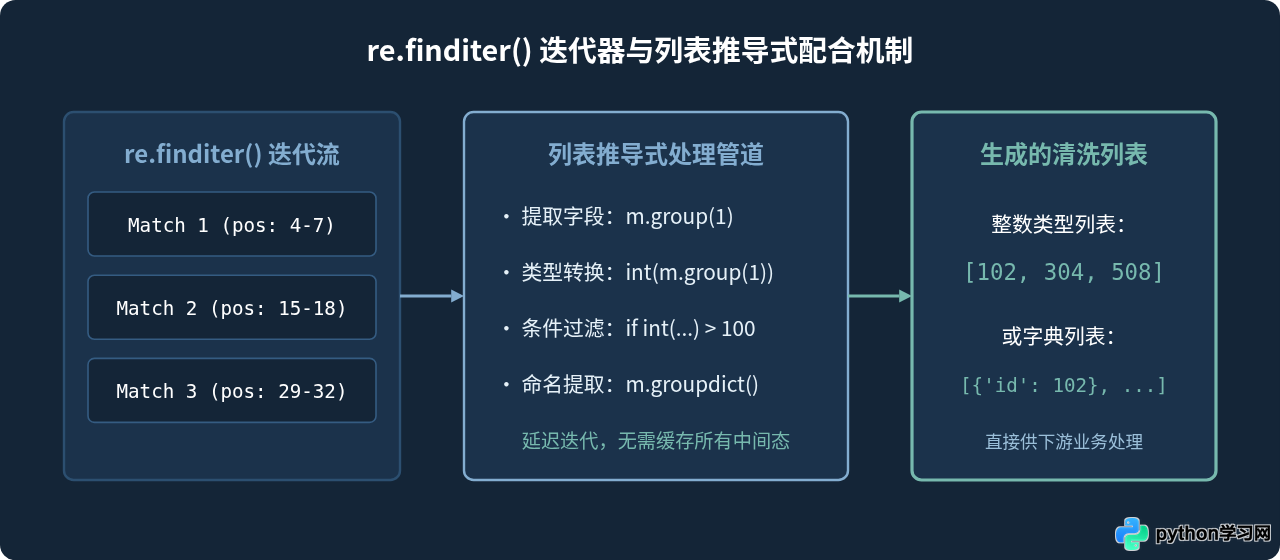
示例:边提取边转换为整数并进行数值过滤
import re

text = "Item1: 85分, Item2: 120分, Item3: 62分, Item4: 150分"
# 仅提取大于100的分数并直接存为整数列表
pattern = r"Item\d+:\s*(\d+)分"

# 列表推导式直接消费迭代器
high_scores = [
    int(match.group(1))
    for match in re.finditer(pattern, text)
    if int(match.group(1)) >= 100
]

print(high_scores)
运行结果示例:
[120, 150]四、使用 re.split() 切分并生成字符串列表
有些任务的目标并不是“提取匹配上的片段”,而是“以正则匹配的内容为分隔符,提取被切开的各个子串”。这时可以使用 re.split() 直接获得切分后的字符串列表。
示例:使用多种符号切分文本生成列表
import re

text = "apple, banana; orange\tgrape    watermelon"
# 匹配逗号、分号或一个及以上的空白字符作为分隔符
pattern = r"[,;\s]+"

items = [item for item in re.split(pattern, text) if item]
print(items)
运行结果示例:
['apple', 'banana', 'orange', 'grape', 'watermelon']re.split() 的模式中使用了捕获括号,例如 r"([,;\s]+)",切分后的列表中将同时保留分隔符本身。如果不希望保留分隔符,请不要使用括号或使用非捕获组 (?:...)。
五、高频处理优化:预编译 re.compile()
当需要在循环内部多次提取字符串,或者在一个大文件中多次调用同一套规则时,建议先使用 re.compile() 将正则表达式编译为 Pattern 对象,再调用其上的 findall() 或 finditer() 方法。这样可以省去每次调用函数时的解析与编译开销,提升执行效率。
import re

lines = [
    "2026-10-01 10:00:00 [INFO] Task-101 started",
    "2026-10-01 10:00:05 [ERROR] Task-102 failed",
    "2026-10-01 10:00:08 [INFO] Task-103 finished"
]

# 预先编译模式对象
task_pattern = re.compile(r"\[(INFO|ERROR)\]\s+(Task-\d+)")

all_tasks = []
for line in lines:
    matches = task_pattern.findall(line)
    if matches:
        all_tasks.extend(matches)

print(all_tasks)
运行结果示例:
[('INFO', 'Task-101'), ('ERROR', 'Task-102'), ('INFO', 'Task-103')]六、典型场景提取实战与避坑要点
1. 贪婪匹配与非贪婪匹配(括号/引号内内容提取)
提取两个标记之间的内容时,默认的 .* 是贪婪匹配,会尽可能匹配最长的字符直到最后一个结尾标记,导致中间所有内容被合并为一个元素。此时必须在量词后加 ? 启用非贪婪匹配:
import re

text = "【公告】关于系统升级【通知】关于放假安排"

# 错误写法(贪婪):['公告】关于系统升级【通知']
greedy_list = re.findall(r"【(.*)】", text)

# 正确写法(非贪婪):['公告', '通知']
non_greedy_list = re.findall(r"【(.*?)】", text)

print("贪婪匹配结果:", greedy_list)
print("非贪婪匹配结果:", non_greedy_list)
2. 展平由元组构成的多层列表
当使用了多个捕获组提取数据,但最终业务需要一个扁平的一维列表时,可以使用嵌套列表推导式:
tuple_list = [('admin', '192.168.1.1'), ('guest', '10.0.0.5')]
flat_list = [item for sub in tuple_list for item in sub]
print(flat_list)
# 输出示例: ['admin', '192.168.1.1', 'guest', '10.0.0.5']
七、方法选型全景与决策建议
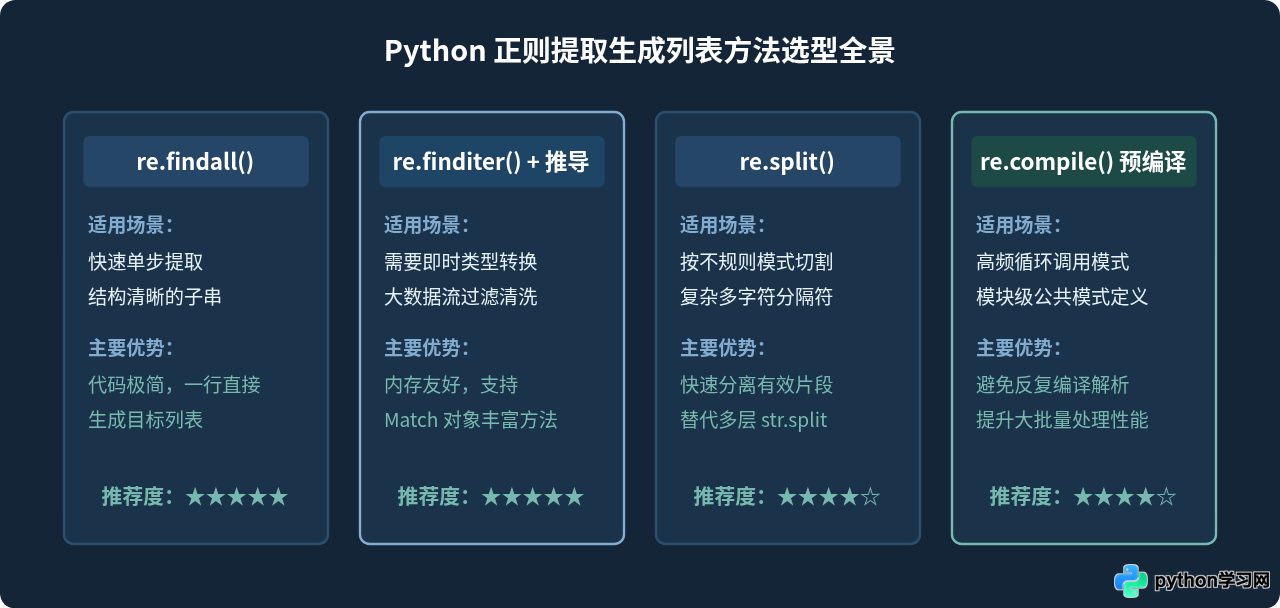
| 处理需求 | 推荐方法 | 核心代码形式 | 返回元素类型 |
|---|---|---|---|
| 提取所有匹配的单一子串 | re.findall() |
re.findall(r"\d+", text) |
str |
| 只提取前缀/后缀包围的内部内容 | re.findall() (单捕获组) |
re.findall(r"prefix_(\w+)", text) |
str |
| 提取多个关键字段并保持配对 | re.findall() (多捕获组) |
re.findall(r"(\w+)=(\d+)", text) |
tuple[str, ...] |
| 提取的同时进行类型转换或条件过滤 | re.finditer() + 推导式 |
[int(m.group(1)) for m in re.finditer(...)] |
自定义(如 int) |
| 根据复杂模式切分文本生成列表 | re.split() |
re.split(r"[,;\s]+", text) |
str |
综上所述,在 Python 中使用正则表达式提取内容并生成列表时,优先判断数据清洗的复杂度:纯粹的字符收集首选 re.findall();涉及类型转换、大文本流或元数据定位时选用 re.finditer() 配合列表推导式;而在高频循环或批量调用场景中,辅以 re.compile() 预编译,便能兼顾代码的简洁性与执行性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















