


Python官方有爬虫课程吗?权威学习资源与路径推荐

一、为什么Python官方不设立专门的爬虫课程?
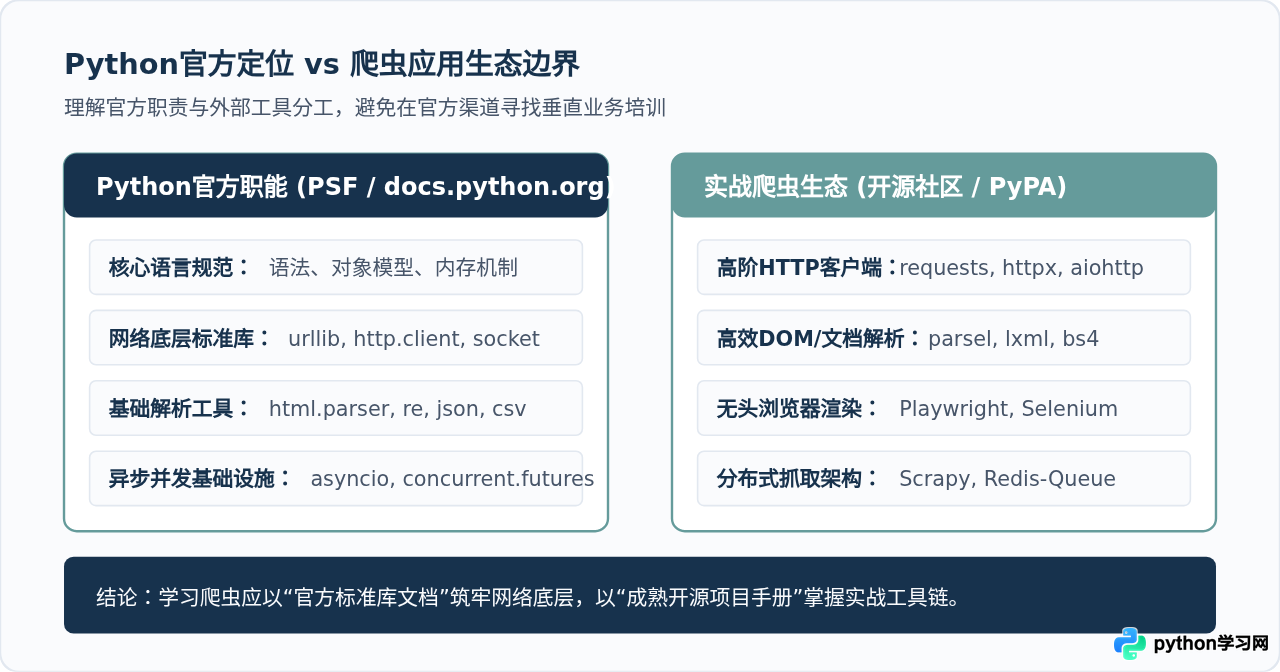
很多初学者在刚接触编程时,往往误以为 Python 与“网络爬虫”是绑定的官方能力,甚至希望在官方网站上找到一门手把手教写抓取脚本的入门课程。了解 Python 官方的职责定位,有助于建立清晰的技术学习预期:
- 官方机构的职责定位:Python 软件基金会(PSF)是一个非营利组织,其核心使命是维护 Python 语言的演进、保证 CPython 解释器的安全稳定,以及维护标准库。官方教育资源(如 Beginner's Guide)主要传授通识性的编程思想与基础语法,不会针对垂直细分的应用场景开设专属业务课程。
- 爬虫技术高度依赖第三方生态:现代网络爬虫几乎不会仅靠语言内置功能完成开发,而是广泛依托第三方开源库(例如 Requests、HTTPX、BeautifulSoup、Scrapy、Playwright)。这些工具由各自独立的开源团队或公司维护,不在 Python 官方管理范畴内。
- 抓取环境的快速多变与反爬对抗:目标网站的前端架构从早期的纯静态页面演进为客户端单页渲染(SPA),反爬机制从简单的频率限制升级到复杂的设备指纹、滑块验证与动态混淆。这种动态博弈性质决定了爬虫实操技巧具有时效性,不适合固化在官方语言标准文档中。
- 数据安全与合规边界:网络抓取直接触碰版权协议、服务条款(Terms of Service)与数据隐私法律。作为基础技术标准的制定者,官方保持中立,避免涉及具体业务形态的抓取示范。
二、Python官方文档中有哪些爬虫必备的权威基石?
虽然没有直接名为“爬虫”的手册,但 Python 官方文档(docs.python.org)中沉淀了大量极其关键的基础模块。阅读这些章节,能够让开发者在面对复杂的抓取报错时明白底层发生的真实过程。
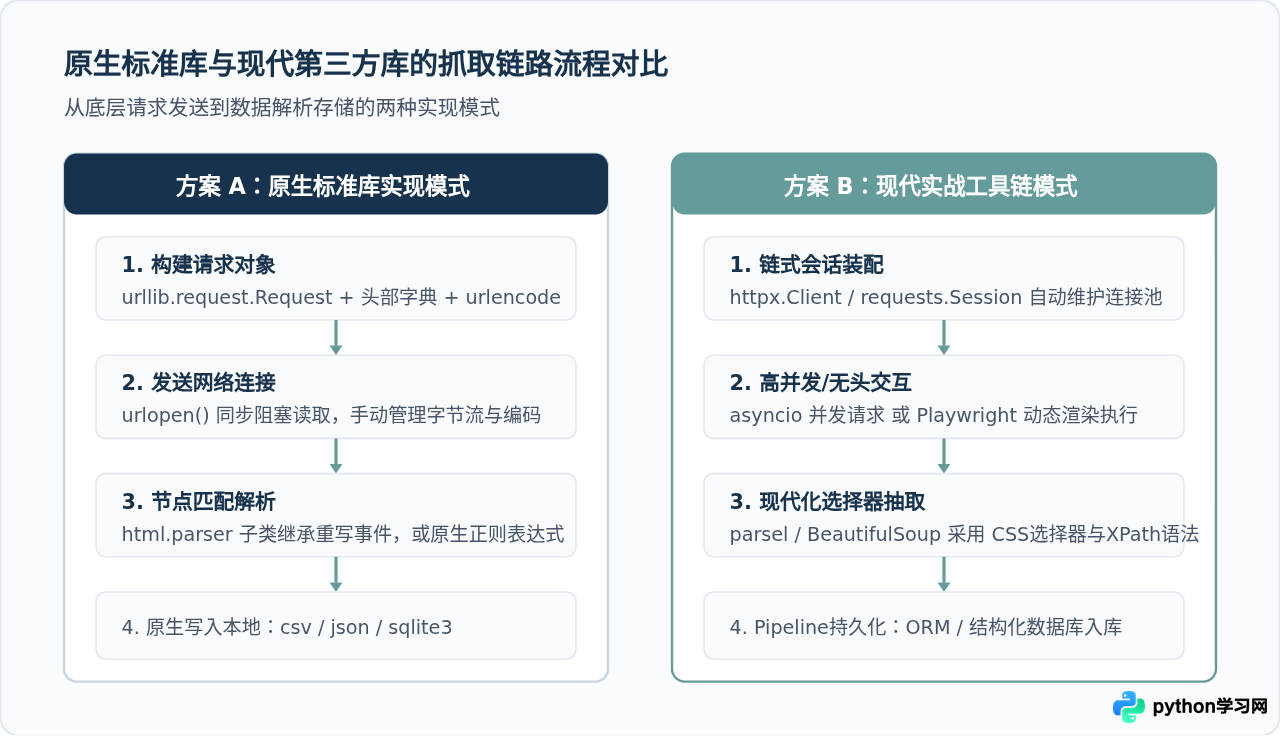
1. 网络请求与协议交互核心:urllib 与 http.client
官方标准库自带一套纯原生、无需安装任何额外依赖的网络工具箱:
urllib.request:提供了发送 HTTP/HTTPS 请求、设置自定义请求头、处理重定向和 Cookie 容器的基本能力。urllib.parse:专门负责解析、拆解、拼接 URL,以及处理查询参数的 URL 编码(URL Encode/Decode)。无论使用何种第三方库,URL 规则处理往往都由其提供支撑。http.client:更底层的 HTTP 客户端实现,直接对应 RFC 规范中的请求行、首部字段和实体主体。
以下是仅使用 Python 官方标准库发起合法 HTTP GET 请求并处理编码的基础示例:
import urllib.request
import urllib.parse

# 1. 构造带有查询参数的目标地址
base_url = "https://httpbin.org/get"
params = {"keyword": "python爬虫", "lang": "zh"}
target_url = f"{base_url}?{urllib.parse.urlencode(params)}"

# 2. 设置符合现代浏览器标准的 User-Agent
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}
req = urllib.request.Request(url=target_url, headers=headers)

# 3. 发送网络请求并读取二进制响应
try:
    with urllib.request.urlopen(req, timeout=10) as response:
        status_code = response.status
        content_type = response.headers.get_content_charset() or "utf-8"
        raw_body = response.read()
        text_content = raw_body.decode(content_type)
        print(f"响应状态码: {status_code}")
        print(f"返回数据前120字符: {text_content[:120]}")
except urllib.error.HTTPError as e:
    print(f"HTTP请求异常,状态码: {e.code}")
except urllib.error.URLError as e:
    print(f"网络连接或域名解析失败: {e.reason}")
2. 数据解析与序列化:html.parser、json、csv
数据拿到后必须经过结构化提取。标准库提供了 html.parser 类,支持事件驱动式的标签扫描;同时 json 和 csv 模块是保存结构化抓取结果的通用工具,无需依赖庞大的外部框架即可完成数据持久化。
3. 并发基础设施:asyncio 与 concurrent.futures
单线程线性抓取速度极低。官方文档中的 asyncio(异步 I/O 事件循环)和 concurrent.futures(线程池与进程池)是编写高性能采集引擎的标准技术支撑。
三、推荐的专业爬虫学习路径(四阶段阶梯)
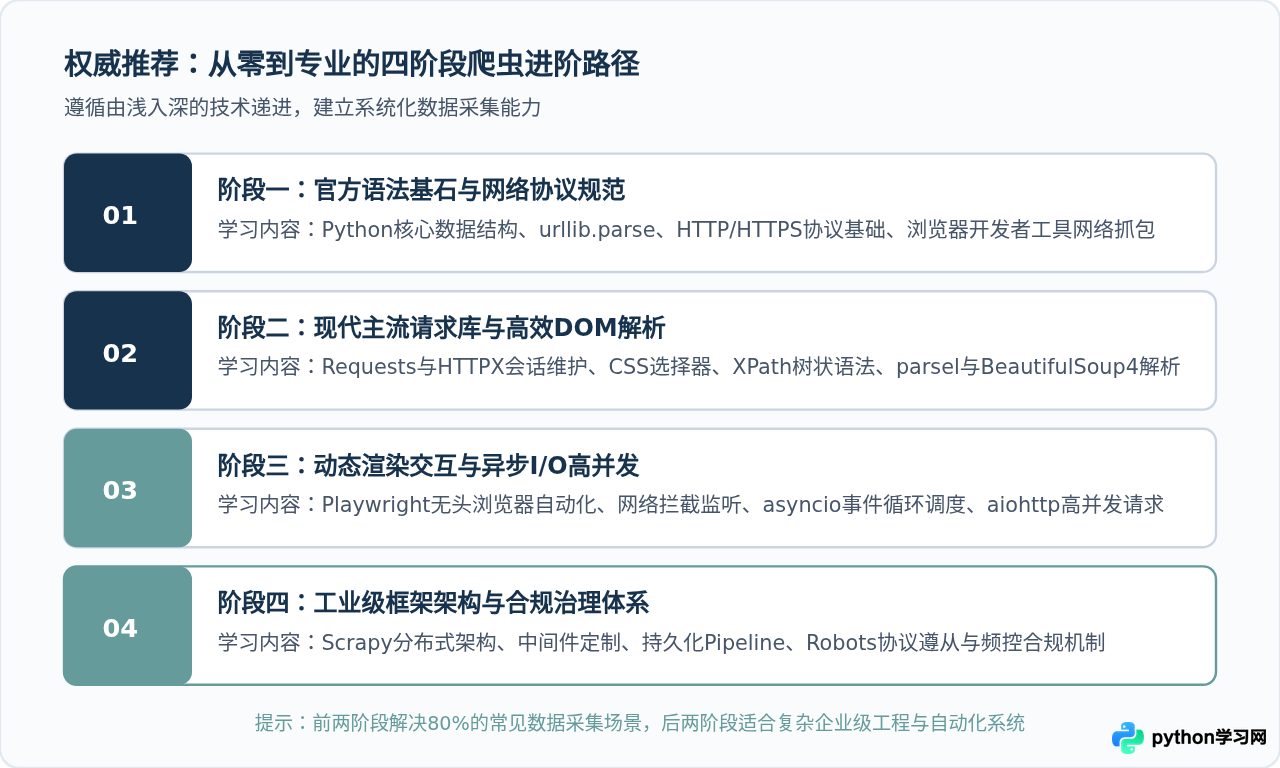
脱离了官方专有课程的局限后,应当如何规划自己的学习步调?按照业界成熟的工程能力要求,推荐分四个阶段循序渐进:
阶段一:筑牢网络协议与 Python 语法基础
在这个阶段,不要急于去写抓取脚本,而是必须理解网络交互的底层规则:
- 掌握 HTTP 核心机制:请求方法(GET、POST)、状态码含义(200、301/302、403、429、500)、请求头与响应头(User-Agent、Referer、Cookie、Content-Type)。
- 熟悉浏览器开发者工具(F12):在 Network 面板中过滤 XHR/Fetch,观察真实的数据流是直接在 HTML 源码中返回,还是由前端异步接口加载。
- 熟练掌握 Python 数据容器(字典、列表、集合)以及字符串与 JSON 互转操作。
阶段二:掌握现代请求库与文档解析器
进入实战采集阶段,从轻量级的静态页面与 API 抓取入手:
- 网络请求库:学习
Requests(同步抓取行业标准)或HTTPX(全面支持 HTTP/2 及异步支持)。 - 结构化抽取:精通 CSS 选择器 与 XPath 语法(使用
parsel或lxml)。相比纯正则表达式,DOM 树解析器在处理变动 HTML 时具备更高的鲁棒性与可读性。
阶段三:动态网页渲染与异步高并发
随着现代网站越来越多地使用 Vue、React 等单页渲染技术,部分页面数据无法通过静态请求直接获得:
- 无头浏览器自动化:优先学习微软开源的
Playwright for Python。它相比老牌的 Selenium 速度更快、事件等待机制更完善,并原生支持多标签上下文隔离与网络请求拦截。 - 异步并发采集:结合
asyncio与aiohttp或httpx.AsyncClient,实现数千个 I/O 密集型网络请求的高效调度。
阶段四:工业级爬虫框架与工程化治理
当面临百万级页面规模的抓取任务时,零散脚本无法满足需求,必须采用工程化体系:
- Scrapy 框架:深入理解 Scrapy 的核心架构(Spider、Engine、Scheduler、Downloader Middleware、Item Pipeline),掌握中间件拦截与分布式任务分发。
- 数据管道与去重机制:结合 Redis 布隆过滤器进行海量 URL 去重,将清洗后的数据沉淀至 PostgreSQL 或对象存储中。
四、真正权威的第一手学习资源清单
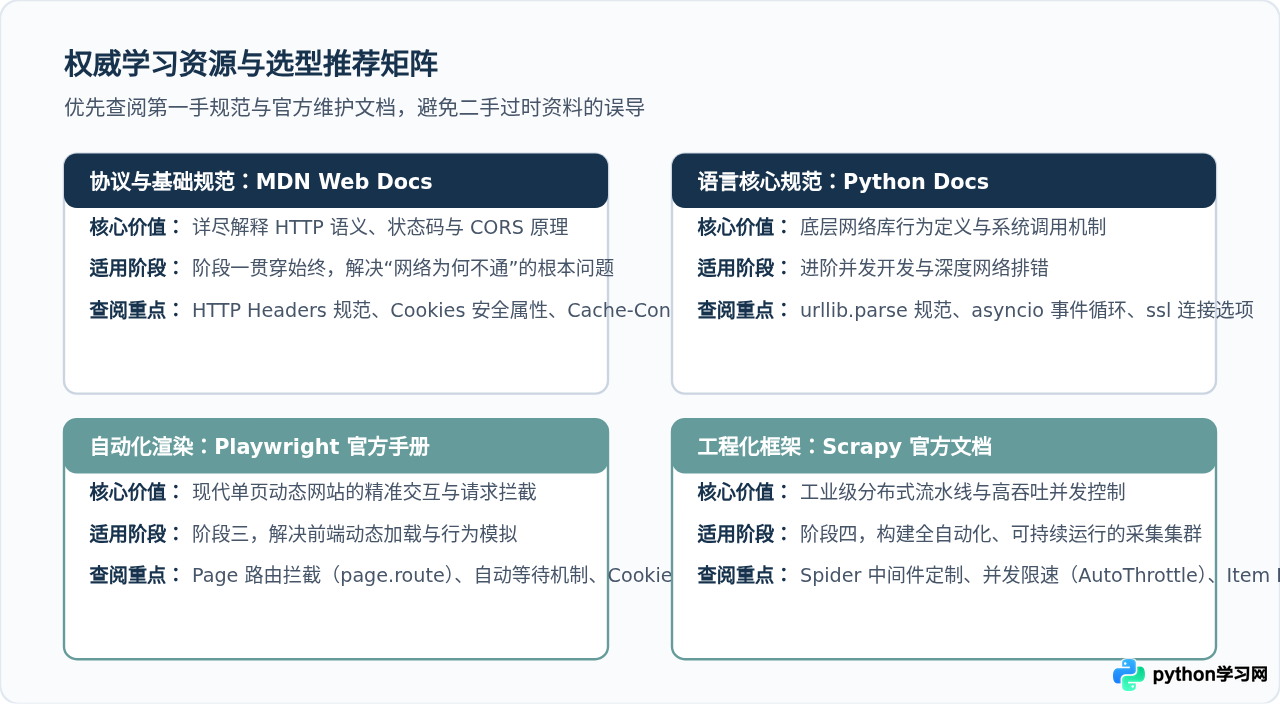
摒弃二手自媒体教程中的过时信息,以下是开发网络爬虫时最值得反复研读的“权威第一手资料”:
- MDN Web Docs(Mozilla 开发者网络):全球公认最权威的 Web 前端与 HTTP 协议参考手册。其中的 HTTP 概览、请求头含义、Cookies 工作机制与同源策略(SOP),是深入理解网络抓取原理的最佳教材。
- Python 官方文档(docs.python.org):查阅标准库中的
urllib、http.client、asyncio与socket章节,理解异常体系与连接超时的深层处理。 - Playwright Python 官方文档(playwright.dev/python):由微软维护的官方指南,包含精准的元素定位语法、异步等待策略与模拟浏览器环境配置,是学习现代动态抓取的首选资料。
- Scrapy 官方文档(docs.scrapy.org):系统化阐述了大型抓取系统的架构设计,包括请求调度、并发控制、自动重试与数据清洗流程。
五、实操开发中的关键准则与避坑要点
在实际编写抓取程序时,除了掌握技术调用,还应遵守行业通用的技术伦理与安全规范:
- 主动查阅目标站点的
robots.txt协议,尊重站方禁止抓取的路径声明。 - 严格控制并发请求频率,添加必要的延时与超时机制,严禁对目标服务器发起无节制的高并发冲击。
- 不抓取涉及个人隐私、用户未公开数据或设置了技术防护措施的受保护资产;抓取公开数据应仅用于合法合理的技术学习与科研分析。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















