


Python字符串中怎么表示CRLF(\r\n)换行符

在 Python 中表示 CRLF 换行符的核心方式非常直接:在常规字符串字面量中直接书写转义序列 "\r\n"。其中 \r 代表回车符(Carriage Return,ASCII 码 13 / 0x0D),\n 代表换行符(Line Feed,ASCII 码 10 / 0x0A)。当两个字符紧密相邻时,便构成了标准的 CRLF 组合。但在实际开发中,开发者常常会遇到原生字符串转义失效、网络通信字节类型不匹配,或者在写入文件时被 Python 内部的通用换行符机制自动替换等问题。本文将从语法表示、数据类型区分、文件读写控制到网络协议应用,系统拆解在 Python 中精确使用 CRLF 的完整方法与注意事项。
一、CRLF 字符的底层构成与原理
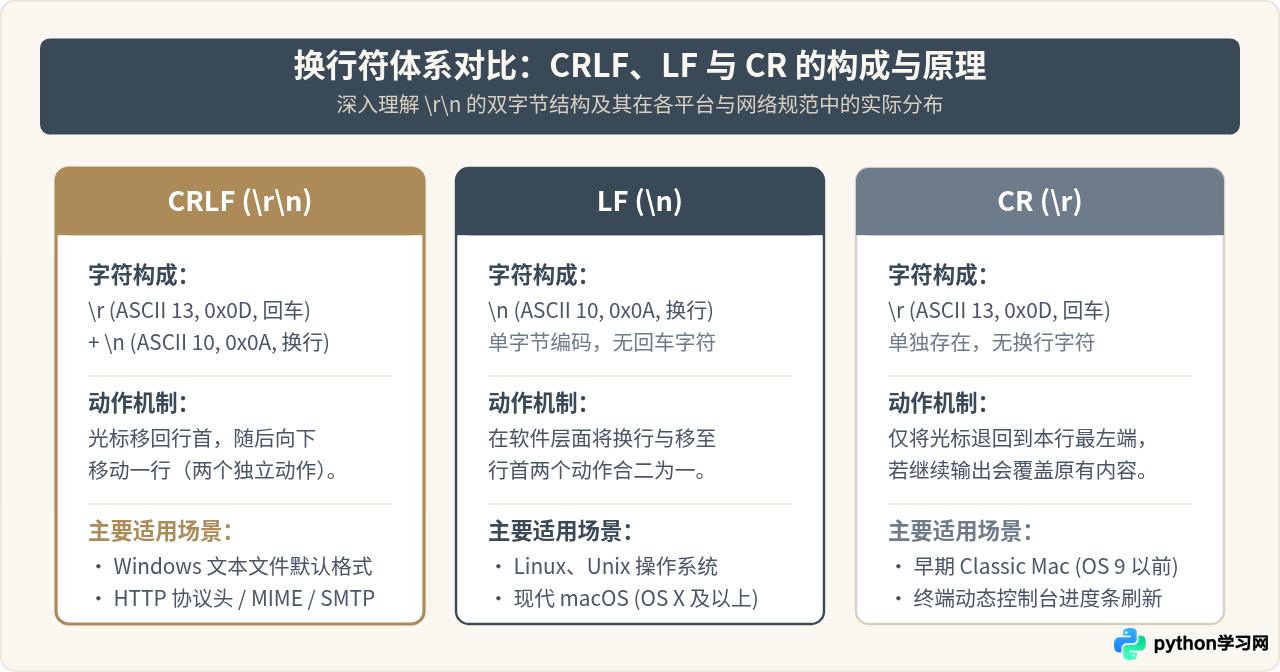
要准确使用 CRLF,首先需要理解它与普通换行符的区别。计算机早期的文本终端脱胎于机械电传打字机,打字机在换行时包含两个物理机械动作:一是“回车”(Carriage Return),控制打印头滑回当前行的最左侧起始端;二是“换行”(Line Feed),将滚筒向上推移一行。这一机械动作映射到数字编码中,便成为了两个独立的 ASCII 控制字符。
随着操作系统的演变,各平台对行尾结束符(End Of Line,EOL)的处理产生了分歧:Windows 操作系统完整沿用了打字机历史规范,采用 CRLF(即 \r\n)作为标准行结尾;而 Unix、Linux 以及现代 macOS 则精简为仅使用 LF(即 \n)。此外,在互联网标准(如 RFC 9112 规定的 HTTP/1.1、RFC 5321 规定的 SMTP)中,协议头字段与正文分割均强制要求使用 CRLF。
二、在 Python 字符串中书写 CRLF 的具体方式
在 Python 代码中,书写 CRLF 最常见的形式是标准字符串转义,但根据不同的使用场景,还可以通过十六进制转义或 Unicode 转义等价表达:
# 1. 最常见也是推荐的标准转义写法
text1 = "HeaderLine\r\nBodyLine"

# 2. 十六进制转义(\x0d 代表 13,\x0a 代表 10)
text2 = "HeaderLine\x0d\x0aBodyLine"

# 3. Unicode 转义
text3 = "HeaderLine\u000d\u000aBodyLine"

# 验证三者完全等价
print(text1 == text2 == text3)  # 示例输出: True
print(len(text1))               # 示例输出: 20 ("HeaderLine" 10 + 2个控制字符 + "BodyLine" 8)
使用内置函数 len() 观察字符串长度,"HeaderLine\r\nBodyLine" 中 \r\n 占用的是 2 个字符长度,而不是 4 个字符。如果你直接使用 print(text1),控制台会将换行渲染出来,看不到 \r\n 字面量。若想查看字符串内部真实包含的转义字符,必须使用 repr() 函数:
sample = "Hello\r\nWorld"
print(sample)
# 示例输出:
# Hello
# World

print(repr(sample))
# 示例输出: 'Hello\r\nWorld'
三、两种易错表示:原生字符串与字节串
初学者在处理带有反斜杠的字符串时,极容易误用原生字符串(Raw String)或者混淆字符串与字节串的边界,导致隐蔽的语法与协议错误。
1. 误区:使用原生字符串 r"\r\n"
在处理正则表达式或 Windows 文件路径时,常用前缀 r(例如 r"C:\test\new")来抑制反斜杠转义。但是,如果你在 CRLF 前加上了 r,Python 将不会将其解析为回车与换行控制字符,而是直接保留反斜杠与字母本身:
raw_str = r"Line1\r\nLine2"
normal_str = "Line1\r\nLine2"

print(len(raw_str))     # 示例输出: 14 (反斜杠、r、反斜杠、n 均作为字面字符)
print(len(normal_str))  # 示例输出: 12 (\r 和 \n 各占 1 个字符)
print(repr(raw_str)) # 示例输出: 'Line1\\r\\nLine2'在原生字符串中,\r\n 变成了字面量 \\r\\n。如果将该字符串发送到遵循 CRLF 规范的 HTTP 服务器或 SMTP 邮件网关,对方收到的将是字符 '\' 和 'r',而不会触发协议换行,从而导致 400 Bad Request 或协议解析异常。
2. 关键场景:字节串 b"\r\n"
在底层 Socket 通信、二进制协议封装以及使用 requests/urllib 构造原始报文时,数据是以字节(Bytes)形式传输的。此时必须使用带 b 前缀的字节串:
# 字节串表示法
crlf_bytes = b"\r\n"
print(type(crlf_bytes))      # 示例输出: <class 'bytes'>
print(list(crlf_bytes))      # 示例输出: [13, 10] (精确对应 0x0D 和 0x0A)

# 字符串与字节串相互转换
text_data = "Content\r\n"
encoded_data = text_data.encode("ascii")
print(encoded_data == b"Content\r\n")  # 示例输出: True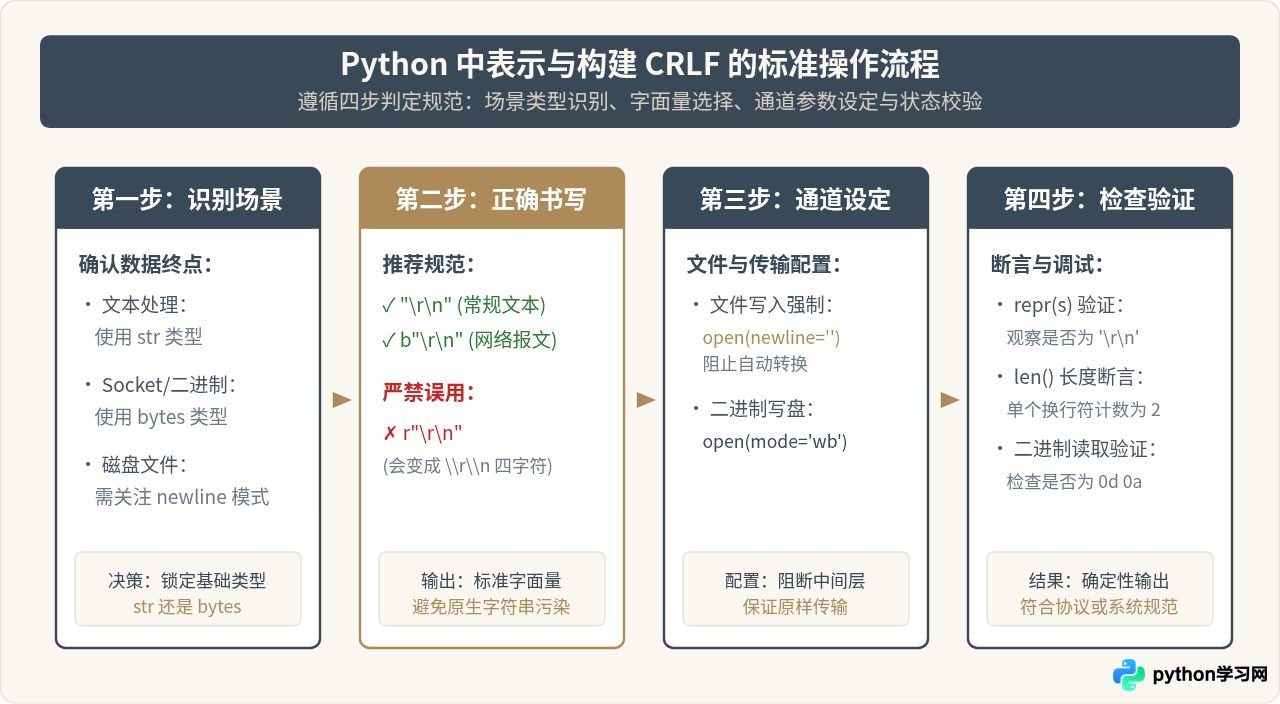
四、文件读写中的核心陷阱:open() 的 newline 参数
许多开发者在 Python 中定义了 "\r\n" 并写入文件后,将文件传输到 Linux 上查看,却惊讶地发现文件结尾依然是 \n;或者在 Windows 上写 \n,落盘后却变成了 \r\n。这种现象源于 Python 的通用换行符支持机制(Universal Newlines)。
1. 默认行为(newline=None)
在默认情况下,Python 内置的 open() 函数会开启自动换行转换:
- 读取文本时:不论文件里实际保存的是
\r\n(Windows)、\n(Linux)还是\r(老 Mac),Python 都会将其统一翻译为单字符\n存入内存字符串。此时即使原文件是 CRLF,你在内存中调用repr()也只能看到'\n'。 - 写入文本时:Python 会把内存字符串中的所有
\n自动转换为当前操作系统的默认换行符(在 Windows 上自动转为\r\n,在 Linux/macOS 上保持\n)。更危险的是,如果你已经在字符串里手写了"\r\n",在 Windows 默认模式下,\n会再次被转译为\r\n,导致文件落盘变成\r\r\n(重复的回车符)。
2. 精确控制:显式指定 newline=''
如果你需要跨平台精确生成或读取包含 CRLF 的文本文件,必须显式传递 newline='' 参数。设置为空字符串意味着禁用所有自动换行转换,内存里是什么,磁盘就原样写入或读取什么:
# 严格写入包含 CRLF 的文本文件(无论在 Windows 还是 Linux 上执行结果一致)
lines = ["第一行", "第二行", "第三行"]
content = "\r\n".join(lines) + "\r\n"

with open("windows_format.txt", "w", encoding="utf-8", newline="") as f:
    f.write(content)

# 严格读取并验证 CRLF 确实保留在字符串中
with open("windows_format.txt", "r", encoding="utf-8", newline="") as f:
    read_text = f.read()

print(repr(read_text))
# 示例输出: '第一行\r\n第二行\r\n第三行\r\n'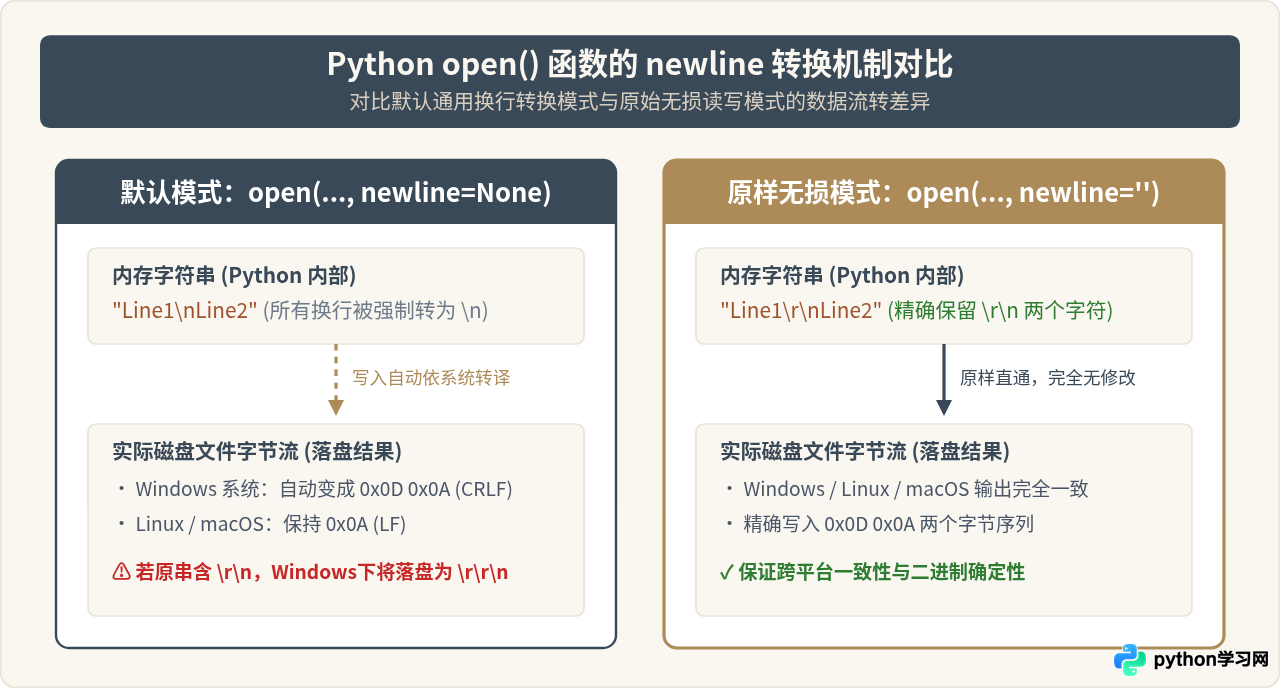
五、高频应用场景与实用操作技巧
在日常工程实践中,除了普通的文本编辑,CRLF 还广泛存在于网络报文组装、CSV 文件交换以及字符串标准化处理等关键场景中。
1. 网络协议与原始 Socket 交互
HTTP、SMTP 等经典互联网文本协议规定,请求头、响应头每一行末尾必须带有 \r\n,并且使用连续两个 \r\n\r\n(即一个空行)表示报文头部的结束。以下是使用标准库构造并解析 HTTP 原始响应报文的典型示例:
# 组装标准的 HTTP GET 请求报文
headers = [
    "GET /index.html HTTP/1.1",
    "Host: example.com",
    "User-Agent: Python-Client",
    "Connection: close"
]

# 使用 \r\n 连接,并在尾部追加双 \r\n 表示报文头结束
http_request_str = "\r\n".join(headers) + "\r\n\r\n"
http_request_bytes = http_request_str.encode("utf-8")

# 解析收到的 HTTP 响应字节
response_bytes = b"HTTP/1.1 200 OK\r\nContent-Type: text/plain\r\n\r\nHello World"
header_part, body_part = response_bytes.split(b"\r\n\r\n", 1)

print(header_part.decode("utf-8"))
# 示例输出:
# HTTP/1.1 200 OK
# Content-Type: text/plain
2. CSV 文件中的 CRLF 兼容性
RFC 4180 规范明确指出,标准的 CSV 文件记录行应该以 CRLF 分隔。Python 内置的 csv.writer 默认行尾就是 \r\n(即 lineterminator='\r\n')。如果在调用 open() 打开 CSV 时没有加上 newline='',在 Windows 平台上就会产生恼人的空行重复问题:
import csv

# 正确做法:必须指定 newline='',由 csv 模块自主控制 CRLF 输出
with open("data.csv", "w", encoding="utf-8", newline="") as f:
    writer = csv.writer(f)
    writer.writerow(["ID", "Name"])
    writer.writerow(["1", "Alice"])
3. 字符串标准化与分割处理
在清洗用户输入或读取未知来源的文本时,经常会同时混杂 \r\n、\n 和 \r。Python 提供了方便的方法进行安全处理:
- 统一归一化为 \n:
text.replace("\r\n", "\n").replace("\r", "\n")。注意必须先替换\r\n,再替换单独的\r,避免破坏原有顺序。 - 保持语义的按行分割:使用
text.splitlines()。该方法内置对\r\n、\n、\r的自动识别,不会在列表中留下多余的空串或回车符号。若需要保留原始换行符,传入text.splitlines(keepends=True)即可。
六、总结
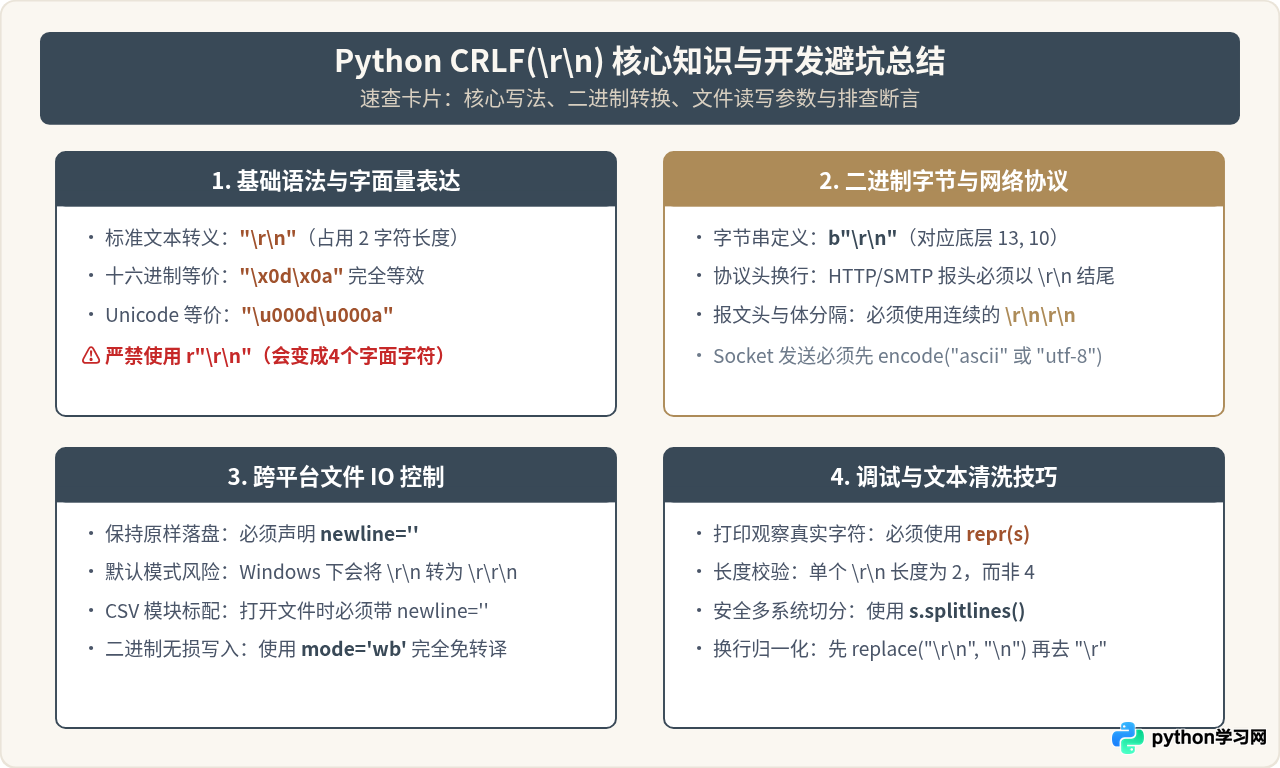
在 Python 中表示 CRLF 换行符,语法本身只需书写标准转义字符 "\r\n"。但在工程实践中,保障换行符能够按预期工作,关键在于掌握以下四项原则:
- 字面量选择:常规文本使用
"\r\n",二进制流使用b"\r\n",绝对不能对换行转义字符添加r原生字符串前缀。 - 查看内部状态:排查不可见字符时,始终使用
repr()查看其内部表示,不要依赖print()的终端渲染。 - 控制文件输入输出:在跨平台读写文本文件或处理 CSV 时,务必在
open()中显式传入newline='',阻断 Python 内置通用换行符机制带来的二次隐式转换。 - 严格遵守协议规范:在构建网络报文(如 HTTP 请求头)时,严格确保每一行结尾为
\r\n,报头与正文间使用\r\n\r\n明确分隔。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















