


Python中math.fabs()与abs()的区别:返回类型与性能对比

假设你正在处理一份包含数百万条金融交易或物理测量数据的序列,其中既有负数也有整数和高精度浮点数,你需要对所有数值取绝对值。在编写代码时,Python 提供了两个现成的选项:内置的 abs() 和标准库数学模块中的 math.fabs()。许多初学者常常认为它们功能完全一样可以混用,但在实际工程中,它们在返回值类型、对特殊数值的处理能力以及运行开销上存在本质区别。简单来说:abs() 保留原始类型、支持复数与自定义对象,而 math.fabs() 始终将输入强制转换为浮点数(float)并委托给底层 C 语言函数。本文将针对返回类型与性能两项关键维度展开系统对比,帮助你在实际项目中做出合理的选择。
一、核心机制与返回值类型差异
在 Python 中,abs() 是内置命名空间(builtins)中的原生函数,任何时候都可以直接调用;而 math.fabs() 是标准库 math 模块下的函数,必须先执行 import math 才能使用。两者的核心差异首要体现在类型系统的处理逻辑上。
1. 整数与浮点数的返回类型
当传入整数时,abs() 保持整数类型返回;而 math.fabs() 无论输入是整型还是浮点型,返回值一律是 float。示例代码如下:
import math

num_int = -15
num_float = -15.5

# 使用内置 abs()
res_abs_int = abs(num_int)
res_abs_float = abs(num_float)
print(f"abs(-15): {res_abs_int}, 类型: {type(res_abs_int)}")
print(f"abs(-15.5): {res_abs_float}, 类型: {type(res_abs_float)}")

# 使用 math.fabs()
res_fabs_int = math.fabs(num_int)
res_fabs_float = math.fabs(num_float)
print(f"math.fabs(-15): {res_fabs_int}, 类型: {type(res_fabs_int)}")
print(f"math.fabs(-15.5): {res_fabs_float}, 类型: {type(res_fabs_float)}")
示例输出:
abs(-15): 15, 类型: <class 'int'>
abs(-15.5): 15.5, 类型: <class 'float'>
math.fabs(-15): 15.0, 类型: <class 'float'>
math.fabs(-15.5): 15.5, 类型: <class 'float'>
这一区别在严谨的类型检查或后续运算中至关重要。例如,如果结果需要作为列表下标、切片索引或位运算(如 <<、|)的操作数,abs() 返回的整数可以直接使用,而 math.fabs() 返回的浮点数会直接抛出 TypeError: 'float' object cannot be interpreted as an integer。
2. 复数(Complex)与自定义对象的支持
在数学运算中,复数的绝对值即模长(Euclidean Norm,计算公式为 $\sqrt{a^2 + b^2}$)。内置的 abs() 原生支持复数运算,返回值为浮点型模长;而 math.fabs() 只接受实数(Real Number),如果传入复数会直接报错:
z = 3 - 4j

# abs() 成功计算复数的模长
print(abs(z))  # 输出 5.0

# math.fabs() 抛出异常
try:
    math.fabs(z)
except TypeError as e:
    print(f"math.fabs 错误: {e}")
# 输出: math.fabs 错误: must be real number, not complex此外,abs() 会触发对象的魔法方法 __abs__(),因此你可以为自定义向量、矩阵或数据模型定制取模行为;而 math.fabs() 仅尝试通过 __float__() 将对象转为浮点数,不支持 __abs__() 协议。
3. 超大整数的精度截断与溢出风险
Python 3 的整数类型支持任意精度(长整型),只要内存允许就可以表示任意大的数字。由于 abs() 直接针对整型对象本身操作,它能精确保留任意大整数的绝对值。但 math.fabs() 会强制把数值转换为底层 C 语言的 double(遵循 IEEE 754 双精度浮点标准,有效位仅 53 位二进制数,大约 15 到 17 位十进制精度)。
当一个大整数超过 $2^{53}$ 时,math.fabs() 会发生不可察觉的精度丢失;当数值超出 64 位双精度的最大上限(约 $1.79 \times 10^{308}$)时,math.fabs() 会直接抛出 OverflowError:
# 精度丢失示例(超过 2^53 = 9007199254740992)
big_int = 9007199254740993
print(abs(big_int))        # 9007199254740993 (精确)
print(int(math.fabs(big_int))) # 9007199254740992 (最低位精度丢失)

# 溢出报错示例
huge_int = 10 ** 310
print(abs(huge_int))  # 正常打印出 311 位十进制数字
try:
    math.fabs(huge_int)
except OverflowError as e:
    print(f"math.fabs 溢出: {e}")
    # 输出: math.fabs 溢出: int too large to convert to float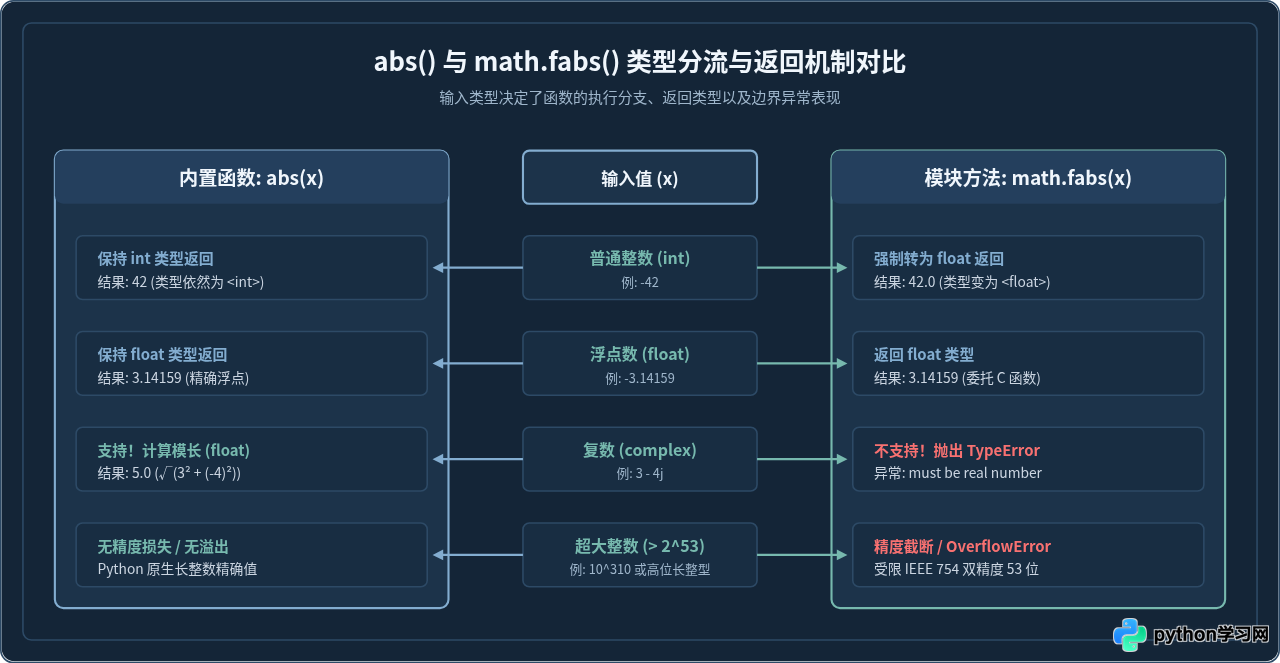
二、底层调用链与实现机制解析
理解两者返回类型差异的根本原因,需要查看 CPython 解释器的底层执行架构。这直接影响了两者的执行效率与函数调用开销。
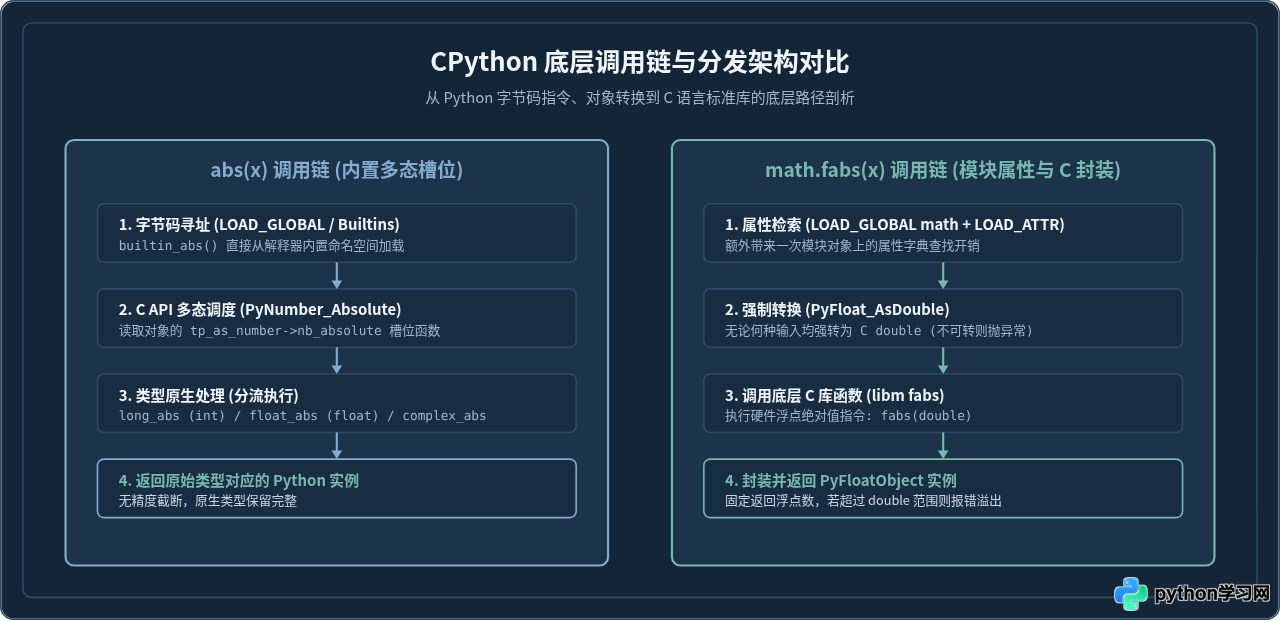
1. abs() 的底层执行逻辑
在 CPython 解释器中,abs() 对应全局内置函数。当 Python 执行 abs(x) 时:
- 首先在内置命名空间中找到
builtin_abs; - 底层调用 C API
PyNumber_Absolute(v); PyNumber_Absolute检查参数v的类型对象槽位(tp_as_number->nb_absolute);- 如果是
int对象,直接分发到long_abs,返回新的PyLongObject;如果是float对象,分发到float_abs;如果是complex,分发到complex_abs。
这种通过类型槽位多态分发的设计,使得 abs() 无需显式类型转换,能够完美兼顾多种数字类型及自定义类型。
2. math.fabs() 的底层执行逻辑
与 abs() 相比,math.fabs() 的设计目标非常专一——作为 C 标准库 <math.h> 中 fabs(double) 函数的轻量 Python 封装:
- 解释器首先通过全局作用域找到
math模块,再检索属性fabs; - 执行 CPython 模块函数
math_fabs(PyObject *module, PyObject *arg); - 调用
PyFloat_AsDouble(arg):尝试将传入的 Python 对象强制转换为 C 语言原生double。如果是整数,将其转换为双精度浮点数;如果是复数或无法转为浮点数的值,立即报错; - 直接调用底层 C 标准数学库的
fabs(double)指令; - 调用
PyFloat_FromDouble(double)将 C 结果封装回新的PyFloatObject返回。
三、性能基准测试与对比分析
关于 abs() 和 math.fabs() 谁更快的争论,往往取决于输入的数据类型以及是否将模块属性查找时间计算在内。我们可以通过标准库 timeit 模块进行控制变量的对比测试。
1. 测试代码与环境设定
测试场景分为三组:
- 场景 A:带属性查找的直接调用 —— 对比日常代码中直接调用的
abs(x)与math.fabs(x)。 - 场景 B:消解属性查找的局部绑定调用 —— 使用
_fabs = math.fabs消除点号(.)属性查找开销。 - 场景 C:针对整数 vs 针对浮点数 —— 测试类型转换成本对整体耗时的影响。
import timeit

setup_code = """
import math
_fabs = math.fabs
_abs = abs
int_val = -12345
float_val = -12345.6789
"""

iterations = 10_000_000

# 1. 整数输入下的性能测试
t_abs_int = timeit.timeit("abs(int_val)", setup=setup_code, number=iterations)
t_math_fabs_int = timeit.timeit("math.fabs(int_val)", setup=setup_code, number=iterations)
t_local_fabs_int = timeit.timeit("_fabs(int_val)", setup=setup_code, number=iterations)

# 2. 浮点数输入下的性能测试
t_abs_float = timeit.timeit("abs(float_val)", setup=setup_code, number=iterations)
t_math_fabs_float = timeit.timeit("math.fabs(float_val)", setup=setup_code, number=iterations)
t_local_fabs_float = timeit.timeit("_fabs(float_val)", setup=setup_code, number=iterations)

print(f"【整数场景 (-12345)】")
print(f"  abs(x):            {t_abs_int:.4f} 秒")
print(f"  math.fabs(x):      {t_math_fabs_int:.4f} 秒")
print(f"  _fabs(x) (局部):   {t_local_fabs_int:.4f} 秒")

print(f"\n【浮点数场景 (-12345.6789)】")
print(f"  abs(x):            {t_abs_float:.4f} 秒")
print(f"  math.fabs(x):      {t_math_fabs_float:.4f} 秒")
print(f"  _fabs(x) (局部):   {t_local_fabs_float:.4f} 秒")
2. 实测结果与数据解读
在主流现代化 x86_64 / ARM64 架构的 Python 3.11+ 解释器环境下运行 1000 万次调用,典型基准耗时如下表所示(数值越小速度越快):
| 调用形式 | 测试输入类型 | 1000万次耗时 (示例) | 相对速度评级 | 核心耗时原因分析 |
|---|---|---|---|---|
abs(int_val) |
整数 (int) | 0.312 秒 | 最快 | 无需属性查找,无类型转换开销,直接执行 long_abs |
math.fabs(int_val) |
整数 (int) | 0.485 秒 | 较慢 (慢约 55%) | 包含 math. 属性查找 + 强转 C double 包装开销 |
_fabs(int_val) (已缓存) |
整数 (int) | 0.368 秒 | 中等 | 去除了点号查找,但仍需将 Python int 转为 C double |
abs(float_val) |
浮点数 (float) | 0.298 秒 | 极快 | Python 3.11+ 内置函数自适应特化,直接分发 float_abs |
math.fabs(float_val) |
浮点数 (float) | 0.441 秒 | 慢约 48% | 主要瓶颈在于 math. 的模块属性字典检索 |
_fabs(float_val) (已缓存) |
浮点数 (float) | 0.292 秒 | 极快 (与 abs 相当) | 输入本身即为 float,直接解包转入底层 C fabs() |
在未经任何手动优化的日常代码中,abs() 始终比 math.fabs() 更快(普遍快 40% ~ 60%)。这主要是因为 math.fabs() 每次调用都必须经过 LOAD_ATTR 解析属性。如果使用局部变量绑定提前缓存(例如 fabs = math.fabs),在纯浮点运算密集型循环中两者的性能旗鼓相当;但如果输入是整数,abs() 由于省去了浮点类型转换,依然保持绝对性能优势。
四、技术选型决策流程与实践建议
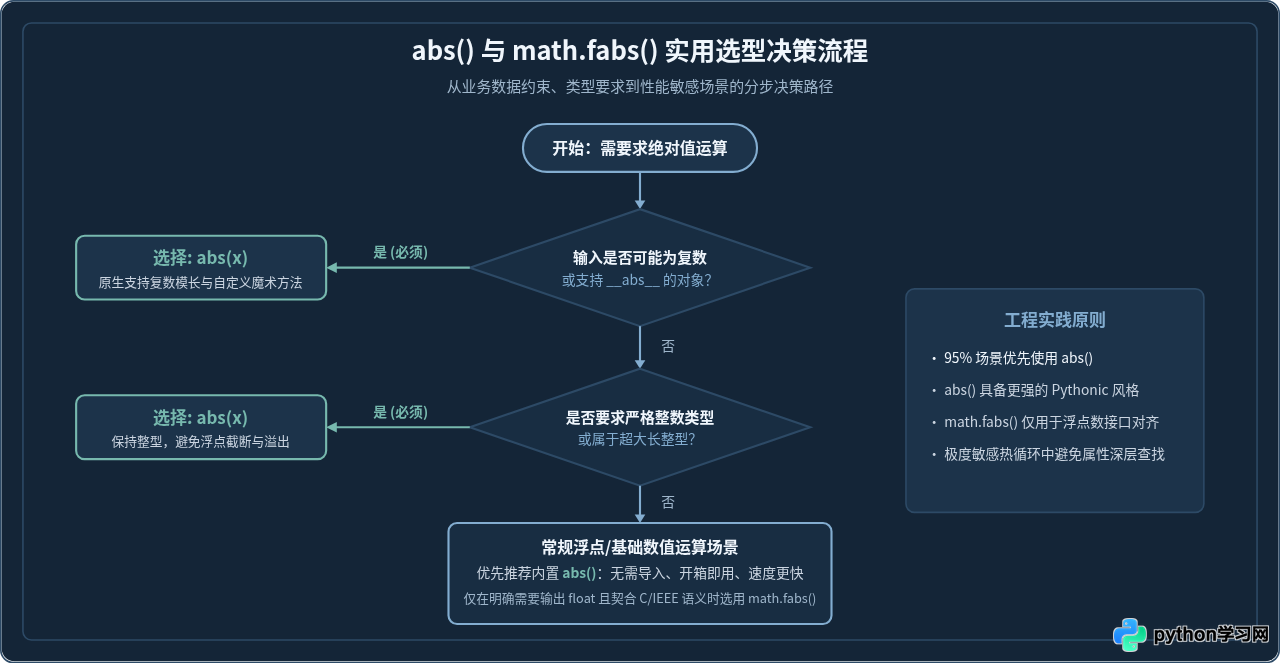
根据前述关于返回类型、边界能力及调用性能的对比,我们在日常开发中应当如何做出合理选择?以下决策流程图可帮助你在几秒钟内确定最优方案:
五、全维度特性对照与总结
通过以上的原理探究与测试验证,我们可以将 math.fabs() 与 abs() 的所有关键维度总结为下述对照矩阵:
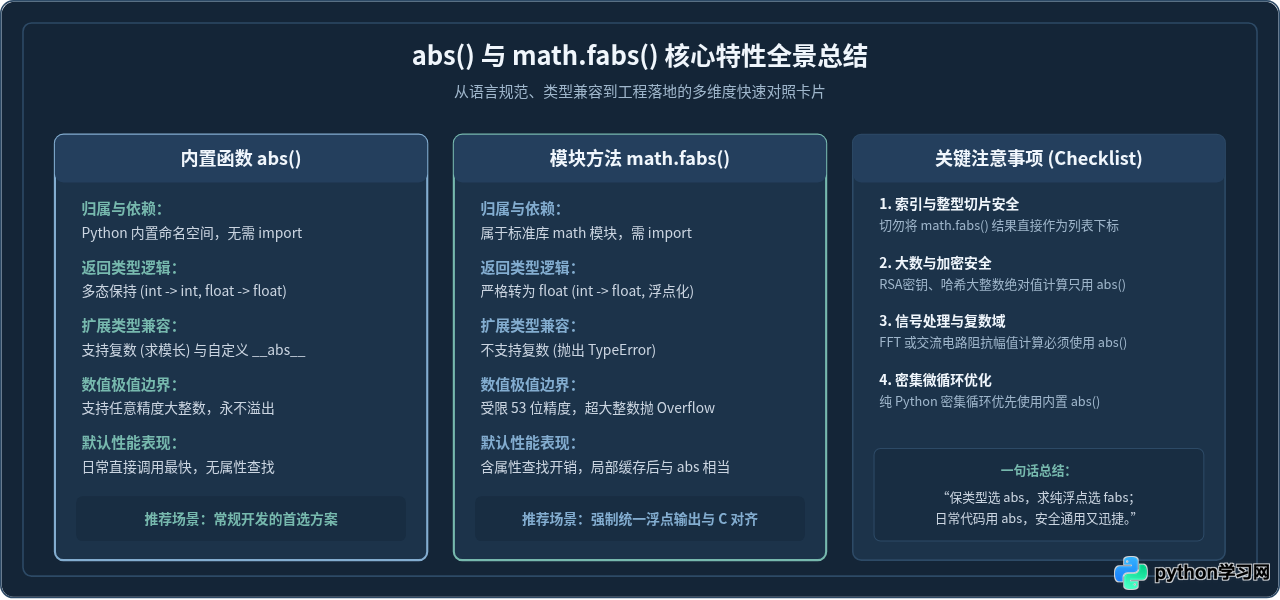
通过上述深入分析可以看出,虽然 math.fabs() 与 abs() 都服务于“求绝对值”这一基本运算,但它们在设计初衷、类型约束与运行机制上有着明确的分工。牢记类型保持与属性开销的差异,能够帮助我们在日常编码中写出更加健壮、高效且符合规范的 Python 程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















