


NLTK、spaCy还是Transformers?Python NLP主流库选型对比

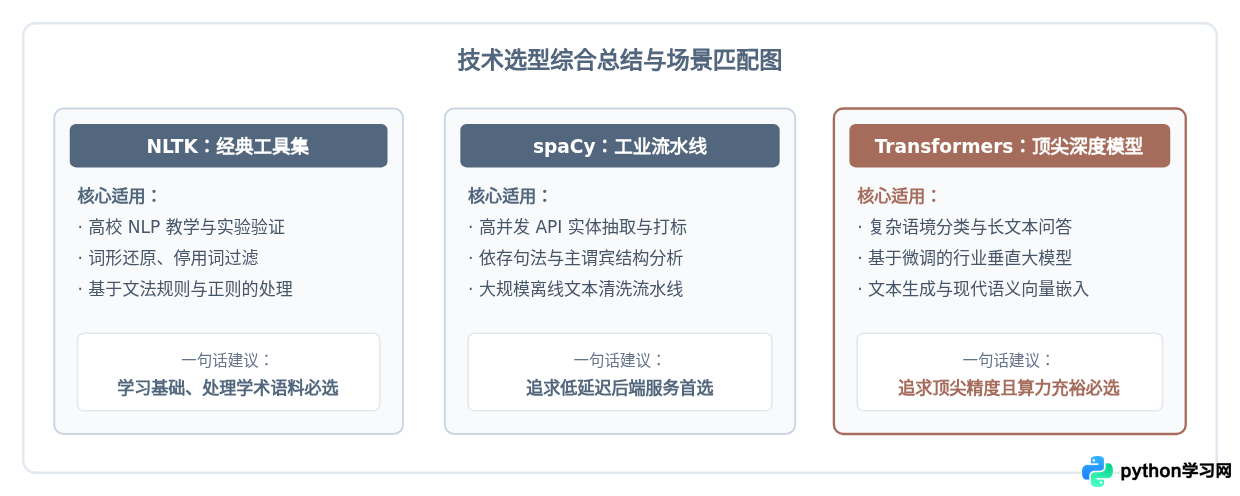
在 Python 自然语言处理(NLP)的工程实践中,NLTK、spaCy 与 Transformers 代表了三种完全不同的演进阶段与设计哲学。快速得出选型结论的关键在于权衡任务的语义深度与系统的计算开销:教学研究或基础符号规则选 NLTK;工业级端到端低延迟信息抽取选 spaCy;复杂上下文理解、高精文本生成或分类且算力充足选 Transformers。
许多初学者或工程师在技术选型时常陷入“新库一定替代旧库”的误区。实际上,这三个工具并非替代关系,而是分工互补的工具矩阵。理解它们的内部架构与适用边界,能够避免陷入用大模型跑简单分词导致服务器显存爆满,或者用传统规则处理复杂语义导致准确率低下的技术陷阱。
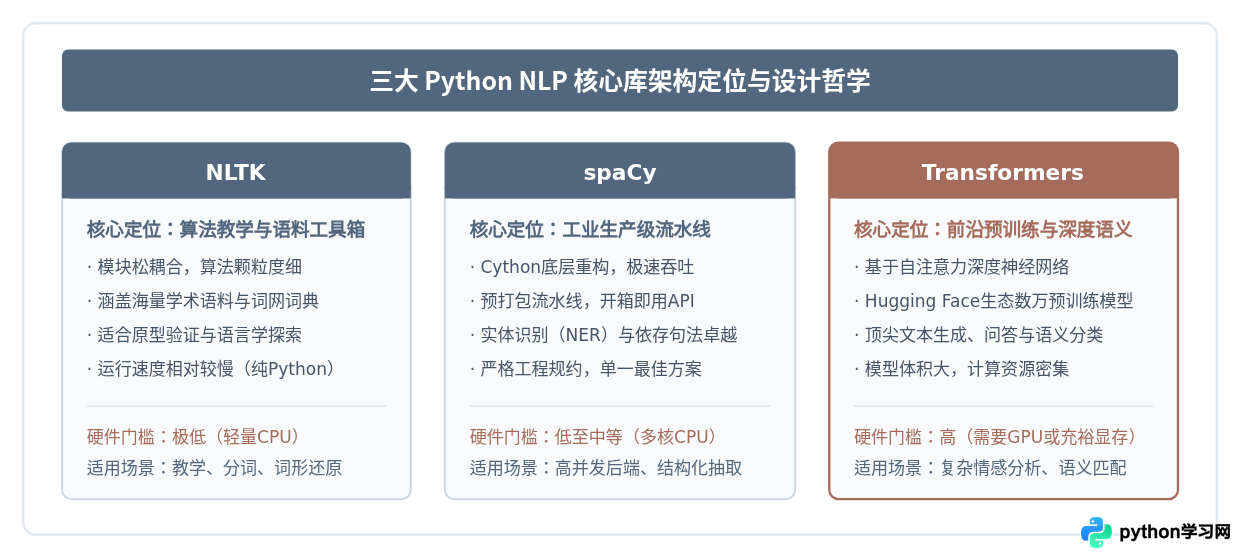
一、NLTK:经典自然语言处理的算法基石
NLTK(Natural Language Toolkit)诞生于 2001 年,最初设计作为教学与科研工具。它的核心逻辑是算法模块集合:一个文本处理任务通常提供 5 种以上的实现算法(如分词有 Penn Treebank 分词、空格分词、正则分词、Punkt 分词等)。
适用场景与工程优劣
- 优势:算法透明度高,包含大量经典语料库(如 WordNet、Brown 语料库)和语言学工具(词形还原 WordNetLemmatizer、词干提取 PorterStemmer)。如果需要研究某种具体的经典分词或文法解析算法细节,NLTK 是极佳的选择。
- 劣势:几乎全部基于纯 Python 编写,缺乏面向现代生产流水线的高性能优化;没有统一高效的内存数据结构(如面向文档的 C 级指针流),在大规模文本批量处理时性能开销显著。
经典操作示例:文本分词与词性标注
在本地终端执行环境准备(需通过 Python 下载必要分词器数据包):
# 终端执行安装
pip install nltk
import nltk
from nltk.tokenize import word_tokenize
from nltk.tag import pos_tag
# 首次运行需下载基础模型资源(仅需下载一次)
nltk.download('punkt', quiet=True)
nltk.download('averaged_perceptron_tagger', quiet=True)
raw_text = "Natural language processing with Python is powerful and flexible."
# 1. 文本分词
tokens = word_tokenize(raw_text)
# 2. 词性标注
tagged_tokens = pos_tag(tokens)
print("分词结果:", tokens)
print("词性标注:", tagged_tokens[:4])二、spaCy:面向工业落地的低延迟处理引擎
spaCy 诞生于 2014 年,设计哲学完全对准生产落地。它抛弃了 NLTK 的多算法选择模式,为每个典型任务提供“单一最佳实践”。其底层使用 Cython 编写,内存直接在 C 结构体中分配与传递,并引入了核心的 Doc 容器对象。
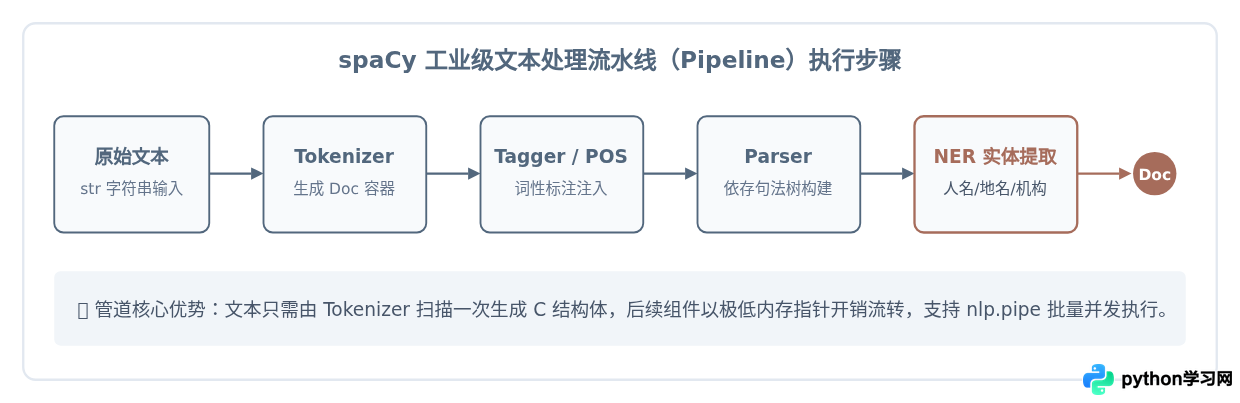
适用场景与工程优劣
- 优势:开箱即用的预训练流水线;命名实体识别(NER)和依存句法解析(Dependency Parsing)速度极快;原生支持与自定义组件(Component)插拔组合,非常适合部署为无状态的微服务。
- 劣势:对深层长程语义问答、生成式任务支持有限。虽然现代 spaCy 允许挂载 Transformer 模型权重,但会抵消其纯 Cython 运行时的轻量优势。
经典操作示例:流水线处理与实体提取
# 终端执行安装(以英文轻量模型为例)
pip install spacy
python -m spacy download en_core_web_sm
import spacy
# 加载优化后的小型流水线
nlp = spacy.load("en_core_web_sm")
text = "Apple CEO Tim Cook announced a new hardware lab in Shanghai with 500 engineers."
# 一次调用完成全流程处理
doc = nlp(text)
# 1. 提取命名实体
print("=== 命名实体识别 ===")
for ent in doc.ents:
print(f"实体: {ent.text:<15} 标签: {ent.label_}")
# 2. 检查依存关系(抽取主谓宾结构)
print("\n=== 主干依存关系 ===")
for token in doc:
if token.dep_ in ("nsubj", "ROOT", "dobj"):
print(f"词元: {token.text:<10} 角色: {token.dep_:<8} 关联词: {token.head.text}")三、Transformers:现代语义表征与前沿大模型
Transformers(由 Hugging Face 主导)彻底改变了 NLP 领域的开发范式。它以自注意力机制(Self-Attention)为核心,将文本映射到高维连续语义空间中。相比 NLTK 和 spaCy 依赖统计特征或局部窗口,Transformers 能够捕捉长距离依存与细微的语境歧义。
适用场景与工程优劣
- 优势:在情感分类、多标签语义归类、语义相似度搜索、摘要生成等任务上具有绝对领先的准确度;生态极其庞大,拥有 Hugging Face Hub 上万预训练检查点可供直接加载与微调。
- 劣势:参数量大(通常数百兆至数吉字节),推理延迟以毫秒乃至秒计;在没有 GPU 或专用推理加速卡的环境下,高并发响应开销极高。
经典操作示例:高精情感语义分类
# 终端执行安装
pip install transformers torch
from transformers import pipeline
# 使用高层抽象流水线进行文本分类推理
# 自动下载并缓存默认的模型与分词器权重
classifier = pipeline("sentiment-analysis")
sentences = [
"The latency optimization exceeded our expectations under stress testing.",
"The deployment failed repeatedly due to severe CUDA memory leak."
]
# 执行批量语义推断
results = classifier(sentences)
for sent, res in zip(sentences, results):
print(f"文本: {sent}")
print(f"预测类别: {res['label']} (置信度: {res['score']:.4f})\n")四、选型对比与工程决策树
在面对具体的业务需求时,选型可以遵循清晰的排查路径。决策的核心边界在于是否必须理解上下文歧义与是否具备低延迟并发/硬件算力指标。
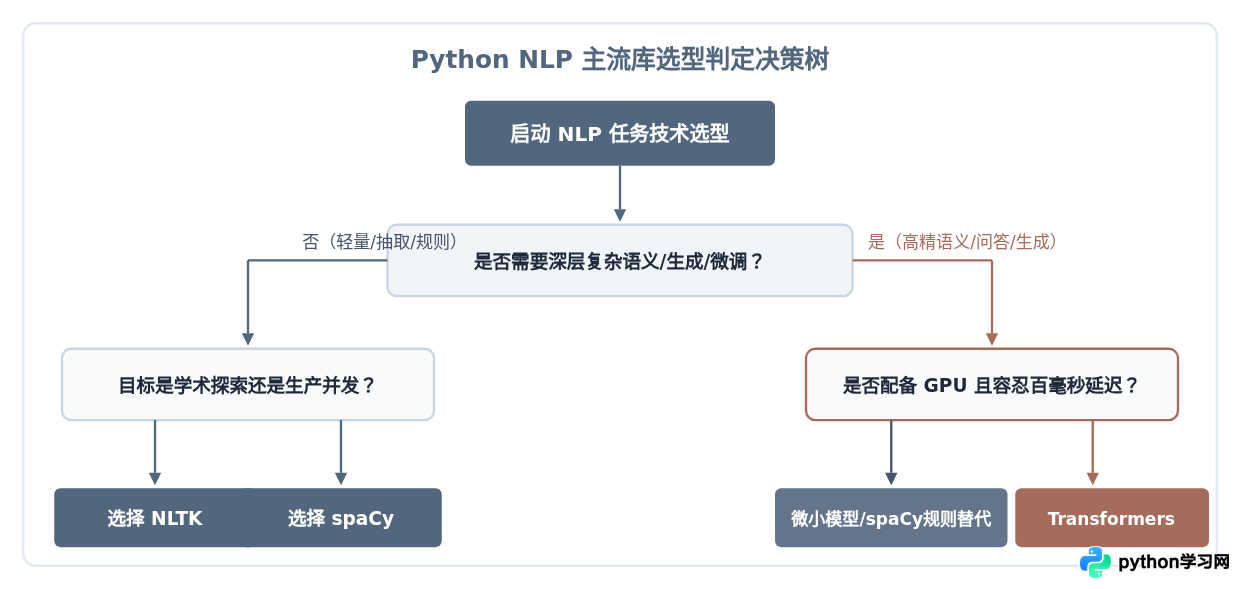
综合对比矩阵
| 评估维度 | NLTK | spaCy | Transformers |
|---|---|---|---|
| 计算吞吐能力 | 较低(纯 Python 循环) | 极高(Cython 密集向量优化) | 依赖硬件(CPU 慢,GPU 批量快) |
| 硬件门槛 | 普通单核 CPU 即可运行 | 中等配置多核 CPU | 推荐主流 GPU(显存通常需 ≥ 4GB) |
| 语义深度 | 浅层规则与词频统计 | 中层语法依存与统计实体 | 深层上下文自注意力语义 |
| API 风格 | 松散工具箱(需手动组装) | 工业流水线(标准 Doc 容器) | 模型抽象与流水线(Pipeline/AutoModel) |
| 多语言生态 | 依赖外部分词插件扩展 | 包含丰富多语种开箱模型 | 海量全球语言模型即下即用 |
五、生产实践:协同混用架构与落地建议
在大型工业级 NLP 落地项目中,最优解往往不是“单挑”,而是分工协同。常见的成熟工程实践是将 spaCy 作为前置过滤器与流水线中枢,配合 Transformers 负责核心深层判定:
- 初筛阶段(spaCy / 正则):对千万级原始文本进行清洗、分句、命名实体初筛与停用词移除。由于 spaCy 处理速度快两个数量级,这能直接过滤掉 80% 的无效无语义流量。
- 深筛阶段(Transformers):仅将经过初筛命中的关键片段输入小参数量模型(如 RoBERTa、DistilBERT 或特定领域微调模型)进行高精细度意图分类。
避坑提示:避免在后端 API 请求主线程中频繁调用 spacy.load() 或重新初始化 pipeline()。模型权重文件体积较大,应将其加载为全局单例或服务进程预热资源;批量处理文本时,务必使用 nlp.pipe(texts, batch_size=256) 代替逐条循环,以发挥底层 C 级缓存与批处理加速效能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















