


Python调试时选print、sys.stdout.write还是logging

print、sys.stdout.write 还是 logging,本质上是在开发效率、流式控制与工程可维护性之间做出权衡:几行验证代码的轻量探针优先选 print;终端动态刷新、非换行格式流首选 sys.stdout.write;而涉及多模块协同、异步服务或具备生产生命周期的代码,必须统一采用 logging。本文将从底层流机制、控制粒度与工程重构三个层面,讲透这三者的选择边界与实践方法。
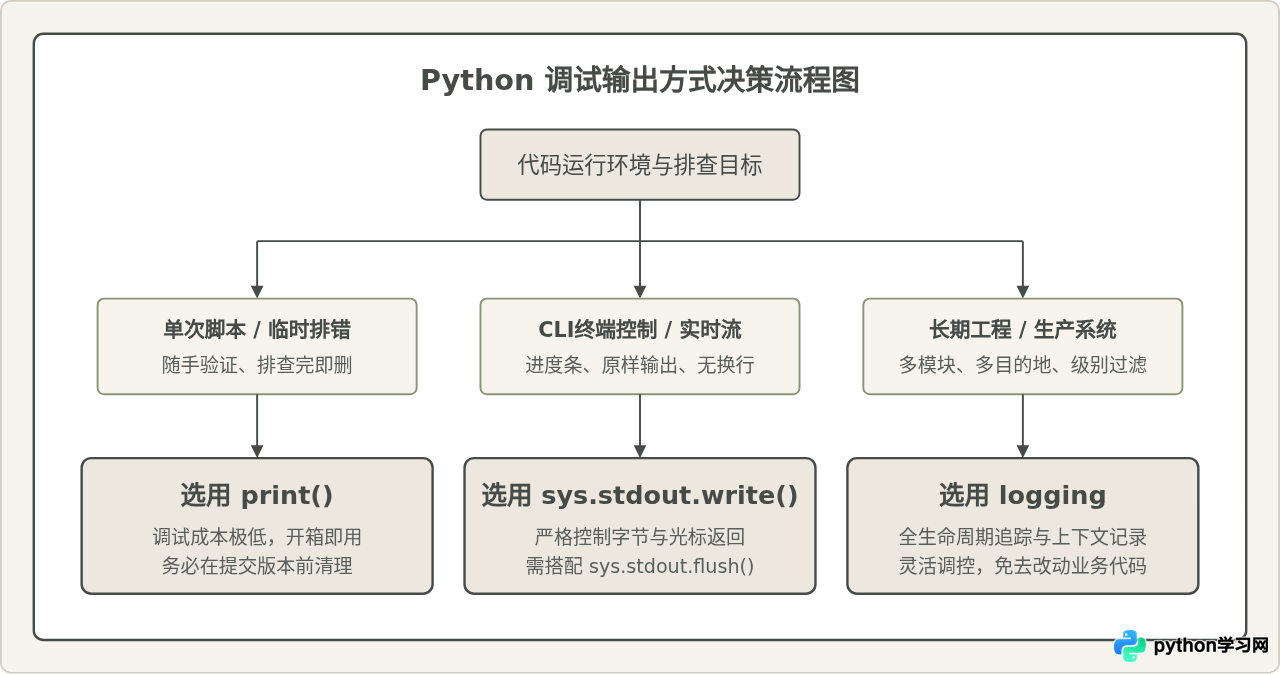
一、核心定位与选型判断路径
很多开发者在写代码时习惯随手写下 print(),当遇到多线程乱序、部署到服务器日志丢失、或者需要动态过滤级别时,才意识到输出方式对系统调试成本的深远影响。这三个工具并非互相替代的竞争关系,而是处于不同抽象层级的输出组件:
- print(): Python 内置的高层通用打印函数,提供了自动格式化、对象转字符串、指定分隔符及自动追加换行符等便利特性,是交互式探索与验证小段逻辑最快的手段。
- sys.stdout.write(): 标准输出流的最底层直接写入接口,不自动追加换行符,也不对入参进行自动类型转换,直接操作文本缓冲区,适合精细的行内流式刷新与管道交互。
- logging: 标准库中功能完备的日志框架,具备日志等级划分、多目标分流(控制台、文件、网络)、格式化模板(时间戳、模块名、行号)以及非侵入式开闭能力,是工程化排错的基石。
二、底层调用链与实现机制剖析
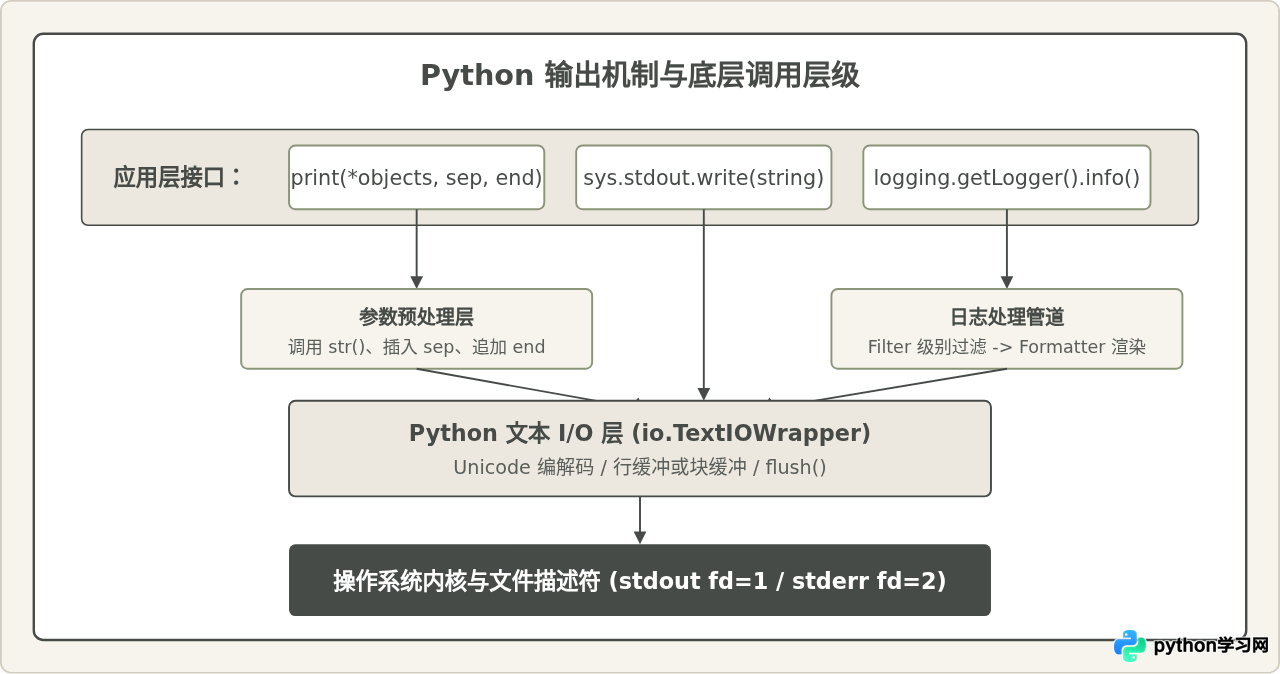
为了看懂为什么它们在行为和性能上有差异,我们需要观察 Python 是如何将数据推送到操作系统的标准输出描述符中的。事实上,print 并非直接与操作系统系统调用交互,它的底层就是依赖 sys.stdout.write 完成输出的。
1. print 的便利与隐式开销
print() 在 Python 内部的工作流程大致如下:遍历传入的所有参数,依次调用 str() 将其转成字符串;在各个元素间插入 sep 字符(默认为空格);最后写入 end 字符(默认为换行符 \n)。
# print 的行为等价伪逻辑
def custom_print(*args, sep=' ', end='\n', file=None, flush=False):
    f = file or sys.stdout
    text = sep.join(str(arg) for arg in args) + end
    f.write(text)
    if flush:
        f.flush()
这种自动化包装使得我们在单机调试时敲击代码极其方便,例如 print("status:", code, result)。但也带来了两个制约:一是当输出频次极高(如几十万次循环)时,多余的字符串格式化与参数拼装会带来微小但累积的 CPU 开销;二是默认追加换行符,如果需要光标停留在原地刷新进度,就必须显式传递 end='' 并手动触发 flush=True。
2. sys.stdout.write 的流特性与缓冲陷阱
sys.stdout.write() 是对标准输出文本流的直接写操作。它有两个铁律:
- 只接受单一字符串入参: 传入数字、布尔值或字典时会直接抛出
TypeError: write() argument must be str, not int。 - 绝不自动附加换行符与自动刷新: 如果没有写入
\n且未调用sys.stdout.flush(),在终端默认为行缓冲模式下,内容很可能会一直滞留在应用级缓冲区,导致界面迟迟看不到输出。
import sys
import time

# 常见控制台原地动态刷新进度示例
for i in range(1, 101):
    sys.stdout.write(f"\r处理进度: [{i}%]")
    sys.stdout.flush()  # 确保缓冲区内容立即输出到终端
    time.sleep(0.02)
sys.stdout.write("\n")
三、为什么长期工程排查必须走向 logging
很多项目在初期到处充斥着 print(),一旦项目被部署为守护进程,或者由多个人协同维护,调试噩梦便随之而来:你无法区分哪一行是哪个模块输出的;你无法关掉低级日志而只留异常;你甚至无法知道这行内容是哪一分哪一秒发生的。
logging 模块将“记录事件”与“如何展现/保存事件”彻底解耦。开发者在代码中只需声明事件级别和上下文,最终由配置决定将这些事件写入标准输出、写入按天轮转的磁盘日志文件,还是发送至监控告警中心。
import logging

# 推荐的基础规范配置
logging.basicConfig(
    level=logging.DEBUG,
    format="%(asctime)s [%(levelname)s] %(name)s (%(filename)s:%(lineno)d): %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)
logger = logging.getLogger(__name__)

def fetch_order(order_id: int):
    logger.debug("正在查询订单缓存, order_id=%s", order_id)
    try:
        # 模拟业务逻辑
        pass
    except Exception as e:
        logger.exception("处理订单异常: %s", e)
如上代码所示,当生产环境需要降噪时,只需要将根日志等级调整为 logging.INFO,整个代码库中所有的 logger.debug(...) 调用将直接跳过后续处理,无需去每个文件中逐行删除或注释 print 语句。
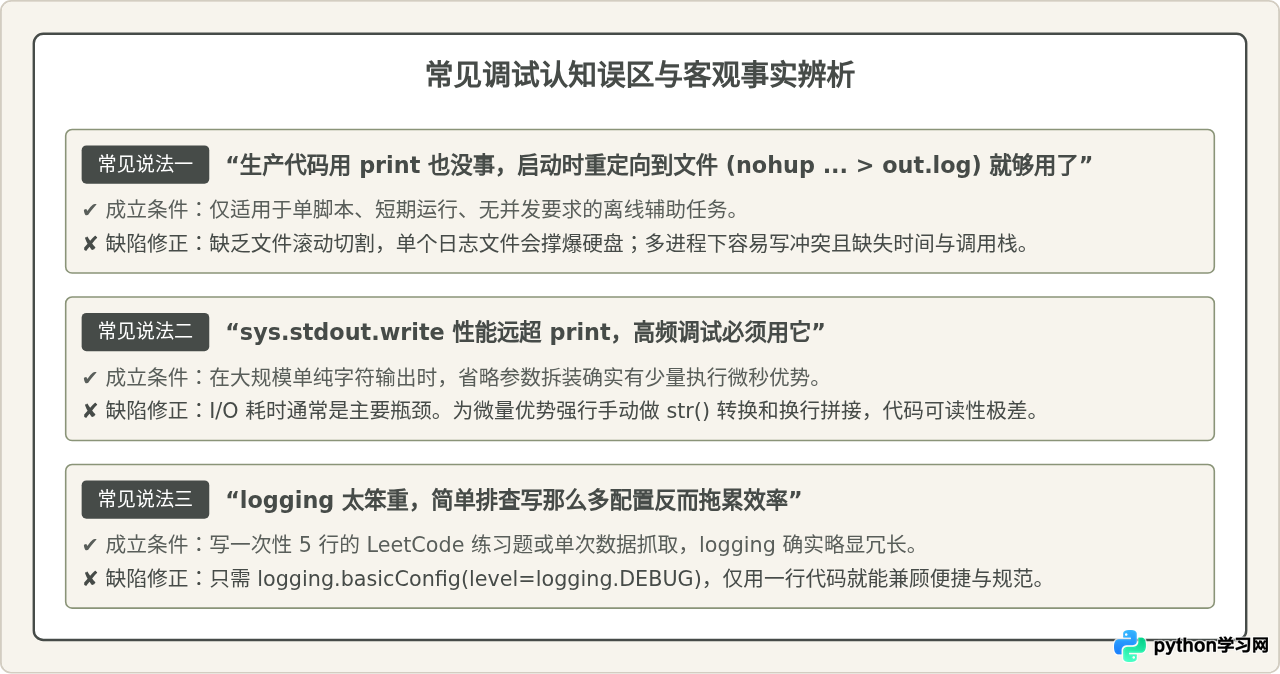
四、容易混淆的说法与认知辨析
在技术讨论中,围绕这三者常有一些看似合理但有偏颇的说法。我们结合具体使用场景进行客观辨析:
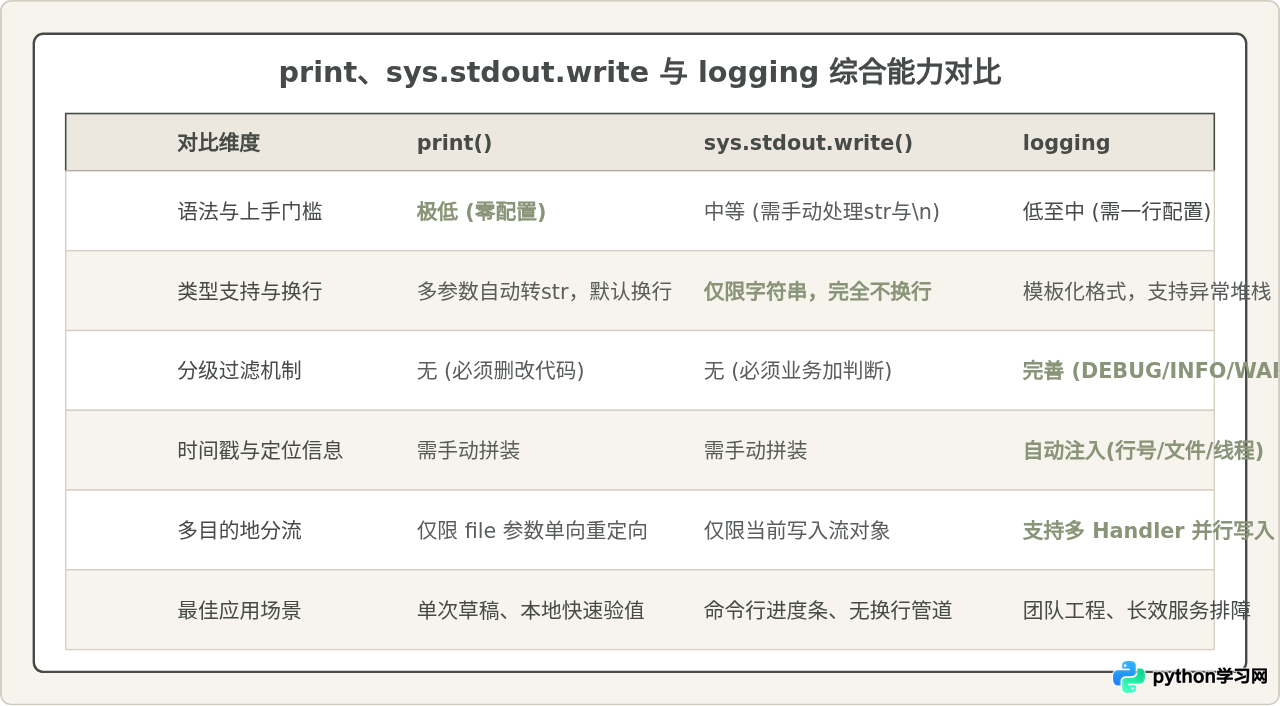
五、特性综合矩阵与选型推荐
为了让不同阶段的技术决策更直观,我们将它们在核心工程维度上的表现归纳如下:
六、日常开发的渐进式演进策略
在实际编码节奏中,并不需要一开始就为每一段探索性逻辑写满日志配置,也不应当放任 print 渗透到核心业务逻辑中。推荐遵循“渐进演进”的原则:
print()。这个阶段讲究反馈闭环在几秒钟之内完成。
sys.stdout.write() 配合显式 sys.stdout.flush()。
print() 替换为对应级别 logger 调用的习惯:
- 探针式变量打印转换为
logger.debug("var_name=%s", var); - 关键业务节点转换为
logger.info("任务已启动, id=%s", task_id); - 捕获异常处直接调用
logger.exception("...")自动保留完整 Traceback。
理解这三者在控制粒度与职责边界上的差异,能帮助我们在快速试错与长效维护之间取得平衡,让调试输出真正成为解决问题的利器,而非生产事故时的干扰噪声。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















