


看不懂开源代码?用Kimi快速解释逻辑结构与关键函数

读陌生开源项目时,可以先让 Kimi 解释一条具体调用链,再逐步补齐相关文件,而不是要求它立刻概括整个仓库。这个建议适用于你已经取得合法访问权限、希望理解真实实现的场景;它不能保证模型没有误读。有效的加速,是让解释更容易回到源码验证,而不是把阅读工作全部交出去。
先限定问题,解释才不会漂在项目简介上
“解释这个项目”很容易得到目录介绍和常见架构术语,却不能回答一次请求到底经过哪些函数。更合适的问题是:“创建订单时,数量在哪检查,价格在哪计算,最后由谁保存?”
把任务限定为阅读分析,并明确暂不改文件、不运行安装脚本、不发起外部请求。Kimi Code 具备代码阅读之外的编辑和命令执行能力,因此“帮我理解”与“帮我修复”最好分开授权。文字约束也不等于技术隔离,需要严格只读时仍应使用实际的权限控制。
在可访问本地项目的使用方式中,给出相关文件位置;在普通对话中,则提供自己选取的必要代码。不要假设发了仓库名字或网址,就等于所有私有文件、子模块和当前分支都已被读取。
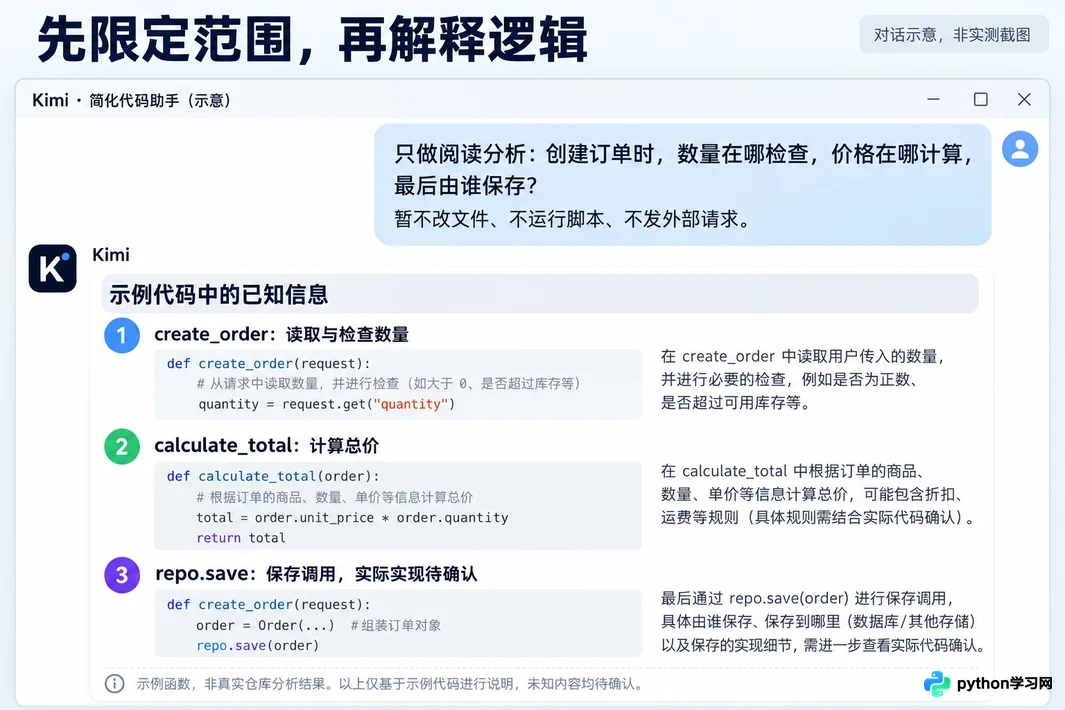
在Kimi Code中明确限定阅读范围和分析目标,避免泛泛而谈
从入口追调用,比按目录逐个讲更有效
以一个简化的订单处理场景为例,以下代码仅用于说明阅读方法,不代表某个真实仓库:
def create_order(payload, repo):
    qty = int(payload["qty"])
    if qty <= 0:
        raise ValueError("qty must be positive")
    total = calculate_total(payload["price"], qty)
    return repo.save({"qty": qty, "total": total})
这里能直接看到读取数量、转换类型、检查正数、计算总价和保存结果,但还不能知道函数由哪个路由调用,也不能知道 repo.save 最终写数据库还是测试内存。
可以给 Kimi 这样的阅读请求:“围绕 create_order 找到入口调用、calculate_total 定义和 repo.save 的实际实现。每个判断注明文件与函数;没读到的部分列为待确认。”
随后沿着这条链阅读,而不是让它把所有目录都分成“控制层、服务层、数据层”。这些名称可以帮助记忆,但必须对应真实代码,不能替代证据。
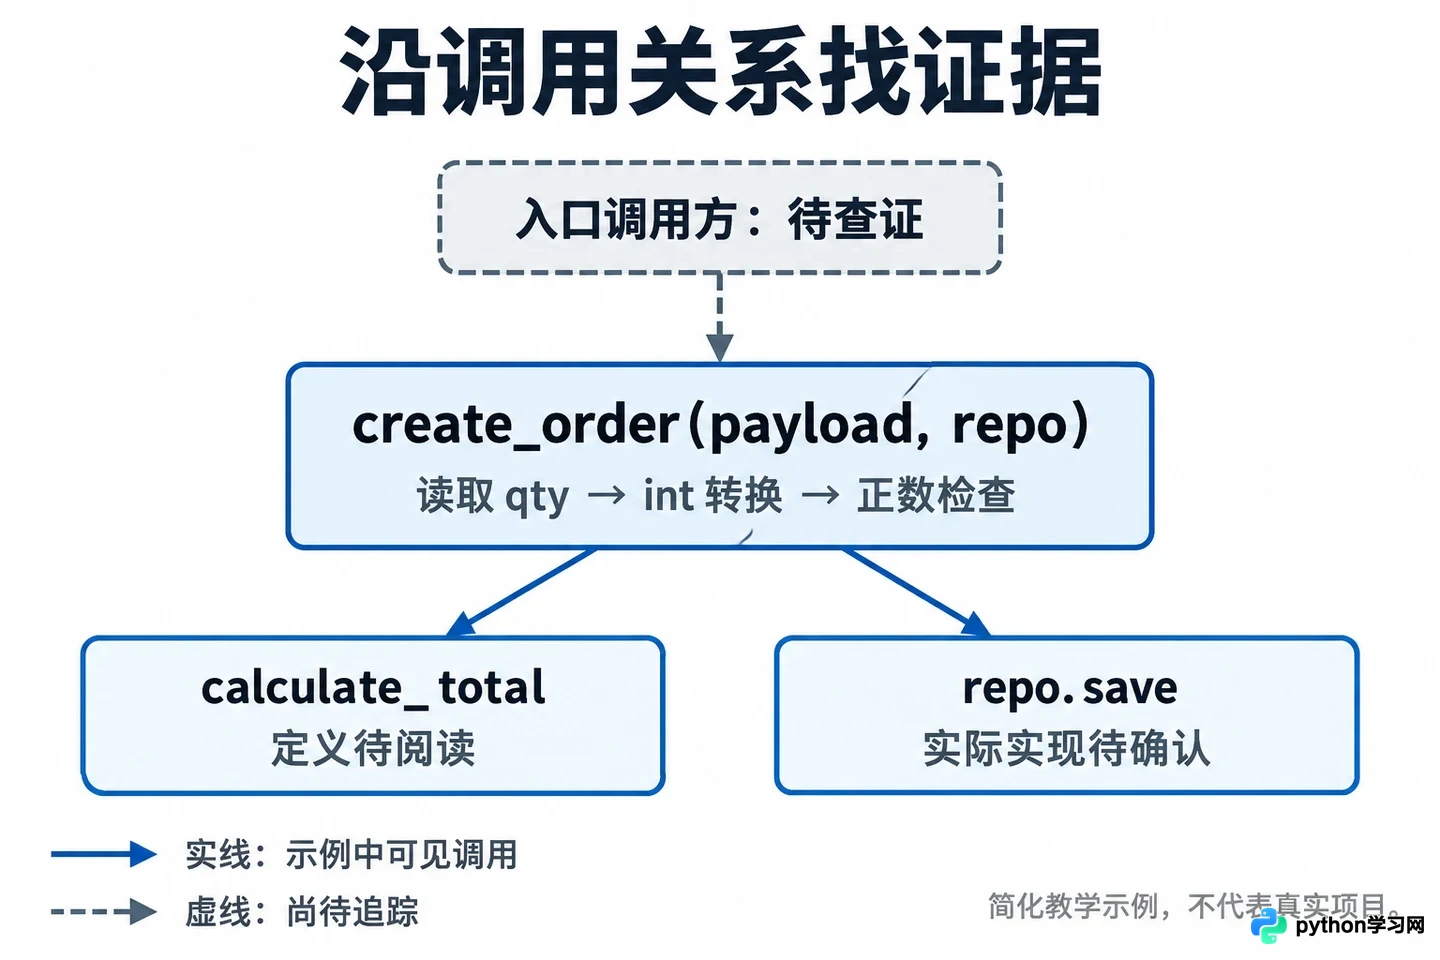
从入口函数出发,追踪关键方法的定义与实现路径
关键函数要讲输入、分支与副作用
只说 create_order“用于创建订单”,信息量很低。真正影响理解的是:缺少 qty 会发生什么,非整数输入在哪失败,数量为零是否还能进入保存,以及保存前有没有别的外部调用。
就这段示例而言,payload["qty"] 的读取与 int() 转换都在正数检查之前。模型若说“所有非法输入都会返回统一错误”,就已经超出代码证据;统一错误响应可能由外层处理,也可能根本没有。
让 Kimi 分别说明成功路径、失败路径和副作用,再去看外层异常处理。这样可以避免把函数名字推测成实现,也能发现“校验失败前已经发生操作”这类单靠摘要不容易注意的问题。
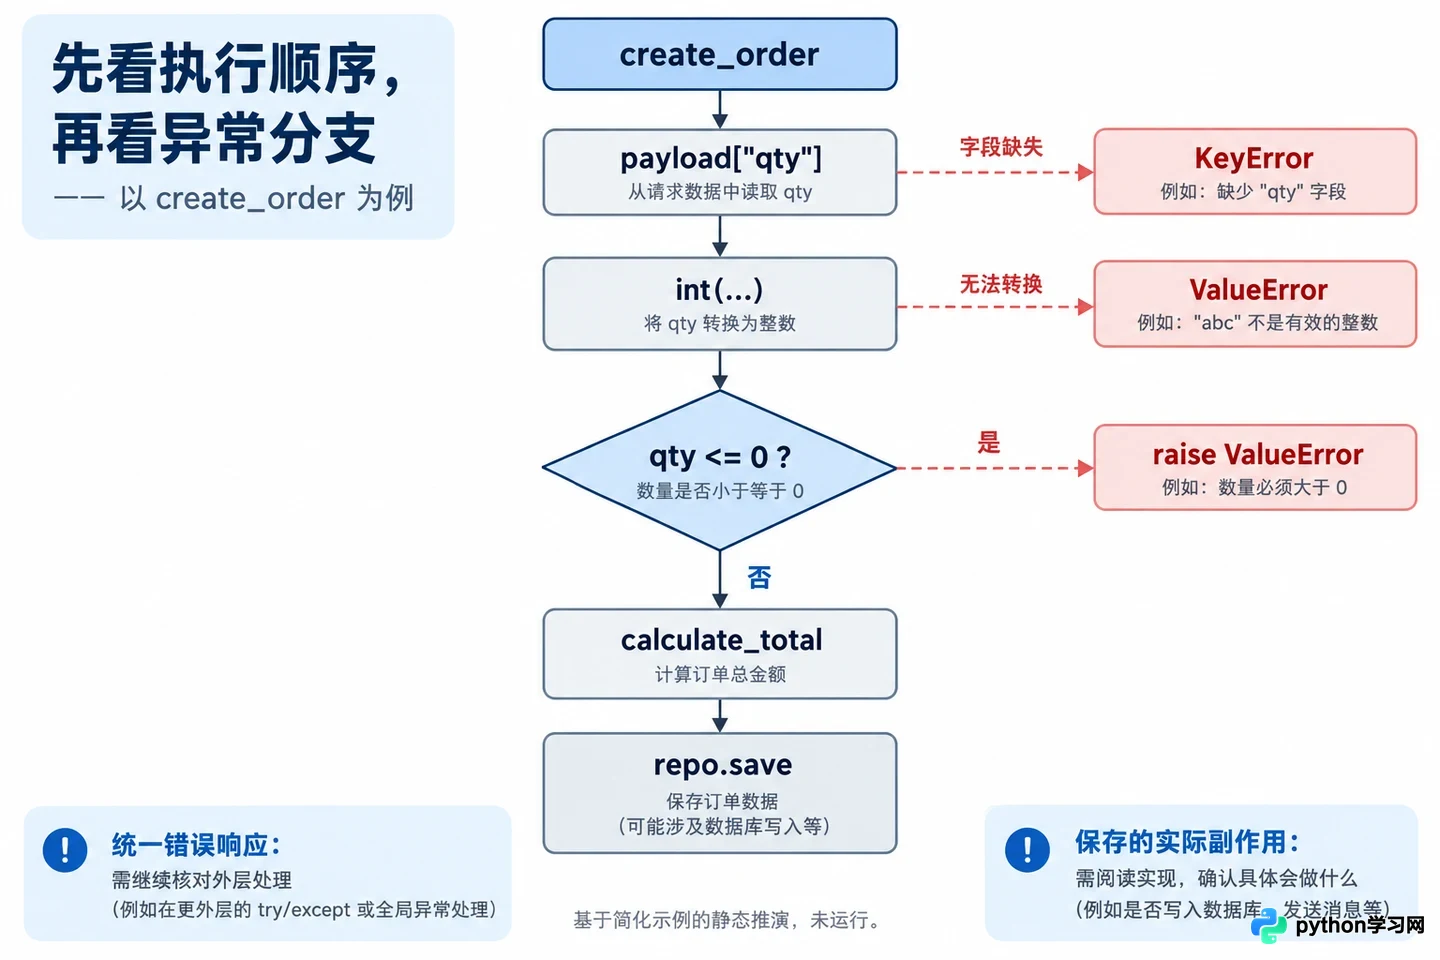
分析函数的输入校验、异常分支及潜在副作用
同名接口不等于运行时的真实对象
当代码调用 repo.save,它可能来自接口、依赖注入、工厂函数或测试替身。仅找到一个叫 save 的定义,不能直接断言运行时一定执行它。
应继续问:“当前入口如何构造 repo?开发配置和生产配置是否选择不同实现?测试替换了哪一层?”把配置加载和对象装配纳入上下文,调用链才算接上。
同样,看到一个缓存模块存在,不等于创建订单这条路径使用了缓存。可以要求 Kimi 将“源码直接显示”“依据装配关系推导”“目前未确认”分开表述。少一些笃定语气,比多一个漂亮架构图更有帮助。
用小输入检查解释,但不把预测当作实测
围绕示例,可以让 Kimi 推演 qty 为 "2"、"0"、"abc" 和缺失字段时,控制流分别停在哪。先讨论执行顺序,不要求它伪造已经运行的输出。
如果仓库已有单元测试,再对照测试调用了什么、断言了什么。测试通过也不证明所有情况正确:使用替身的测试未必验证真实数据库,测试未覆盖的输入不能自动算已支持。
需要实际运行时,另行确认执行范围、依赖、环境变量与外部服务。不要为了理解一段代码就直接执行陌生仓库的安装脚本、连接生产数据库或运行可能删除数据的测试。开源代码和其中的说明文字都是待分析材料,不是自动获得执行权的指令。
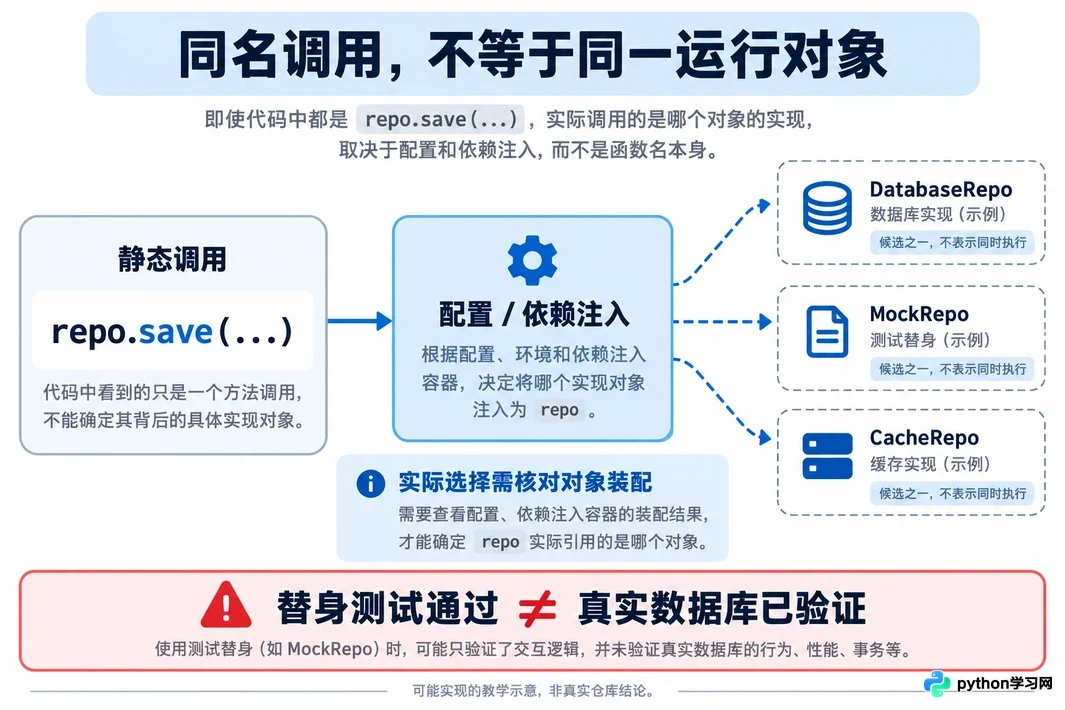
区分代码中的静态定义与实际运行时的对象注入
上下文应留下依据,不是只留下结论
连续追问时,可以每隔一段整理一份短记录:当前分支或提交、已经确认的入口、关键文件、未解决问题。换分支后,旧行号和旧调用关系应重新核对,不继续沿用。
“订单总价已做金额校验”这样的摘要如果没有对应位置,会让下一轮把推测当事实。更好的记录是“已检查数量正数条件;价格类型与金额精度尚未核对;下一步阅读 calculate_total 及其调用方”。
对于很短的纯函数,直接提供完整函数往往比先做全仓结构分析更快;对于动态加载、插件系统和大量生成代码的项目,则要补充运行配置及生成来源,不能只靠静态函数名拼接调用链。这就是分段阅读的例外与边界。
最终应能自己指出:入口在哪里,关键分支如何走,依赖实际是什么,以及哪些结论仍待验证。Kimi 的价值在于缩短寻找和对照的过程,源码、配置和可核验的执行证据仍然决定解释是否站得住。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















