


Python处理百万行Excel数据太慢?试试这些高性能库

在数据处理与日常自动化任务中,当数据量逼近甚至达到数十万至百万行时,直接使用 pandas.read_excel() 往往会导致程序卡顿数分钟甚至触发内存溢出(OOM)崩溃。解决这一问题的根本途径并不在于盲目升级硬件,而在于看清 Excel 的底层结构缺陷,并改用 Rust 驱动的 python-calamine、现代化列式引擎 Polars,或采用流式读取与格式转换策略。
一、为什么常规方式处理百万行 Excel 会异常缓慢?
很多开发者习惯于直接运行 import pandas as pd; df = pd.read_excel("large_file.xlsx")。在数据量只有几千行或几万行时,程序表现尚可;但当行数接近 Excel 单表上限(1,048,576 行)时,执行时间往往长达 5 到 15 分钟,甚至让 16GB 内存的机器瞬间卡死。
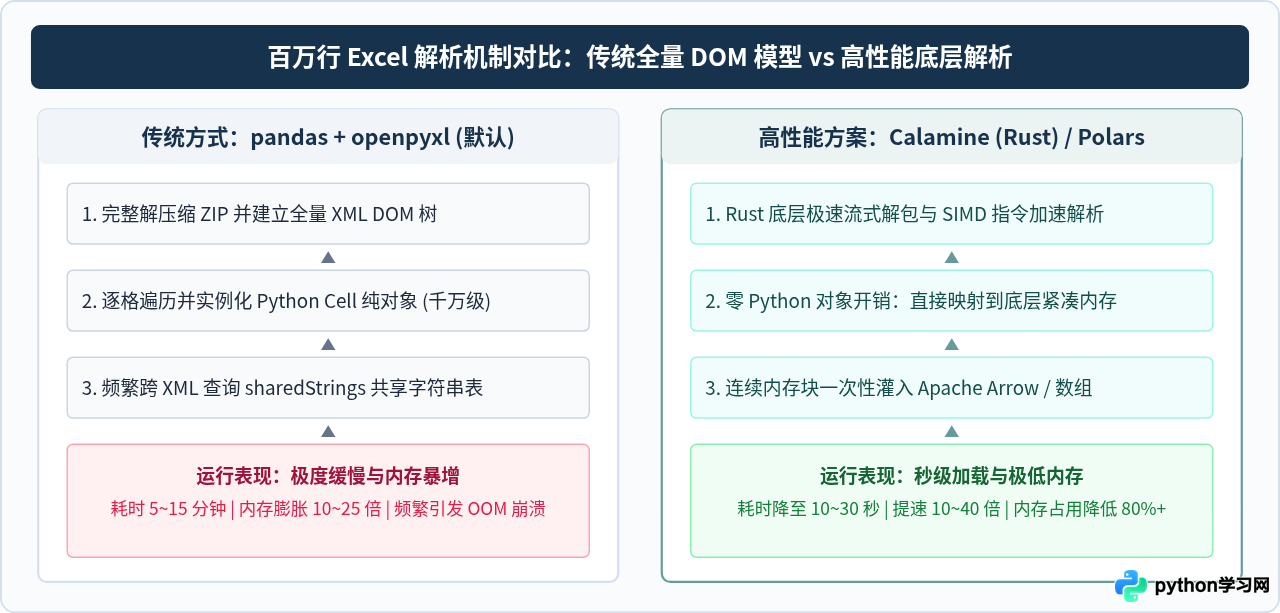
这一瓶颈主要由以下三个底层机制共同决定:
- XML 压缩包结构解包代价大:现代
.xlsx文件本质上是一个遵循 OpenXML 标准的 ZIP 压缩包,内含多个 XML 文档(如xl/worksheets/sheet1.xml、xl/sharedStrings.xml)。读取时必须先解压 ZIP,再对海量的 XML 节点进行文本解析与属性匹配。 - 默认引擎 openpyxl 的对象膨胀效应:Pandas 默认依赖的
openpyxl引擎采用全内存 DOM 树解析模型。对于每一行、每一个单元格,它都会在 Python 虚拟机中创建一个庞大的Cell对象(包含坐标、格式、样式、字体等完整上下文)。一个原本仅几百兆的表格,解析成 Python 对象后可能膨胀数十倍,占用数吉字节的堆内存。 - 字符串共享表的全局遍历开销:Excel 为了节省存储空间,会将所有单元格文本统一存放在共享字符串表(sharedStrings)中。解析时需要不断在主表与共享表之间频繁查找与关联,单线程的 Python 在处理海量字典查找时效率极低。
二、无缝改造首选:基于 Rust 的 python-calamine 引擎
如果你现有的分析工作流深度依赖 Pandas,无法接受推倒重写,那么最平滑、改动最小的解决方案就是使用 python-calamine。
Calamine 是 Rust 生态中知名的高性能 Excel 读取库,而 python-calamine 是其针对 Python 的官方绑定封装。从 Pandas 2.0 开始,官方已经原生将 calamine 纳入了可选读取引擎之一。只需在已有代码中追加一个参数,即可实现 10 倍到 30 倍的速度跃升。
1. 安装依赖
pip install python-calamine pandas2. 使用示例
在调用 read_excel 时,显式指定 engine="calamine":
import pandas as pd
import time

start_time = time.time()

# 显式指定引擎为 calamine
df = pd.read_excel(
    "large_sales_data.xlsx",
    sheet_name="2026_All_Records",
    engine="calamine"
)

print(f"数据加载完成,共 {len(df)} 行,耗时: {time.time() - start_time:.2f} 秒")
print(df.head())
优势:无需调整任何下游数据清洗或分析代码,保持 pd.DataFrame 格式完全一致;完美支持 .xlsx、.xls、.xlsb、.ods 等多种格式。
注意:Calamine 是一个纯只读解析器,不支持写回或修改现有 Excel 文件;如果需要修改或回写样式,仍需使用 openpyxl。
三、极致性能利器:Polars 结合 Calamine 引擎
如果你不仅需要“快读”,还需要在后续对这百万行数据进行高速分组聚合(Group By)、多表连接(Join)或向量化过滤,那么 Polars 是更理想的现代化选型。
Polars 本身采用 Rust 构建,基于 Apache Arrow 内存格式,天生支持列式存储、多线程并发执行和查询优化。Polars 的 read_excel 函数原生内置了对 calamine 引擎的支持,两者结合能将整个加载与计算流程的速度推向极致。
1. 安装依赖
pip install polars fastexcel pyarrow2. 使用示例
import polars as pl
import time

start_time = time.time()

# 使用 polars 直接读取,使用 calamine 引擎
lazy_df = pl.read_excel(
    source="large_sales_data.xlsx",
    sheet_name="2026_All_Records",
    engine="calamine"
)

# 开展高效向量化聚合统计
summary = (
    lazy_df
    .filter(pl.col("status") == "COMPLETED")
    .group_by("region")
    .agg([
        pl.col("amount").sum().alias("total_sales"),
        pl.col("order_id").count().alias("order_count")
    ])
    .sort("total_sales", descending=True)
)

print(f"Polars 处理完成,耗时: {time.time() - start_time:.2f} 秒")
print(summary)
得益于底层 Arrow 内存布局,Polars 读取后的内存占用通常仅为 Pandas 的三分之一甚至更低,并且在多核 CPU 上计算统计指标时,耗时通常只需数十毫秒。
四、极端内存受限场景:openpyxl 的流式只读模式
在某些运行环境中(例如只有 512MB 或 1GB 内存的低配云服务器、Docker 容器或边缘设备),即便使用 Rust 高性能引擎,一次性将百万行数据全部反序列化到内存中仍可能引起内存告警。
此时应采用流式只读模式(Streaming / Generator),即通过 openpyxl.load_workbook(..., read_only=True) 逐行迭代消费,读取一行、处理一行、释放一行。
流式生成器代码示例
from openpyxl import load_workbook
import time

start_time = time.time()

# 开启 read_only=True 模式,使用基于事件的只读流
wb = load_workbook("large_sales_data.xlsx", read_only=True, data_only=True)
sheet = wb["2026_All_Records"]

processed_count = 0
total_revenue = 0.0

# 逐行迭代,内存占用保持在数十兆以内恒定不变
header = None
for row in sheet.iter_rows(values_only=True):
    if header is None:
        header = row
        continue

    # 假设索引 3 为销售金额,进行流式累加
    amount = row[3]
    if amount is not None and isinstance(amount, (int, float)):
        total_revenue += float(amount)

    processed_count += 1
    if processed_count % 200000 == 0:
        print(f"已流式处理 {processed_count} 行...")

wb.close()
print(f"处理完成,总行数: {processed_count},总金额: {total_revenue:.2f},耗时: {time.time() - start_time:.2f} 秒")
由于不创建完整的内部对象树,read_only=True 的内存占用几乎恒定在 30MB~50MB 之间。虽然由于 Python 本身的循环开销,其总体耗时比 Rust 引擎长,但在小内存或批处理落库(如逐批入库 MySQL/PostgreSQL)场景下,它是极具韧性的保底方案。
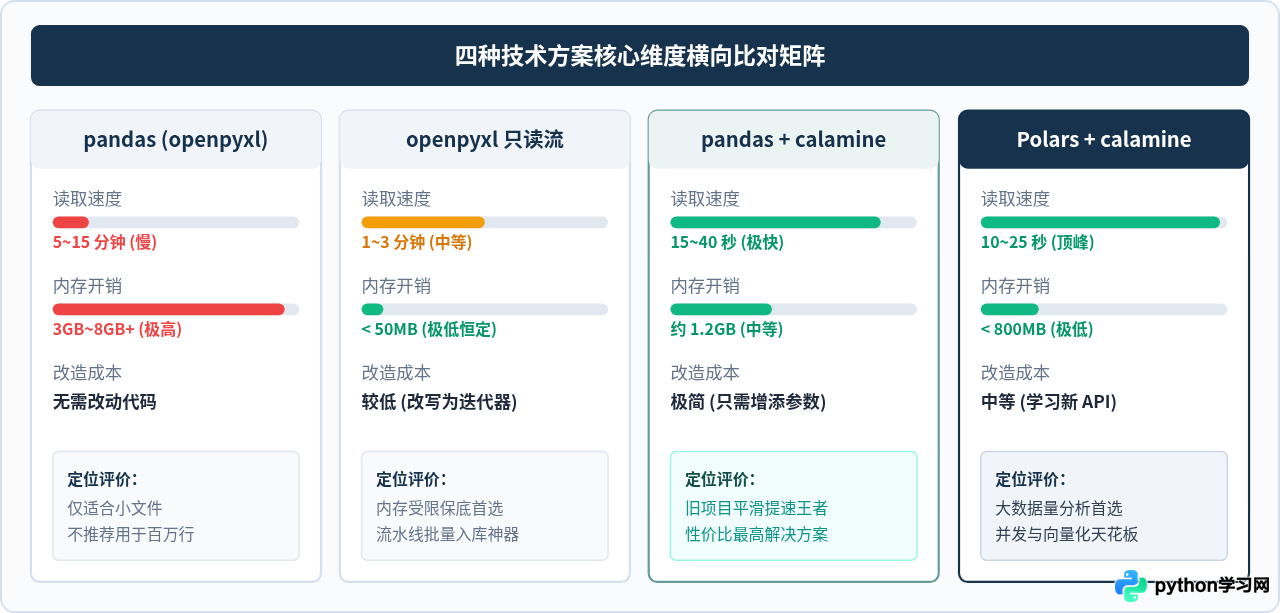
五、四大主流处理方案选型矩阵
为了帮助读者根据手头任务的性质做出最优选择,下表对四种常见技术方案在关键维度上的表现进行了汇总归纳:
| 技术选型方案 | 读取速度 (百万行) | 内存消耗 | 是否支持修改/回写 | 学习与改造成本 | 最适合的应用场景 |
|---|---|---|---|---|---|
| pandas + openpyxl (默认常规方式) |
极慢 (5~15 分钟) |
极高 (3GB~8GB+,易 OOM) |
支持 | 零成本 | 10 万行以内的小文件或需精确修改单元格样式 |
| pandas + calamine (无缝换引擎) |
极快 (15~40 秒) |
中等 (1GB~2GB) |
仅只读 | 极低 (仅需修改 1 行参数) |
已有 Pandas 生产代码迁移,追求快速提速 |
| Polars + calamine (现代化列式方案) |
极快 (10~25 秒) |
低 (500MB~1GB) |
仅只读 | 中等 (需掌握 Polars 语法) |
高并发、大规模数据分析、复杂聚合过滤 |
| openpyxl 只读流 (read_only=True) |
中等 (1~3 分钟) |
极低 (< 50MB 恒定) |
仅只读 | 低 (编写普通 Python 迭代) |
低配服务器、流水线逐行入库或按批落盘 |
六、百万级 Excel 数据实战优化处理四步法
在实际生产环境中,针对百万行级别的数据,最稳健的做法往往是“一次快速读取、立即固化为分析型格式”。下面以一个完整端到端流程演示这四个核心步骤。
步骤 1:安装依赖与环境验证
确保 Python 环境安装了最新版的 python-calamine、polars 与高效序列化库 pyarrow:
pip install --upgrade python-calamine polars pyarrow步骤 2:使用 Calamine 引擎秒级装载并裁剪类型
在读取阶段,明确指定需要用到的列名(或使用索引裁剪),避免读取多余无效列:
import polars as pl

# 仅指定需要处理的列字段
selected_columns = ["order_id", "user_id", "order_date", "amount", "status"]

# 秒级装载原始百万行 Excel
df = pl.read_excel(
    source="raw_million_records.xlsx",
    sheet_name="Sheet1",
    engine="calamine",
    columns=selected_columns
)
print(f"数据成功装载,当前行数: {df.height},列数: {df.width}")
步骤 3:数据清洗与内存类型精简优化
原始表格中的数字通常默认为 64 位浮点数或整型,通过向下转型(Downcasting)可使后续分析速度提升数倍:
# 数据类型优化:转换日期格式,缩减整型与浮点数精度
df_clean = df.with_columns([
    pl.col("order_date").str.to_date("%Y-%m-%d"),
    pl.col("user_id").cast(pl.UInt32),
    pl.col("amount").cast(pl.Float32),
    pl.col("status").cast(pl.Categorical)
])
步骤 4:持久化为高性能列式文件 (Parquet)
Excel 从设计初衷上就不是为海量数据分析存储而生。一旦完成初始清洗,应立即将其转存为 Parquet 格式。转换后,原本 150MB 的 Excel 文件通常仅占用 20MB 左右磁盘空间,且后续读取只需不到 0.3 秒:
# 导出为 snappy 压缩的列式 Parquet 文件
df_clean.write_parquet(
    "million_records.parquet",
    compression="snappy"
)
print("转换完成!后续所有业务代码直接读取 million_records.parquet 即可。")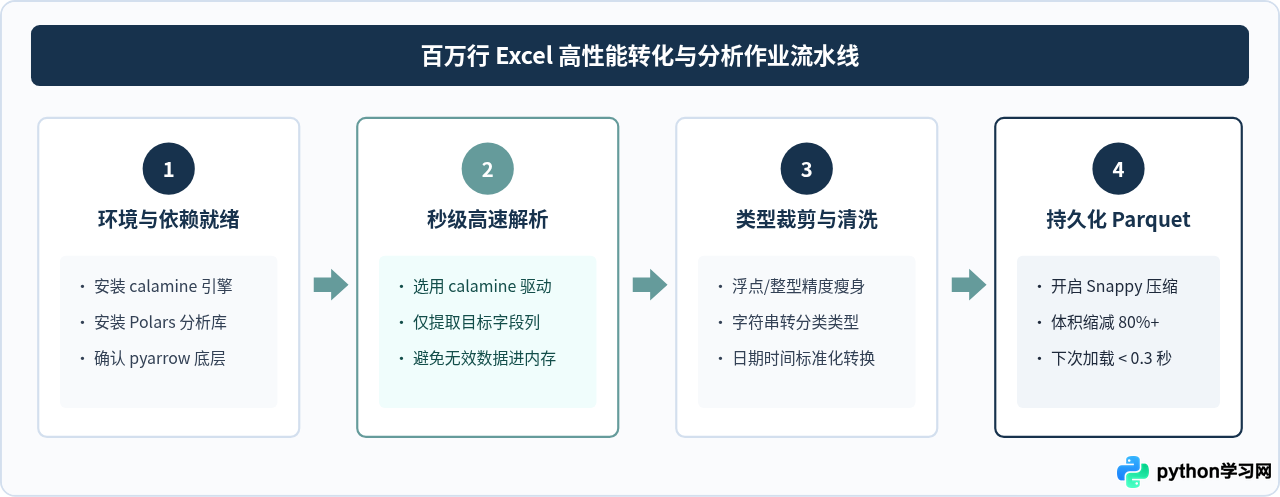
七、实际使用中的关键陷阱与避坑建议
在追求高性能解析的同时,有几处细节容易引起数据偏差,需提前留意:
- 公式单元格的处理(Formula vs Cached Value):Calamine 默认读取的是 Excel 单元格中预先计算好的缓存数值(Cached Values),而不会动态重新运行 Excel 公式。如果工作簿保存前未经过计算(或被第三方脚本生成但未计算),读取到的值可能为
None。如果必须读取公式本身,需评估业务逻辑。 - 日期类型识别(Excel 序列数字):Excel 底层将日期存储为自 1900 年以来的浮点数天数。Calamine 对标准日期格式能够精确还原,但若原始表格格式混杂,建议先以原始数字载入后统一使用自定义逻辑进行校验与转换。
- 混合列数据类型推断(Mixed Dtype):如果同一列上方为数字、下方夹杂字符串批注,高性能解析器可能在类型推断时将其转为字符串或引发解析警告。建议在调用时显式指定
schema_overrides或dtypes。
八、总结与技术选型决策树
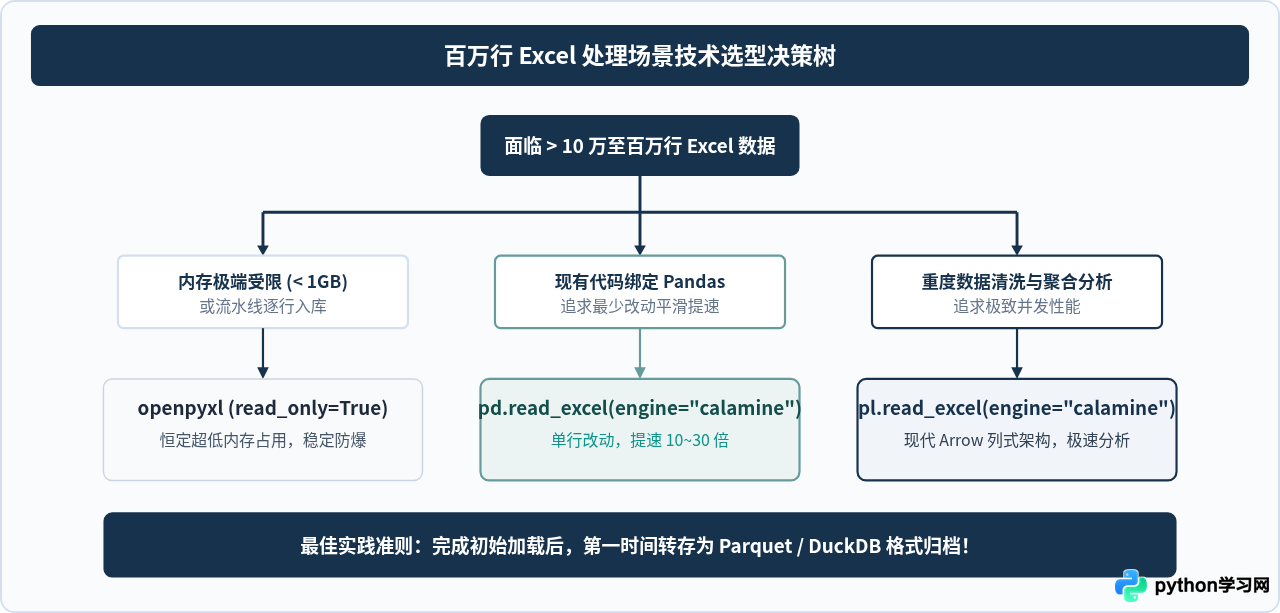
面对百万行级 Excel 数据,处理缓慢的核心痛点是底层 DOM 对象的内存膨胀。通过引入 Rust 驱动的 calamine 引擎,我们可以在不改变原有 Pandas 体系的前提下轻松提速数十倍;若进一步拥抱 Polars,更能将加载与分析推向真正的现代向量化极速体验;在资源受限场景下,openpyxl 的只读流模式则是可靠的防崩溃保障。
下图总结了在面对大体积 Excel 文件时的技术决策路径:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















