


Python t检验报错:维度不匹配、NaN值及数据类型错误排查

在 Python 数据分析与统计建模过程中,scipy.stats 模块提供的 ttest_ind(独立双样本 t 检验)与 ttest_rel(配对样本 t 检验)是使用频率极高的假设检验函数。但在实际调用中,程序往往会抛出 ValueError、TypeError,或者直接返回毫无意义的 nan 统计量。这三类问题的根本原因通常不是算法本身的缺陷,而是输入数据的物理形状(维度)、质量状态(缺失值)与内存表示(数据类型)未达到底层数学运算的前提要求。解决这一系列报错的核心路径在于:先做类型强转与数值清洗,再针对检验类型执行成对或单侧缺失值剔除,最后拉平并校验数组形状。
一、排查路径概览:从原始输入到安全检验
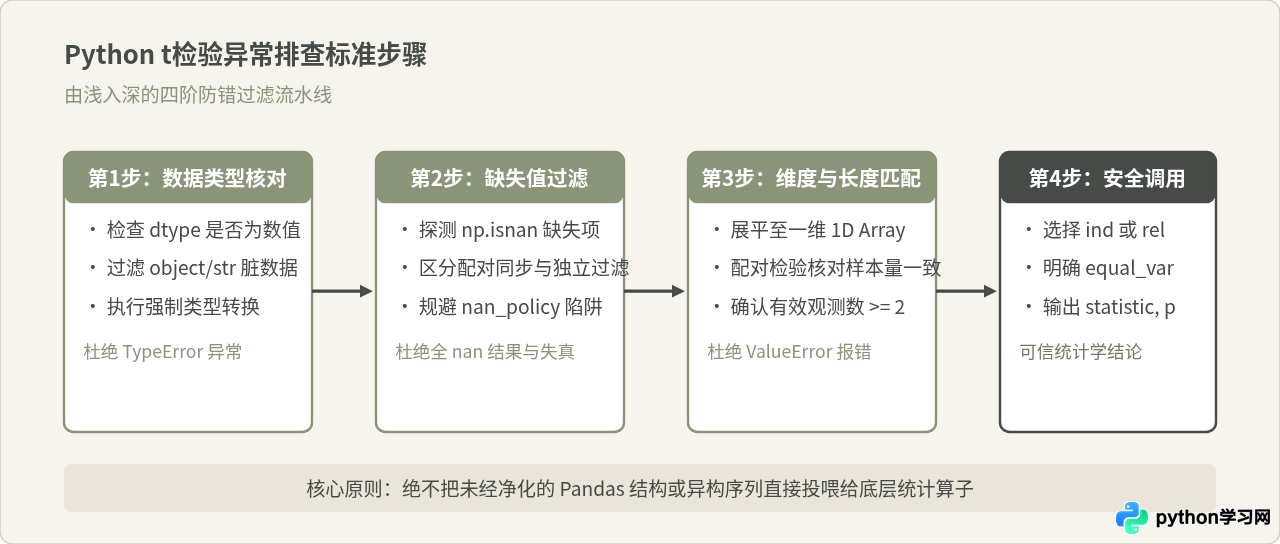
调用 t 检验函数前,应当遵循一个系统化的前置校验流程,而不是在抛出报错后被动打印追踪栈。下图展示了从原始输入对象进入 t 检验函数前必须经历的四阶递进排查步骤:
二、错误一:维度不匹配与样本量混淆
维度不匹配是调用 scipy.stats 最常见的错误之一。它通常表现为控制台抛出 ValueError: all input arrays must have the same shape 或输出的不是标量值而是一个庞大的矩阵结果。产生这一现象的主要原因有两个:数组轴向(Axis/Dimension)理解偏差,以及混淆了“独立样本”与“配对样本”的数学约束。
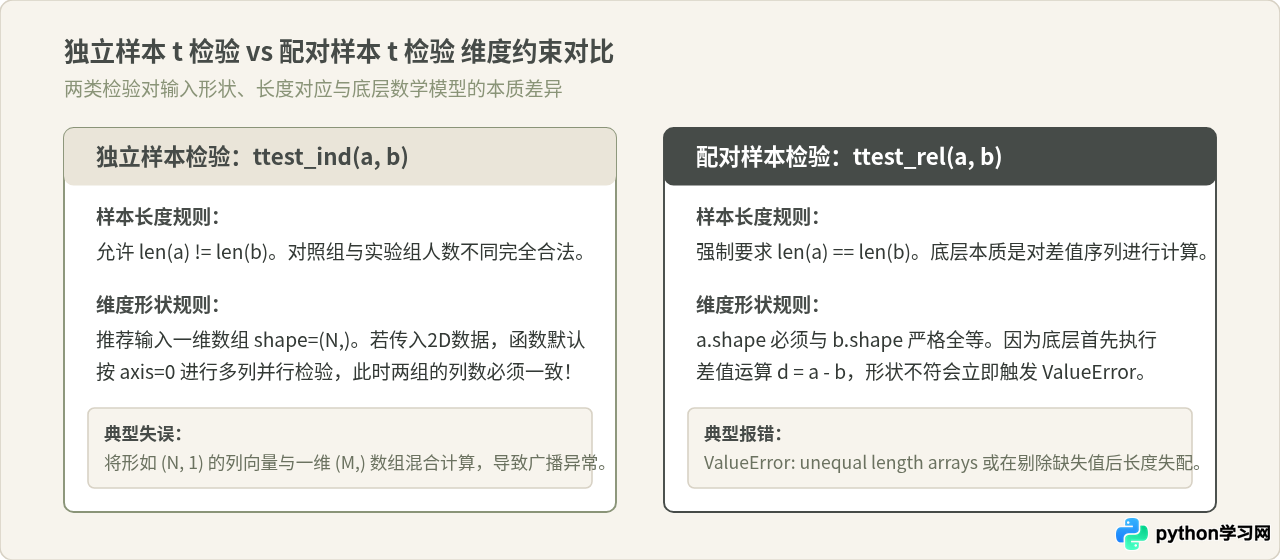
1. 独立样本与配对样本的维度规则对比
许多初学者存在一个认知误区:“进行 t 检验时,两组样本的长度必须完全一样”。这种说法看似合理,但只在配对样本检验(Paired t-test)中成立;在独立双样本检验(Independent t-test)中,两组样本量完全可以不相等。
2. 典型报错复现与排查代码
当直接将 Pandas DataFrame 或未展平的多维 Numpy 数组传给 ttest_ind 时,如果未指定 axis,Scipy 默认会沿着第 0 轴(行)计算,返回每列对应的检验结果;若两个输入的列数不匹配,则会直接报错:
import numpy as np
import pandas as pd
from scipy import stats

# 错误示例:将形状不匹配的二维数据直接传入配对t检验
sample_pre = np.array([12.1, 14.3, 11.8, 15.2, 13.0])
sample_post = np.array([13.5, 14.9, 12.0, 16.1]) # 缺少一个观测值

try:
    # 试图执行配对检验
    res = stats.ttest_rel(sample_pre, sample_post)
except ValueError as e:
    print(f"捕获报错: {e}")
    # 示例输出:捕获报错: unequal length arrays
排查与修复方法:
- 统一展平为 1D 数组:在单次单变量对比中,显式调用
np.asarray(x).ravel()或np.squeeze(),确保x.ndim == 1。 - 核对检验性质:如果是同一批受试者在实验前后的测量值,必须使用
ttest_rel,并确保两列对应行具备一一映射关系;如果是不同的两组独立群体,应改用ttest_ind。
三、错误二:NaN缺失值污染与静默全nan结果
在数据分析中,缺失值(np.nan、pd.NA 或 None)是最隐蔽的“刺客”。与抛出明确错误的维度问题不同,含有 NaN 的数组传给 ttest_ind 时,默认情况下并不会抛出 Exception,而是直接返回 Ttest_indResult(statistic=nan, pvalue=nan)。这会导致调用方在后续提取 p 值进行条件分支判断(如 p < 0.05)时全部被判定为 False,造成极其严重的业务误判。
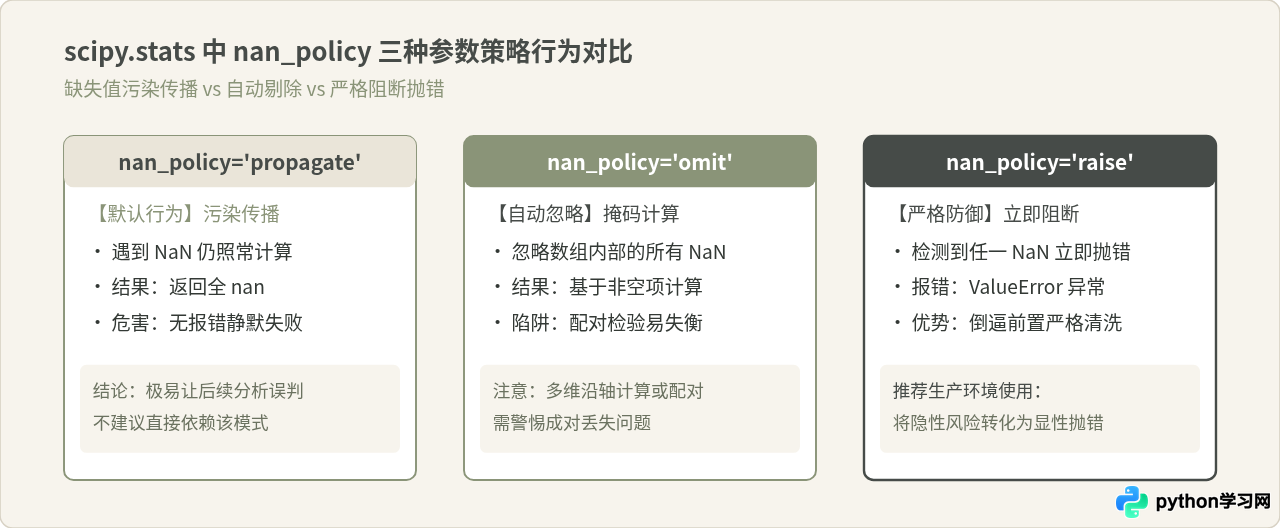
1. Scipy 的 nan_policy 机制解析
scipy.stats 提供了名为 nan_policy 的参数来控制遇到缺失值时的行为。其可选值及其处理逻辑如下:
2. 配对 t 检验中的 NaN 陷阱与解决方案
对于独立双样本检验(ttest_ind),两组数据若分别含有缺失值,可以直接各自删除自己的 NaN:
# 独立双样本:可独立过滤缺失值
group1_clean = group1[~np.isnan(group1)]
group2_clean = group2[~np.isnan(group2)]
res = stats.ttest_ind(group1_clean, group2_clean, equal_var=False)
但在配对 t 检验(ttest_rel)中,绝不能分别单独 dropna()!如果受试者 A 在实验前有数据,但在实验后数据丢失(为 NaN),那么该受试者在实验前的数据也是无效的,必须整行剔除。如果两组各自独立删除缺失值,会导致两列长度不再相同,直接触发 ValueError: unequal length arrays。
正确的做法是构建联合有效掩码(Synchronized Masking):
# 配对样本:必须同步成对剔除缺失值
valid_mask = (~np.isnan(sample_pre)) & (~np.isnan(sample_post))
clean_pre = sample_pre[valid_mask]
clean_post = sample_post[valid_mask]

# 确保成对过滤后依然具备统计学有效样本量(>= 2)
if len(clean_pre) >= 2:
    res = stats.ttest_rel(clean_pre, clean_post)
else:
    raise ValueError("有效成对样本量不足,无法执行 t 检验。")
四、错误三:数据类型错误(TypeError与隐式字符)
scipy.stats 依赖底层的 Numpy C 扩展执行减法、方差与开方运算。如果输入序列包含非浮点数或非整型对象,程序将抛出:
TypeError: unsupported operand type(s) for -: 'str' and 'str'
# 或者
TypeError: ufunc 'subtract' not supported for the input types, and the inputs could not be safely coerced to any supported types according to the casting rule ''safe''
1. 常见诱因分析
- Pandas 的 object 列污染:从 CSV 或数据库中加载数据时,若数字列中混入了
"N/A"、空格字符" "或带有逗号的数字(如"1,250.5"),Pandas 会将整列的数据类型推断为object。即便其余 99% 的元素都是浮点数,底层在做矩阵减法时仍会遭遇字符串对象,从而崩溃。 - 布尔型数据误传:传入了布尔列表
[True, False, True]。虽然 Numpy 允许布尔型进行数值转换,但若与字符混合,会导致不可预料的类型降级。 - None 与 NaN 混用:Python 原生列表中的
None是对象类型,直接转为 Numpy 数组后仍是object数组,无法执行浮点数减法。
2. 规范化排查与类型转换规范
不要使用简单的 arr.astype(float),因为一旦其中存在纯字符串,astype(float) 会直接抛出 ValueError: could not convert string to float。最稳健的做法是利用 Pandas 的 to_numeric 工具:
# 使用 errors='coerce' 将无法解析的字符强制转为 np.nan,再做统一处理
clean_series = pd.to_numeric(raw_series, errors='coerce').dropna()
numeric_array = clean_series.to_numpy(dtype=np.float64)
五、排查总结与端到端健壮代码实现
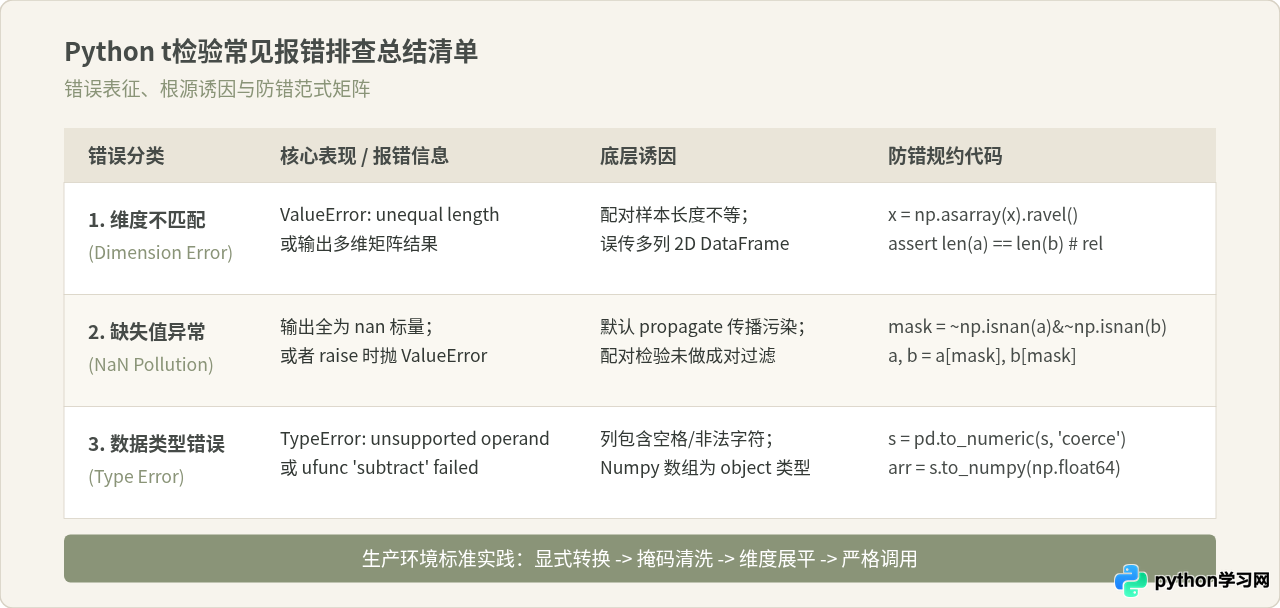
为了帮助读者在生产脚本和科研分析中一劳永逸地解决上述报错,下表对这三类常见问题的表现、根源及防御模式进行了对比总结:
完整且健壮的通用封装函数
下面是一个封装好的通用 t 检验防错调用器,集成了类型强转、维度检查、缺失值对齐以及有效样本量预检,可直接在项目中复用:
import numpy as np
import pandas as pd
from scipy import stats
from typing import Union, Tuple, Optional

def robust_ttest(
    sample_a: Union[list, pd.Series, np.ndarray],
    sample_b: Union[list, pd.Series, np.ndarray],
    paired: bool = False,
    equal_var: bool = False
) -> Tuple[float, float, int]:
    """
    健壮执行独立样本或配对样本 t 检验,全面防范类型、NaN与维度报错。

    参数:
        sample_a: 第一组样本数据
        sample_b: 第二组样本数据
        paired: True 为配对样本检验 (ttest_rel),False 为独立样本检验 (ttest_ind)
        equal_var: 独立样本检验中是否假设方差齐性(默认为 False,使用 Welch t检验)

    返回:
        (t_statistic, p_value, effective_n)
    """
    # 步骤 1:利用 pandas 强转数值,将异常字符串置为 NaN
    s_a = pd.to_numeric(pd.Series(sample_a).squeeze(), errors='coerce')
    s_b = pd.to_numeric(pd.Series(sample_b).squeeze(), errors='coerce')

    # 步骤 2:拉平至一维 Numpy 数组
    arr_a = s_a.to_numpy(dtype=np.float64).ravel()
    arr_b = s_b.to_numpy(dtype=np.float64).ravel()

    # 步骤 3:根据检验类型处理缺失值并校验维度
    if paired:
        # 配对检验必须长度一致
        if len(arr_a) != len(arr_b):
            raise ValueError(f"配对 t 检验要求两组原始样本量一致,当前为: len(a)={len(arr_a)}, len(b)={len(arr_b)}")

        # 同步掩码过滤成对缺失值
        valid_mask = (~np.isnan(arr_a)) & (~np.isnan(arr_b))
        clean_a = arr_a[valid_mask]
        clean_b = arr_b[valid_mask]
        effective_n = len(clean_a)

        if effective_n < 2:
            raise ValueError(f"过滤 NaN 后有效配对样本量不足 (n={effective_n}),无法计算自由度。")

        res = stats.ttest_rel(clean_a, clean_post=clean_b if 'clean_post' in locals() else clean_b)
        return float(res.statistic), float(res.pvalue), effective_n

    else:
        # 独立双样本:分别独立过滤缺失值
        clean_a = arr_a[~np.isnan(arr_a)]
        clean_b = arr_b[~np.isnan(arr_b)]

        if len(clean_a) < 2 or len(clean_b) < 2:
            raise ValueError(f"独立样本检验要求每组有效样本数至少为2,当前: n_a={len(clean_a)}, n_b={len(clean_b)}")

        res = stats.ttest_ind(clean_a, clean_b, equal_var=equal_var, nan_policy='raise')
        return float(res.statistic), float(res.pvalue), len(clean_a) + len(clean_b)


# 验证执行示例
if __name__ == '__main__':
    # 构造带有缺失值、非纯净类型与异构长度的测试数据
    raw_ctrl = ["10.2", "11.5", "invalid_data", "9.8", 12.0, None]
    raw_treat = [12.5, 13.1, 14.0, 11.9, "13.8", 12.7, 14.2]

    # 执行独立样本检验
    stat, p, n = robust_ttest(raw_ctrl, raw_treat, paired=False)
    print(f"独立检验成功完成: t值={stat:.4f}, p值={p:.4f}, 有效样本总数={n}")
通过遵循上述排查标准与清洗规范,开发者可以在调用底层数学算子前将数据形态完全固化,从根源上杜绝由于环境数据脏污导致的维度不匹配、NaN扩散与类型抛错,保证统计分析结果的准确与稳健。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















