


Python嵌套循环的使用方法与注意事项

嵌套循环(Nested Loops)指在一个循环体内包含另一个完整的循环结构。在 Python 中,嵌套循环常用于处理多维列表、笛卡尔积组合、网格坐标扫描以及层次化数据遍历。理解嵌套循环的核心在于把握“时序依赖关系”:外层循环每迈出一步,内层循环就会从头到尾完整执行一整轮。本文将详细讲解 Python 嵌套循环的具体使用方法、关键控制流陷阱,以及在实际开发中必须遵循的性能与跳出规范。
一、嵌套循环的工作机制与基本语法
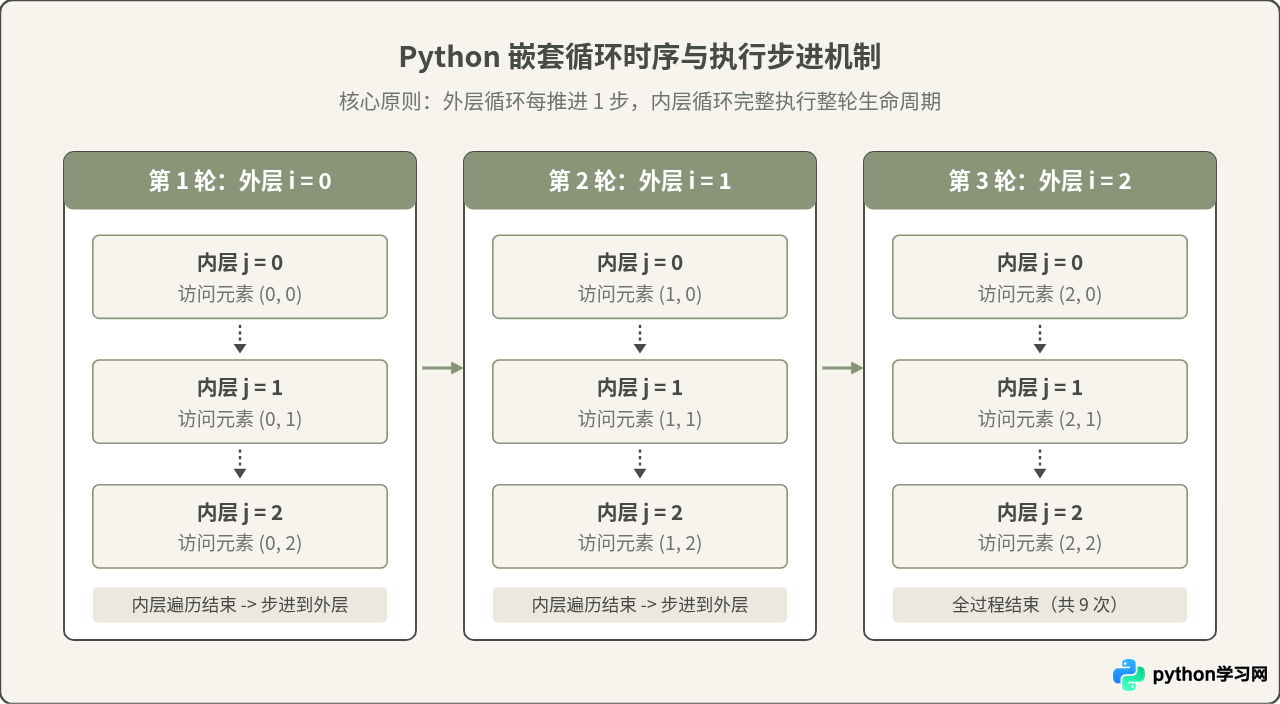
无论是 for 循环还是 while 循环,都可以作为外层或内层相互嵌套。最基础且常见的形式是双层 for 循环,其执行逻辑是严格按序推进的。
# 基础双层 for 循环示例
for i in range(3):
    print(f"--- 外层循环第 {i} 次迭代开始 ---")
    for j in range(2):
        print(f"  内层执行: i={i}, j={j}")
    print(f"--- 外层循环第 {i} 次迭代结束 ---\n")
上述代码运行后,外层 i 分别取值 0、1、2。当 i=0 时,内层 j 依次执行 0 和 1;随后外层进入 i=1,内层重置并再次执行 0 和 1。这意味着循环体内部的操作总次数等于“外层循环次数 × 内层循环次数”。
二、典型使用场景与代码实现
嵌套循环不仅适用于简单的计数器,在实际开发中有三大典型应用场景:二维网格或矩阵遍历、两两配对组合以及分层树状数据展开。
1. 二维列表与表格数据处理
在 Python 中,二维表格通常表示为嵌套列表 list[list]。外层循环负责按行索引(Row),内层循环负责按列索引(Column)。
# 二维网格遍历与条件查找
grid = [
    [10, 25, 30],
    [40, 55, 60],
    [70, 85, 90]
]

for row_idx, row in enumerate(grid):
    for col_idx, value in enumerate(row):
        if value > 50:
            print(f"坐标 ({row_idx}, {col_idx}) 的数值为 {value}")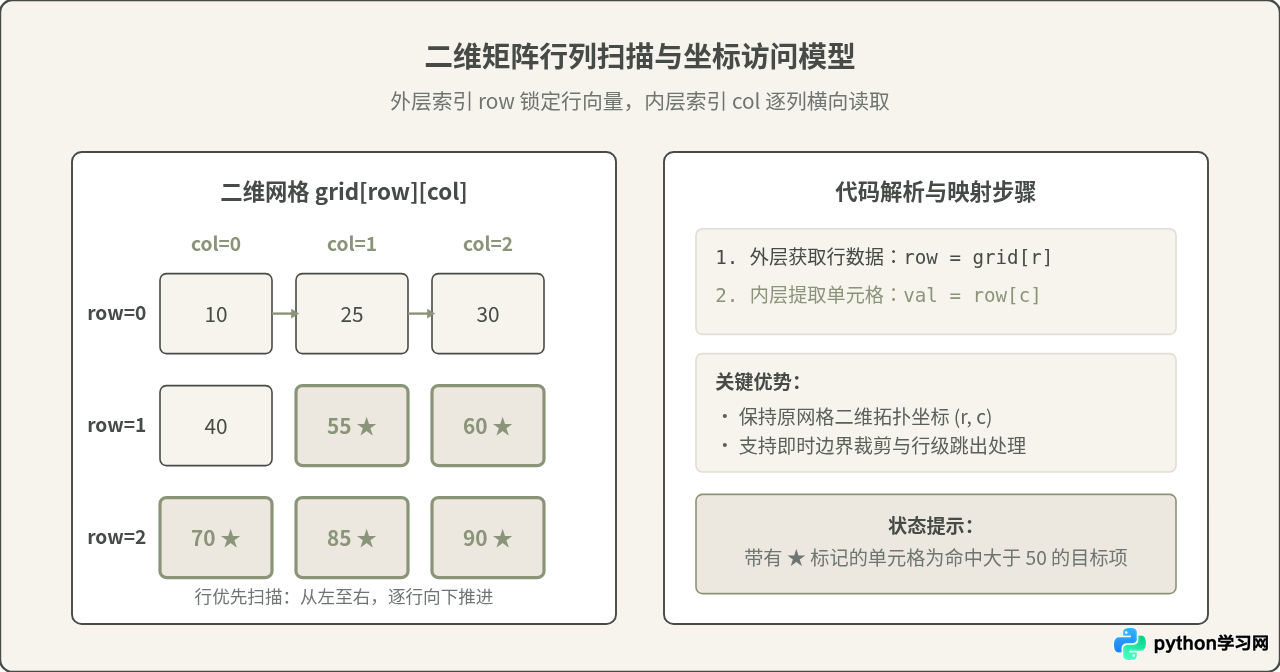
2. 笛卡尔积配对与组合生成
当需要计算两个集合的所有可能组合时,双层循环是最直观的表达方式:
colors = ["红", "蓝"]
sizes = ["S", "M", "L"]

combinations = []
for color in colors:
    for size in sizes:
        combinations.append(f"{color}-{size}")

print(combinations)
# 示例输出:['红-S', '红-M', '红-L', '蓝-S', '蓝-M', '蓝-L']
三、嵌套循环的关键注意事项与控制流陷阱
嵌套循环的代码逻辑虽然直观,但在实际编写过程中极易引发隐蔽的逻辑缺陷。以下是四项最需要警惕的注意事项。
1. 变量名覆盖(Shadowing)引发的死循环或逻辑混乱
在编写多层循环时,部分初学者习惯随手使用 i 作为循环变量。如果外层与内层同时使用同一个变量名,内层循环会直接覆盖外层循环的变量值,导致外层循环的状态被意外篡改。
# 【错误示例】内层覆盖外层变量
for i in range(3):
    for i in range(2):  # 覆盖了外层的 i!
        pass
# 此时外层的 i 已经被篡改成内层最后一次迭代的值 1防错规范:循环变量必须具备明确的语义或层级区分。在简单坐标场景中使用 r, c 或 row, col;在业务循环中使用具体业务名词,如 user 和 order,避免通篇使用无意义的 i, j, k。
2. break 与 continue 的单层作用域限制
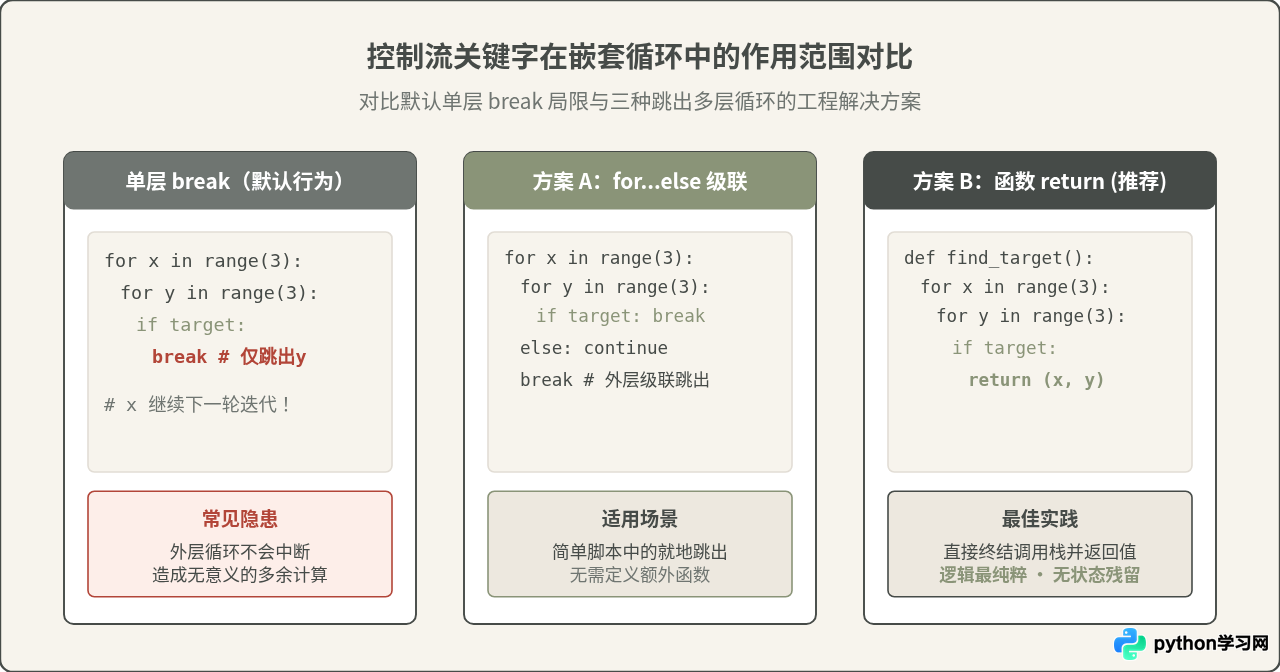
在 Python 中,break 和 continue 关键字仅对包围它的最近一层循环生效,无法直接中断外层循环。
很多开发者在内层找到目标后执行 break,误以为整个双层搜索全部停止,但外层循环依然在继续运行,造成严重的冗余计算甚至逻辑错误。
3. 跳出多层循环的具体实现代码
为了在满足特定条件时彻底跳出多层嵌套循环,工程上推荐以下两种标准解法:
方法一:封装为函数使用 return(最推荐)
def find_first_negative(matrix):
    for r_idx, row in enumerate(matrix):
        for c_idx, val in enumerate(row):
            if val < 0:
                # return 会直接销毁函数上下文,瞬间终结所有内外层循环
                return r_idx, c_idx, val
    return None

result = find_first_negative([[1, 2], [3, -5]])
print(f"找到负数:{result}")
# 示例输出:找到负数:(1, 1, -5)
方法二:使用 for...else 级联结构
Python 中的 for...else 结构具备特殊语义:只有当循环正常执行完毕、未触发 break 时,才会进入 else 块。利用这一特性可以实现多层级联跳出:
target = 55
matrix = [[10, 20], [55, 60]]

for row in matrix:
    for val in row:
        if val == target:
            print(f"命中目标值 {val},开始退出!")
            break
    else:
        # 只有内层没命中(没break)时,外层才执行 continue 继续下一行
        continue
    # 内层 break 后直接落到这里,外层紧接着 break 退出!
    break
四、时间复杂度与性能优化辨析
技术社区中常有“千万不要写嵌套循环,会极大拉低性能”的说法。这一观点在哪些条件下成立?我们又该如何理性看待?
1. 观点辨析:嵌套循环并非洪水猛兽
“嵌套循环很慢”的前提是操作数据量庞大(如达到数万或数百万级别)。如果外层有 10,000 个元素,内层也有 10,000 个元素,则内层操作执行 1 亿次,时间复杂度达到 O(N²),此时纯 Python 的运行耗时会显著上升。
但在数据量较小(例如数十到数百项)或必须处理拓扑网格结构时,嵌套循环是代码可读性最高、最直观的写法,完全没有必要为了盲目“避免循环”而将代码写成晦涩的单行魔法。
| 数据量规模 (N) | 单层循环 O(N) 操作次数 | 双层嵌套 O(N²) 操作次数 | 架构与实现建议 |
|---|---|---|---|
| N ≤ 100 | 100 次 | 10,000 次(毫秒级) | 放心使用嵌套循环,代码清晰度优先 |
| N = 1,000 | 1,000 次 | 1,000,000 次(约几十毫秒) | 可接受,但需避免在内层做磁盘/网络 I/O |
| N ≥ 10,000 | 10,000 次 | 100,000,000 次(显著卡顿) | 禁止暴力嵌套搜索,必须降维优化 |
2. 降维优化:用字典或集合消除暴力查找
最容易产生性能灾难的场景是“在列表 A 中遍历每个元素,并到列表 B 中逐项匹配”:
# 【低效写法】时间复杂度 O(M × N)
users = [{"id": 1, "name": "Alice"}, {"id": 2, "name": "Bob"}]
orders = [{"order_id": 101, "user_id": 1}, {"order_id": 102, "user_id": 2}]

matched = []
for order in orders:
    for user in users:  # 每次都要全表重扫一遍 users
        if user["id"] == order["user_id"]:
            matched.append((order["order_id"], user["name"]))
优化方式是先将内层数据预构建为哈希字典或集合(查询复杂度为 O(1)),从而将总时间复杂度直接降为 O(M + N):
# 【高效优化写法】时间复杂度 O(M + N)
user_map = {user["id"]: user["name"] for user in users}  # O(N) 预构建

matched = []
for order in orders:  # O(M) 单层扫描
    user_name = user_map.get(order["user_id"])
    if user_name:
        matched.append((order["order_id"], user_name))
3. 语法美化:使用 itertools.product 消除深层缩进
如果循环的唯一目的是生成笛卡尔积,且无需在内外部做复杂的独立状态管理,可使用标准库 itertools.product 将嵌套结构“扁平化”:
from itertools import product

ranks = ["A", "K", "Q"]
suits = ["黑桃", "红桃"]

# 传统双层嵌套:两层缩进
# 使用 product:单层循环遍历解构元组
for rank, suit in product(ranks, suits):
    print(f"{suit}{rank}")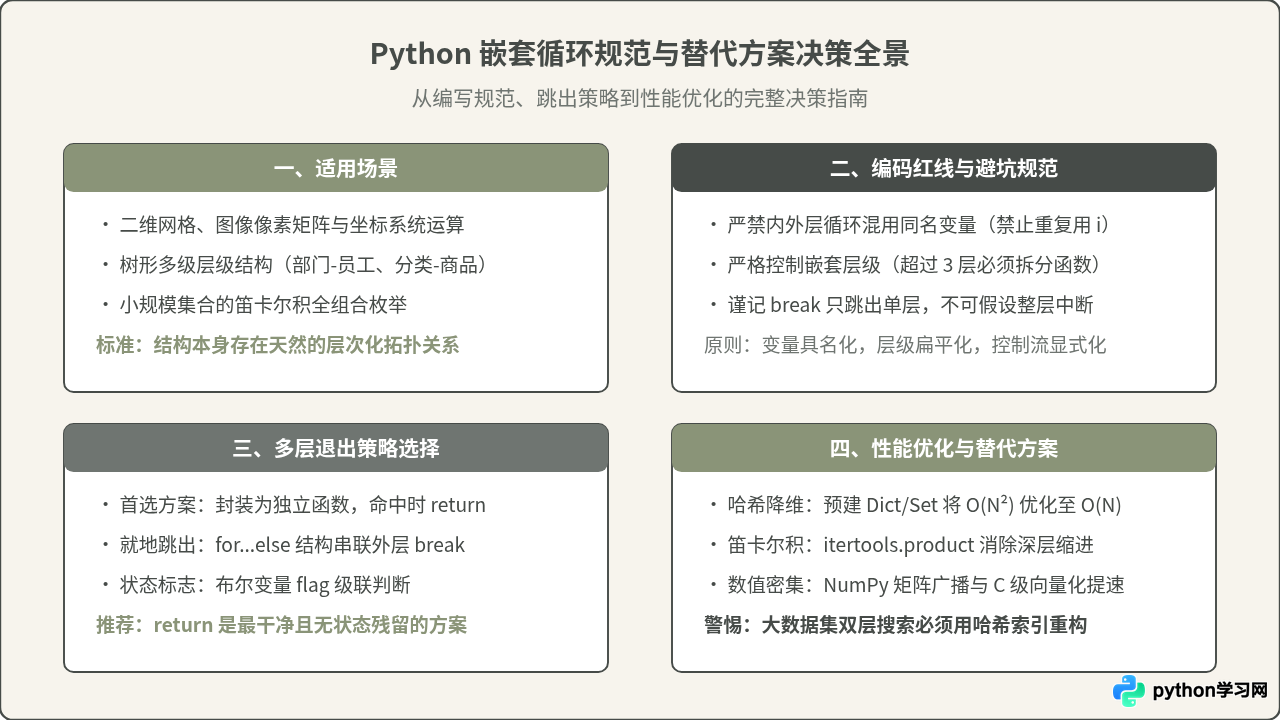
五、核心要点总结
掌握 Python 嵌套循环的使用,关键在于理清逻辑边界与性能权衡:
- 时序推进:牢记外层前进一步、内层执行一整轮的基本节奏。
- 变量独立:各层循环变量必须独立命名,杜绝同名变量遮蔽。
- 退出机制:在需要提前终止多层循环时,优先将其封装为独立函数并使用
return返回,保证控制流清晰明了。 - 避免暴力匹配:遇到大规模列表配对查找时,果断采用字典或集合将时间复杂度由
O(N²)降维至O(N)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















