


Python脚本运行报错怎么办?新手常见SyntaxError与编码问题排查

运行 Python 脚本时终端突然弹出一段刺眼的红色报错信息,往往是新手最容易感到挫败的时刻。面对这串充满英文专业词汇的提示,很多人的第一反应是关掉窗口或重新抄一遍代码。其实,Python 解释器在报错时并不是冷冰冰地拒绝执行,而是以结构化的“回溯信息(Traceback)”向开发者反馈了精确的故障位置与原因。只要掌握科学的排查路径——视线先看最底部锁定错误类别,再倒推行号定位关键符号,绝大多数问题都能在数分钟内排查清楚。而在刚接触 Python 编写脚本的阶段,最常见、最容易混淆排查直觉的,正是尚未启动运行时就拦截执行的语法错误(SyntaxError),以及涉及中文字符展示和文件读写时的字符编码问题(Encoding Errors)。本文将针对这两大高频障碍,拆解底层的触发原因、排查方法与长期防范技巧。
一、学会看懂 Traceback:快速给报错定性
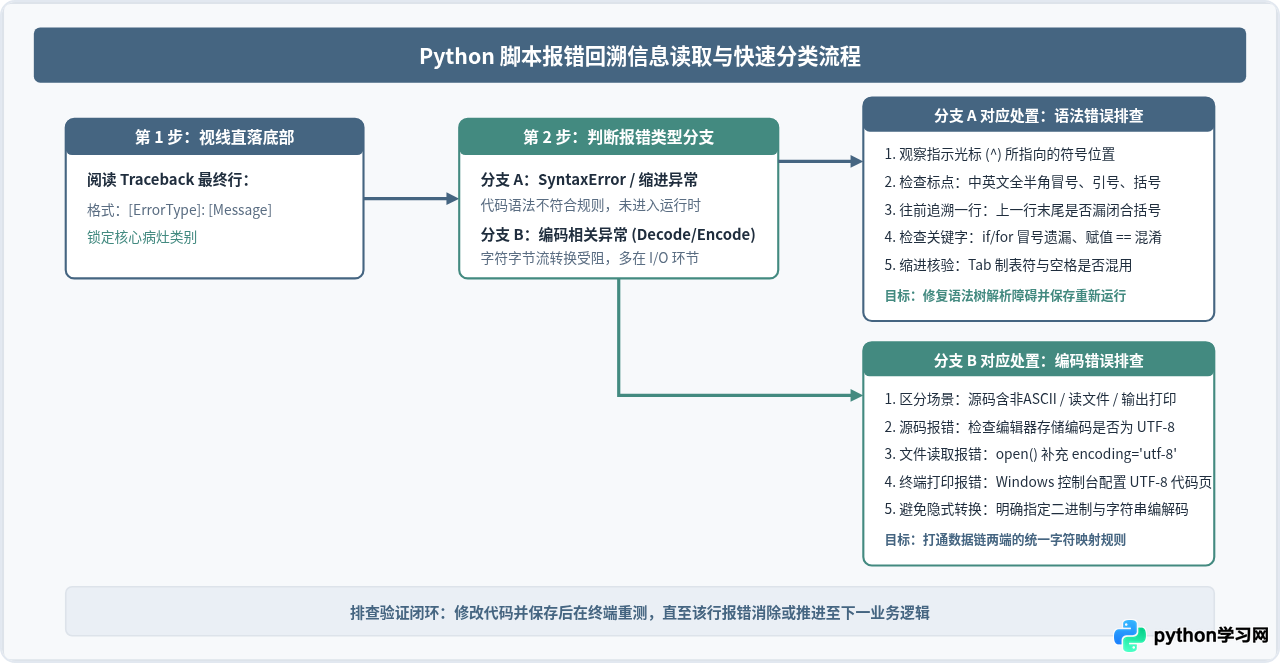
要解决报错,首先必须消除对控制台大段英文提示的畏难情绪。Python 在执行出现异常时打印的信息遵循一套固定的层级逻辑:上方是函数调用栈,记录了从主程序入口到深层调用的执行链路;中间会截取引发异常的具体代码片段,并标明所在文件的绝对路径和行号;而最底部最后一行,则是 Python 给出的核心诊断结论,格式统一为 错误类型: 具体描述信息。
排查核心守则:每次看到红色报错,不要慌张地从第一行逐字阅读。视线直接落到控制台输出的最末尾一行,看清冒号左边的错误类名(例如 SyntaxError 或 UnicodeDecodeError),然后再往上寻找定位行号。这一动作能帮你瞬间过滤 80% 的干扰信息。
区分“语法错误”与“运行时异常”是高效排障的关键。一般的运行时异常(如除以零、找不到键、变量未定义)是在程序执行到该行时才触发并中断;但 SyntaxError 截然不同——它发生在 Python 解释器的“词法分析与语法解析”阶段,也就是代码尚未真正跑起来、仅仅在被读取并构建抽象语法树(AST)时就被拦截了。这意味着,如果脚本存在语法错误,哪怕第一行是 print("程序开始"),它也不会被打印出来,整个脚本完全不会进入执行环节。
二、新手高频 SyntaxError 场景与排查技巧
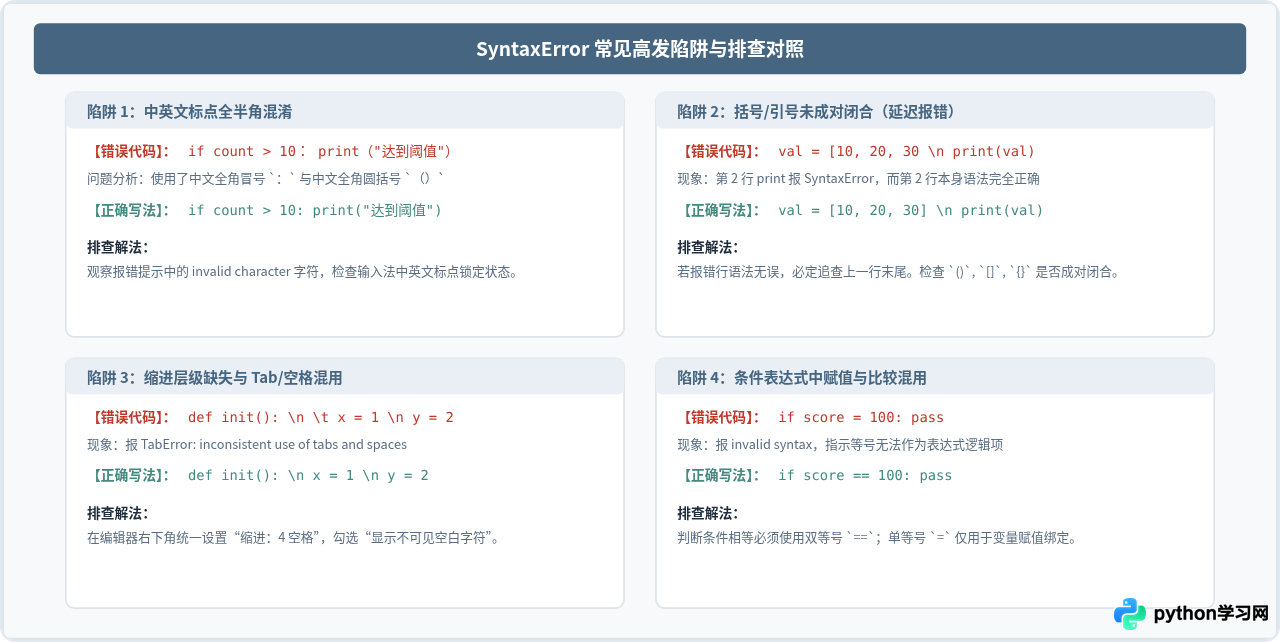
SyntaxError: invalid syntax 是 Python 中最为普遍也是初学者遇到最多的报错。Python 对语法格式的要求极其严密,任何一个多余或缺失的符号、全角半角的混淆,都会导致解释器直接罢工。以下是几种最高发的语法陷阱与针对性解决手段。
1. 中英文全角标点混淆(最隐蔽的“肉眼盲区”)
在中文操作系统下,输入法经常会在中文全角状态与英文半角状态之间无意切换。在 Python 中,除了字符串字面量内部(即双引号或单引号包裹的内容)允许包含中文标点外,所有的代码结构语法标记都必须是英文半角字符。
- 中文冒号
:与英文冒号::在if、for、while、def、class语句末尾输入了中文全角冒号,会直接触发SyntaxError: invalid character ':'。 - 中文括号与逗号:例如
print("hello")或[1, 2, 3],中文全角圆括号或逗号同样属于非法字符。 - 中文双引号或单引号:输入了
“test”代替"test",解释器根本无法将其识别为字符串界定符。
实操技巧:在 VS Code、PyCharm 等现代编辑器中,安装语法高亮插件或在设置中开启“高亮非常规 Unicode 字符”。或者在中文输入法设置中勾选“中文状态下使用英文标点”,从源头上杜绝全角标点混入代码中。
2. 括号、引号未成对闭合(最经典的“延后报错”)
很多新手在遇到报错时,盯着报错信息指出的行号看了半天,无论如何都找不出任何问题,甚至把整行代码删掉重写一遍仍然报错。这是因为:当前行报错,往往是上一行漏掉了右半边括号或引号!
来看一段典型示例:
# 示例代码:第 1 行末尾缺失了闭合括号
total_sum = (100 + 200 + 300
print("计算完成:", total_sum)
当执行上述代码时,控制台输出的报错往往是:
  File "demo.py", line 2
    print("计算完成:", total_sum)
    ^^^^^
SyntaxError: invalid syntax
Python 解释器在读取第 1 行时,遇到了开括号 (,语法解析器认为该表达式还没结束,因此会继续往下读取下一行以寻找对应的闭合括号 )。结果它在第 2 行开头读到了关键字 print,这在语法规则中是绝对不允许出现在未闭合圆括号内部的孤立表达式位置的,因此它只能在第 2 行报出语法错误。排查规则:只要当前报错行语法看似毫无破绽,必须将视线向上移动一行,重点核对行尾的 )、]、} 或字符串引号是否遗漏。
3. 冒号缺失与关键字书写规范
在 Python 语法中,任何开启复合语句块的关键字(如 if condition:、else:、for item in list:、def my_func():)行末都必须带上英文冒号 :。初学者常因手快漏打冒号,解释器会明确在行末换行符处标记 ^ 并报错 SyntaxError: expected ':'。
另一个常见错误是把比较运算符 == 误写为赋值运算符 =。例如写出 if score = 100:,Python 会在等号位置报错 SyntaxError: invalid syntax. Maybe you meant '==' or ':=' instead?。Python 3.10+ 版本已经极具人性化地给出了修正建议,直接根据提示替换为 == 即可。
4. 缩进错误(IndentationError)
IndentationError 是 SyntaxError 的直接子类。Python 放弃了大括号,完全依托缩进层级来表达代码作用域。新手最容易犯的两种缩进毛病是:
- 混用制表符(Tab)与空格(Space):在某些编辑器中,按一次 Tab 键占用 4 个空格的视觉宽度,但在文件底层它存的是
\t字符;另一行手动敲了 4 个空格(存的是0x20)。肉眼看起来两行整整齐齐,但 Python 解释器在对比字节时会判定缩进混乱,抛出TabError: inconsistent use of tabs and spaces in indentation。 - 逻辑块内未缩进:在写了
def foo():之后紧跟着的下一行没有缩进,或者写了if条件之后没有提供任何执行体且没有写pass,会触发IndentationError: expected an indented block。
三、深入理解字符编码:彻底搞懂三大编码报错
除了代码语法规则,另一座横亘在很多新手面前的“大山”就是字符编码问题。许多新手会困惑:为什么在 macOS 或 Linux 上运行好好的代码,拷贝到 Windows 电脑上就疯狂报错?为什么英文脚本一切正常,一旦加了几句中文注释或读写中文 TXT 文件,就弹出整页的 UnicodeDecodeError?
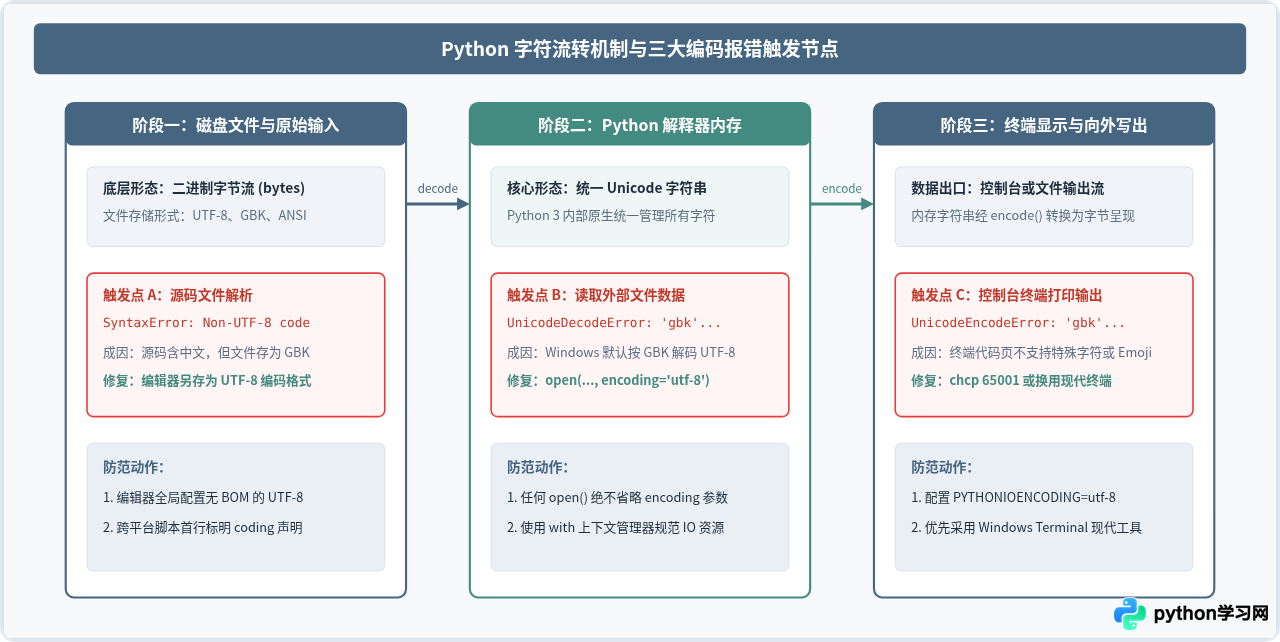
1. 字符与字节的转换关系(核心心法)
在计算机硬件底层,磁盘和内存真正存储的只有二进制序列(字节流 bytes)。我们在屏幕上看到的汉字、字母、标点,在计算机内部被称为抽象字符(Unicode 字符串 str)。
- 编码(encode):将人能看懂的抽象字符串转换成计算机存储的二进制字节流(
str -> bytes)。 - 解码(decode):将磁盘或网络上的二进制字节流按照特定映射表还原为人类可读的文字(
bytes -> str)。
报错的本质只有一个:用 A 规则生成的字节流,试图用不兼容的 B 规则去强行解码;或者当前环境字符集根本不包含该字符,强行编码导致溢出。
2. 常见场景一:SyntaxError: Non-UTF-8 code starting with...
典型表现:脚本顶部刚刚写了一句中文注释,一运行就报错:
SyntaxError: Non-UTF-8 code starting with '\xe4' in file test.py on line 1, but no encoding declared
原因剖析:现代 Python 3 默认规定源码文件必须采用 UTF-8 编码保存。如果在某些老旧编辑器(如 Windows 记事本、部分老版本 IDE)中编写代码并保存成了系统默认的 ANSI/GBK 格式,Python 解释器在读取包含中文字符的源文件时,使用 UTF-8 规则去解析 GBK 字节,就会当场被不合法的字节序列阻断。
彻底解决办法:
- 推荐做法:在代码编辑器(VS Code / PyCharm / Sublime)右下角,将文件保存格式修改为 UTF-8(注意选择 UTF-8 无 BOM 格式)。
- 备选声明:如果因历史环境必须使用特定编码,可以在脚本的首行或次行添加编码魔法注释声明:
声明后,Python 解释器便会使用指定的规则加载该源码文件。# -*- coding: utf-8 -*-
3. 常见场景二:UnicodeDecodeError: 'gbk' codec can't decode byte...
典型表现:使用内置的 open() 函数读取一个文本文件:
# 示例代码:潜藏编码隐患的文件读取
with open("data.txt", "r") as f:
    content = f.read()
在 Windows 环境下运行这段代码时,经常会抛出类似下面的错误:
UnicodeDecodeError: 'gbk' codec can't decode byte 0x80 in position 14: illegal multibyte sequence
原因剖析:调用 open(filename, "r") 时,如果省略了 encoding 参数,Python 会调用系统默认的 locale 编码规则。在简体中文版 Windows 系统中,系统默认编码是 GBK(代码页 936);而在 Linux/macOS 下默认是 UTF-8。如果 data.txt 是以通用的 UTF-8 保存的,Windows 下的 Python 就会拿着 GBK 的字典去解密 UTF-8 的数据,遇到 3 字节表示的中文汉字时必然解析失败!
彻底解决办法:永远不要依赖操作系统的默认配置。在进行任何文本文件读写时,显式声明 encoding='utf-8':
# 标准做法:显式指定编码格式
with open("data.txt", "r", encoding="utf-8") as f:
    content = f.read()
4. 常见场景三:UnicodeEncodeError: 'gbk' codec can't encode character...
典型表现:爬虫抓取网页或者读取文本后,执行 print(text) 准备输出到终端,突然报错:
UnicodeEncodeError: 'gbk' codec can't encode character '\u2022' in position 0: illegal multibyte sequence
原因剖析:该报错发生在向外部设备输出数据的环节。Python 内部已经成功将数据存储为 Unicode 字符串,但在向控制台(CMD 或 PowerShell)打印时,Python 需要将其编码成终端支持的字节流。Windows CMD 默认代码页是 GBK,如果字符串中包含了 GBK 字符集未收录的字符(如生僻汉字、特殊标点圆点 •、特殊表情符号 Emoji),终端就无法呈现,进而抛出编码失败异常。
排查与处置手段:
- 在 Windows 终端中运行
chcp 65001命令,将当前终端代码页临时切换为 UTF-8。 - 在运行脚本前设置环境变量:
set PYTHONIOENCODING=utf-8,强制 Python 控制台标准输入输出使用 UTF-8 编码。 - 在现代终端环境(如 Windows Terminal 或 VS Code 内置终端)中开发,这些终端原生支持全量 UTF-8 字符集渲染。
四、新手报错排查“四步清单”与长效防范策略
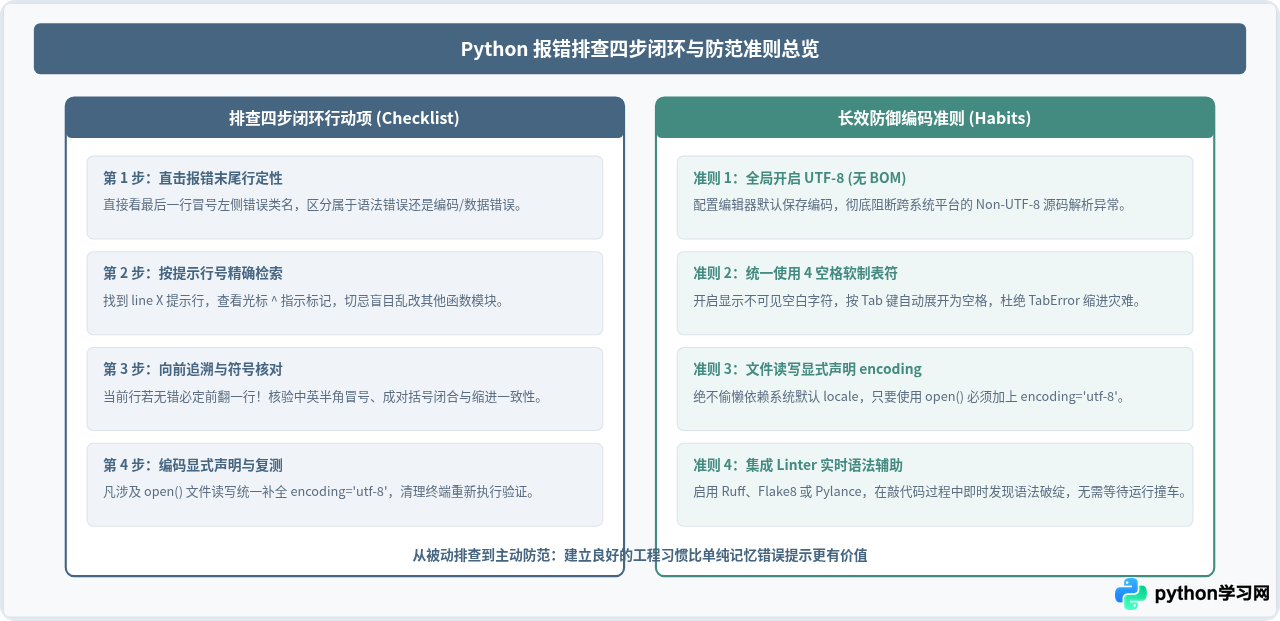
为了让报错排查成为下意识的流畅操作,建议将以下步骤作为每次遇到问题时的固定检查清单。
| 排查步骤 | 核心观察位置 | 排查动作 | 预期效果 |
|---|---|---|---|
| 第 1 步:定性 | Traceback 最终行末尾 | 识别错误名称,区分是语法解析阻断还是运行时编解码异常 | 消除恐惧,圈定问题发生阶段 |
| 第 2 步:定位 | 倒数第二段 line X |
在编辑器中快速跳转到指定行,观察光标 ^ 指向的符号 |
锁定具体的代码物理区域 |
| 第 3 步:回溯 | 当前行及上一行末尾 | 检查是否存在未闭合的括号、引号,检查中英文全半角标点与缩进格式 | 找出真正的语法触发源头 |
| 第 4 步:验证 | 保存后的独立控制台 | 针对编码问题明确补齐 encoding='utf-8',清理终端后重新执行 |
确认该错误完全消除 |
日常防范建议:把错误拦截在保存之前
优秀的开发者并不是因为他们写代码从不出错,而是因为他们善于利用现代开发工具,在代码保存的瞬间就把语法与编码隐患自动消除:
- 弃用简陋文本编辑器:切勿使用系统自带记事本直接编写 Python 代码。建议安装 VS Code 或 PyCharm,它们内置了实时语法解析器,在输入了错误符号(如中文标点或未闭合括号)时,代码下方会立刻出现红色波浪线提示。
- 统一工程编码与缩进:在编辑器全局设置中,将文件默认编码固定为
UTF-8 (without BOM);将 Tab 键默认映射为 4 个空格,并在保存文件时自动去除行尾无效多余空格。 - 使用静态代码检查工具:初学者可以为编辑器安装
flake8或ruff扩展。这些轻量级检查器会在你写完一段代码的数毫秒内对语法树做静态校验,甚至能在运行前直接指出“上一行少了个闭合括号”。
五、结语
编程过程中遇到报错并不代表代码写得糟糕,相反,每一个报错都是解释器给出的精确线索。对于刚刚踏入 Python 大门的新手而言,遇到 SyntaxError 时不要慌张,沉下心来按照“先看末行、再查行号、前溯未闭合符号、辨析全半角”的顺序走一遍;遇到 UnicodeDecodeError 时,立刻意识到这是字节流与字符串字典不匹配的结果,去给 open() 补上 encoding='utf-8'。将这些基础原理转化为肌肉记忆后,面对报错就不再会手足无措,调试代码也会从最初的痛苦阻碍演变为逻辑推理的顺畅过程。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















