


Python遍历字典的三种方法:keys、values与items详解

遍历字典是 Python 数据处理中最常用的日常操作之一。Python 字典提供了三种核心视图方法:keys()、values() 与 items(),分别对应键、值以及键值对元组的提取与迭代。本文将详细讲解这三种方法的底层机制、操作步骤、代码写法与适用边界,帮助开发者写出更清晰、高效的 Python 代码。
一、字典遍历的底层机制与视图对象
在 Python 3 中,调用 d.keys()、d.values() 和 d.items() 并不是像 Python 2 那样返回一个静态的列表副本,而是返回一种被称为字典视图对象(Dictionary View Objects)的动态结构。视图对象具有两大核心特性:
- 动态联动:视图直接绑定到原始字典上。若原字典发生增删改,视图中的数据会实时随之变化,不需要重新调用方法。
- 内存友好:视图不会为所有元素重新分配一个完整的列表内存空间,而是提供惰性迭代能力,即便字典包含数百万条记录,视图本身的内存开销也极小。
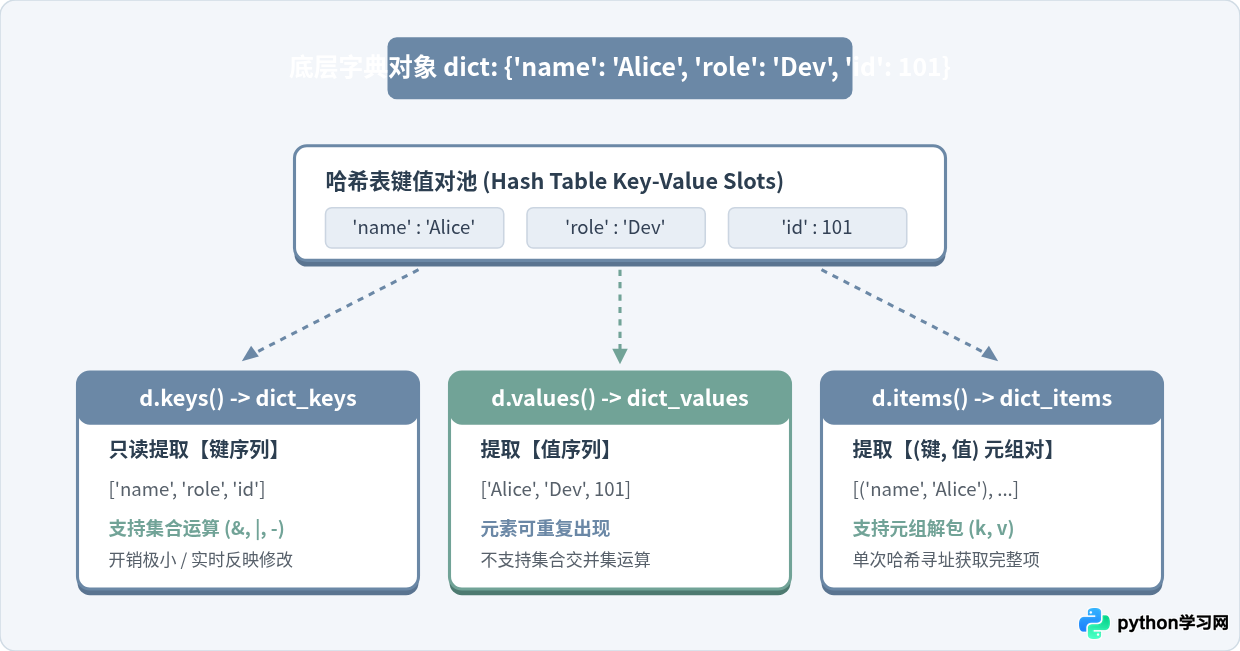
二、方法一:遍历键(keys() 与直接遍历)
当只需要对字典的“属性名”、“索引标识”或“配置项名称”进行检查与处理时,使用键遍历是最直观的方式。
1. 代码写法与运行机制
在 Python 中,遍历字典的键有两种常见写法:
- 写法 A(直接遍历字典):
for key in student_scores: - 写法 B(显式调用 keys()):
for key in student_scores.keys():
这两种写法在执行结果上完全一致。Python 字典实现了可迭代协议(__iter__),直接对字典调用 iter(d) 默认产生的就是键迭代器。因此,官方推荐在绝大多数场景下直接使用 for key in d,代码更加精简地道;而在强调返回集合类型或需要明确表达“仅处理键集合”时,使用 d.keys() 意图更明确。
# 环境要求:Python 3.6+
student_scores = {
    "张明": 88,
    "李华": 92,
    "王芳": 95,
    "赵强": 76
}

# 方式 1:直接遍历字典(推荐日常使用)
print("--- 直接遍历字典键 ---")
for student_name in student_scores:
    print(f"学生姓名: {student_name}")

# 方式 2:显式调用 keys() 视图
print("\n--- 显式调用 keys() ---")
for student_name in student_scores.keys():
    print(f"名单项: {student_name}")

# 示例输出(标准控制台):
# --- 直接遍历字典键 ---
# 学生姓名: 张明
# 学生姓名: 李华
# 学生姓名: 王芳
# 学生姓名: 赵强
#
# --- 显式调用 keys() ---
# 名单项: 张明
# 名单项: 李华
# 名单项: 王芳
# 名单项: 赵强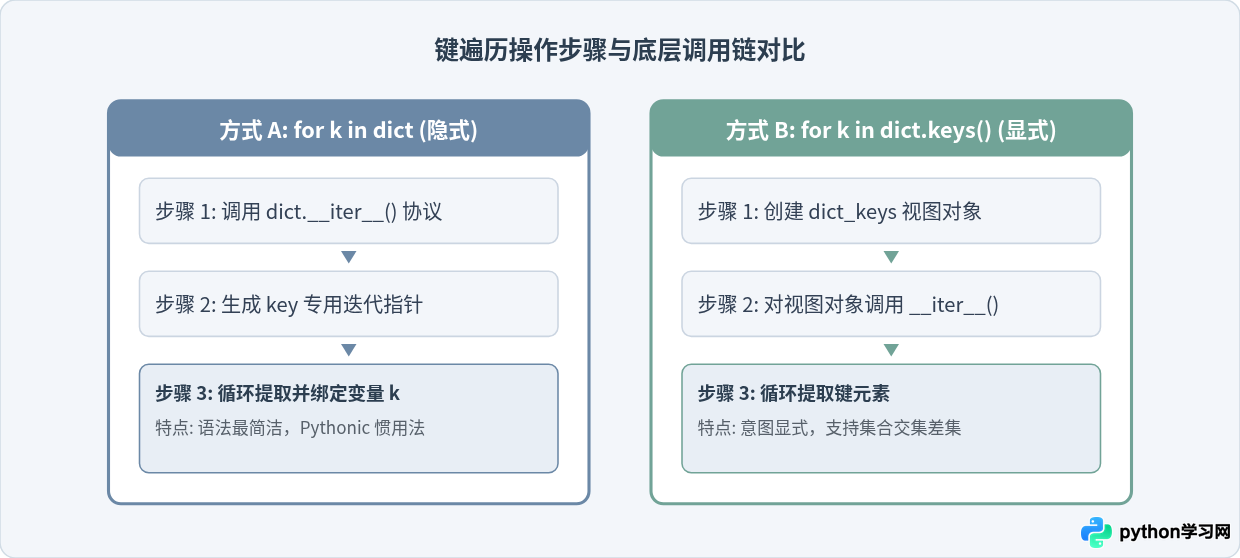
keys() 或字典本身时,严禁在循环体内直接对原字典执行 del、pop() 或新增键值对。因为视图对象实时绑定原字典结构,字典长度的改变会破坏迭代器的状态,并立即触发 RuntimeError: dictionary changed size during iteration。如果确实需要动态删除键,应先将键转换为静态列表:for key in list(d.keys()):。
三、方法二:遍历值(values())
当开发者只关注存储的数据本身,而不需要关心对应的键标签时,使用 values() 是最直接高效的途径。
1. 典型应用场景
- 数值运算与聚合:例如计算总金额、求平均分、统计极值等。
- 状态校验:例如检查系统内所有服务模块的状态是否全部为就绪(
all())或是否存在失败(any())。 - 数据去重收集:通过
set(d.values())快速提取唯一值集合。
# 示例:统计商场购物车商品总金额与折扣状态
cart_items = {
    "机械键盘": 499.00,
    "人体工学椅": 1280.00,
    "无线鼠标": 129.00,
    "显示器挂灯": 189.00
}

# 1. 纯值遍历
total_price = 0.0
print("--- 购物车单品单价明细 ---")
for price in cart_items.values():
    print(f"价格项: ¥{price:.2f}")
    total_price += price

# 2. 结合 Python 内置函数实现高效聚合
avg_price = total_price / len(cart_items)
max_price = max(cart_items.values())
min_price = min(cart_items.values())

print(f"\n消费总额: ¥{total_price:.2f}")
print(f"商品均价: ¥{avg_price:.2f}")
print(f"单品最高价: ¥{max_price:.2f},单品最低价: ¥{min_price:.2f}")

# 示例输出:
# --- 购物车单品单价明细 ---
# 价格项: ¥499.00
# 价格项: ¥1280.00
# 价格项: ¥129.00
# 价格项: ¥189.00
#
# 消费总额: ¥2097.00
# 商品均价: ¥524.25
# 单品最高价: ¥1280.00,单品最低价: ¥129.00values() 返回的值可能包含重复数据,且无法根据遍历出的某个特定 value 快速反向索引到对应的原始 key。若业务逻辑中必须在获取值的同时追溯其所属键,切勿强行通过 values() 循环,而应改用接下来讲解的 items() 方法。
四、方法三:同时遍历键与值(items())
items() 是字典遍历中最全面、最具生产力的方法。它在每次迭代中返回一个形如 (key, value) 的二元组(2-Tuple),结合 Python 的元组解包语法,可以优雅且高效地同时获取键和对应的值。
1. 元组解包(Tuple Unpacking)机制
当执行 for key, val in d.items(): 时,内部经历了两个紧密的步骤:
items()视图产出一个具体的键值对二元组(k, v);- Python 虚拟机自动将该元组的第一个元素赋值给循环变量
key,第二个元素赋值给val。
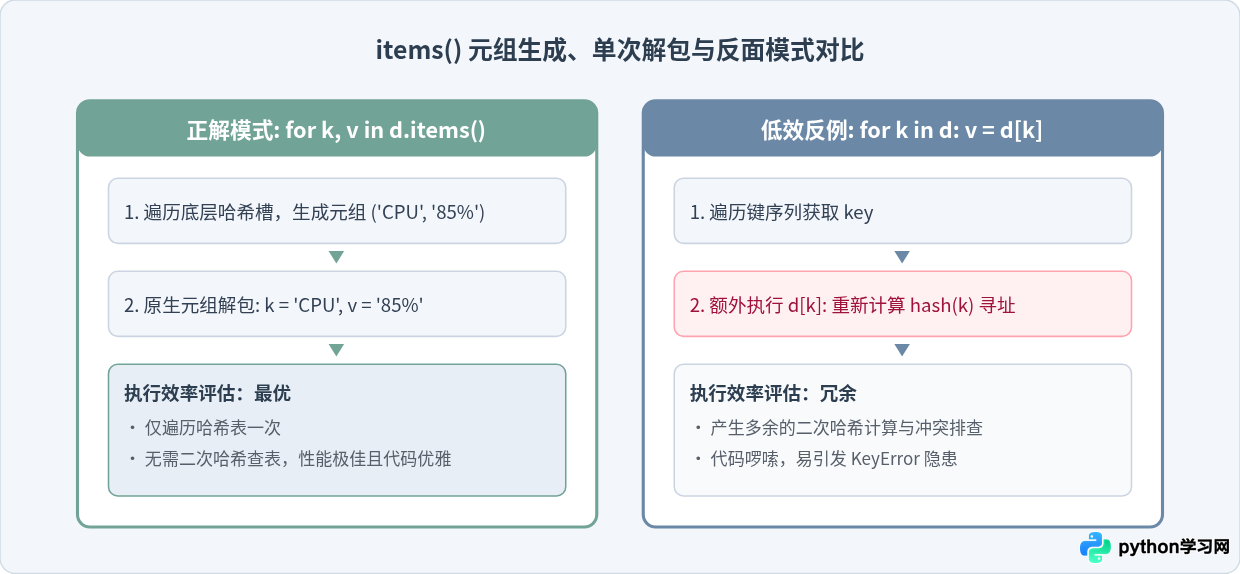
2. 代码示例:信息格式化与字典推导式
# 示例:服务器健康指标监控字典
server_metrics = {
    "cpu_usage": 78.5,
    "memory_usage": 82.1,
    "disk_io": 45.0,
    "network_drop_rate": 0.02
}

# 1. 遍历键值对并格式化展示
print("--- 服务器状态指标检查 ---")
for metric_name, val in server_metrics.items():
    status = "WARN" if val > 80.0 else "OK"
    print(f"[{status}] {metric_name:<18}: {val:>6.2f}%")

# 2. 结合 items() 编写简洁的字典推导式(过滤告警项)
alert_metrics = {k: v for k, v in server_metrics.items() if v > 80.0}
print("\n需立即处理的告警项字典:")
print(alert_metrics)

# 示例输出:
# --- 服务器状态指标检查 ---
# [OK  ] cpu_usage         :  78.50%
# [WARN] memory_usage      :  82.10%
# [OK  ] disk_io           :  45.00%
# [OK  ] network_drop_rate :   0.02%
#
# 需立即处理的告警项字典:
# {'memory_usage': 82.1}
五、三种遍历方法全景对比与选型指南
为了在实际编码中迅速做出合理选型,下表对三种字典遍历方式的返回值类型、典型使用场景及推荐写法进行了归纳:
| 遍历方式 | 返回值 / 视图类型 | 迭代单元内容 | 核心应用场景 | 代码推荐度 |
|---|---|---|---|---|
for k in d |
dict 本身迭代器 |
键(Key) | 键的存在性校验、按键分类、精简脚本 | ★★★★★(日常首选) |
for k in d.keys() |
dict_keys 视图 |
键(Key) | 集合交并运算、明确表意“纯键集合” | ★★★★☆(推荐集合场景) |
for v in d.values() |
dict_values 视图 |
值(Value) | 数据累加、均值计算、状态全量校验 | ★★★★★(纯数值运算必选) |
for k, v in d.items() |
dict_items 视图 |
二元组 (Key, Value) |
格式化展示、数据映射转换、字典过滤推导 | ★★★★★(需键值联动首选) |
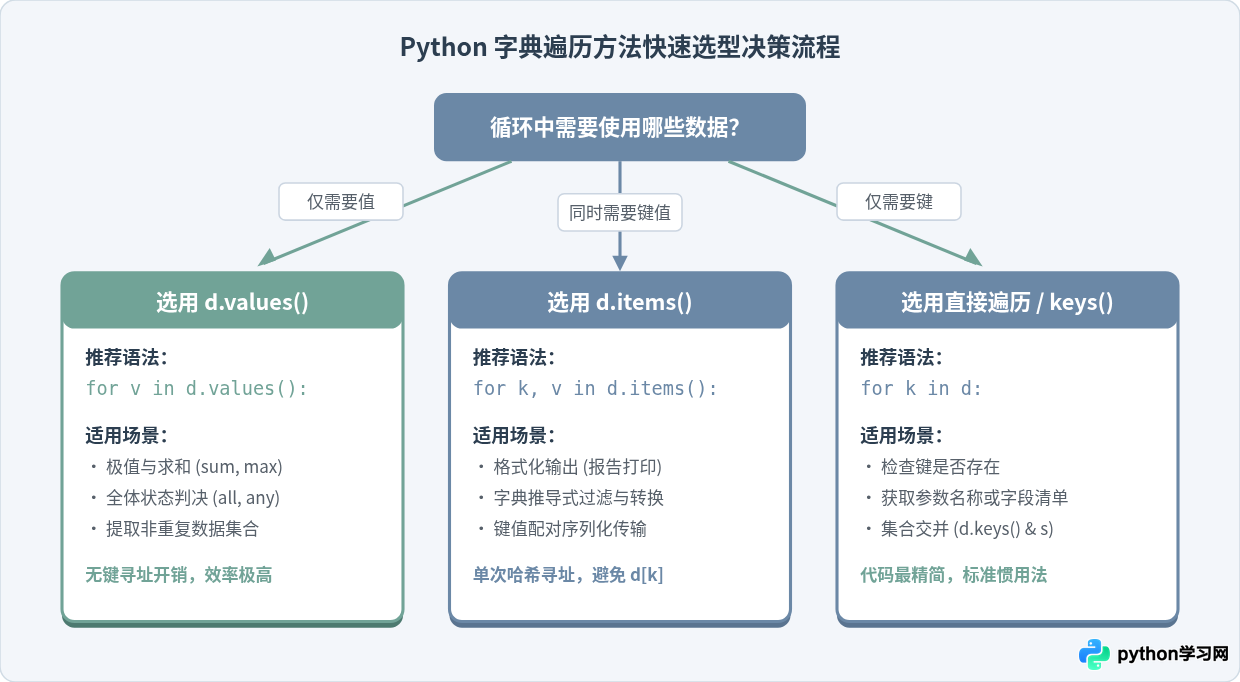
六、核心总结
掌握 Python 字典遍历的核心在于按需选择匹配的视图方法:
- 只关注键名:直接使用
for k in d,简单且符合 Python 社区标准惯用法;当需要集合运算能力时,使用d.keys()。 - 只关注数值:使用
for v in d.values(),避免了多余的键解析,代码表意清晰。 - 键和值同时参与逻辑:始终使用
for k, v in d.items()进行元组解包,彻底告别for k in d: v = d[k]带来的冗余二次哈希查找。
遵循这一原则,不仅能让业务代码逻辑更紧凑清晰,还能在处理大规模数据集时确保运行效率的最优。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















