


Python在机器学习中的地位:TensorFlow与PyTorch生态解析
一、Python在机器学习全栈中的中枢地位与协作原理
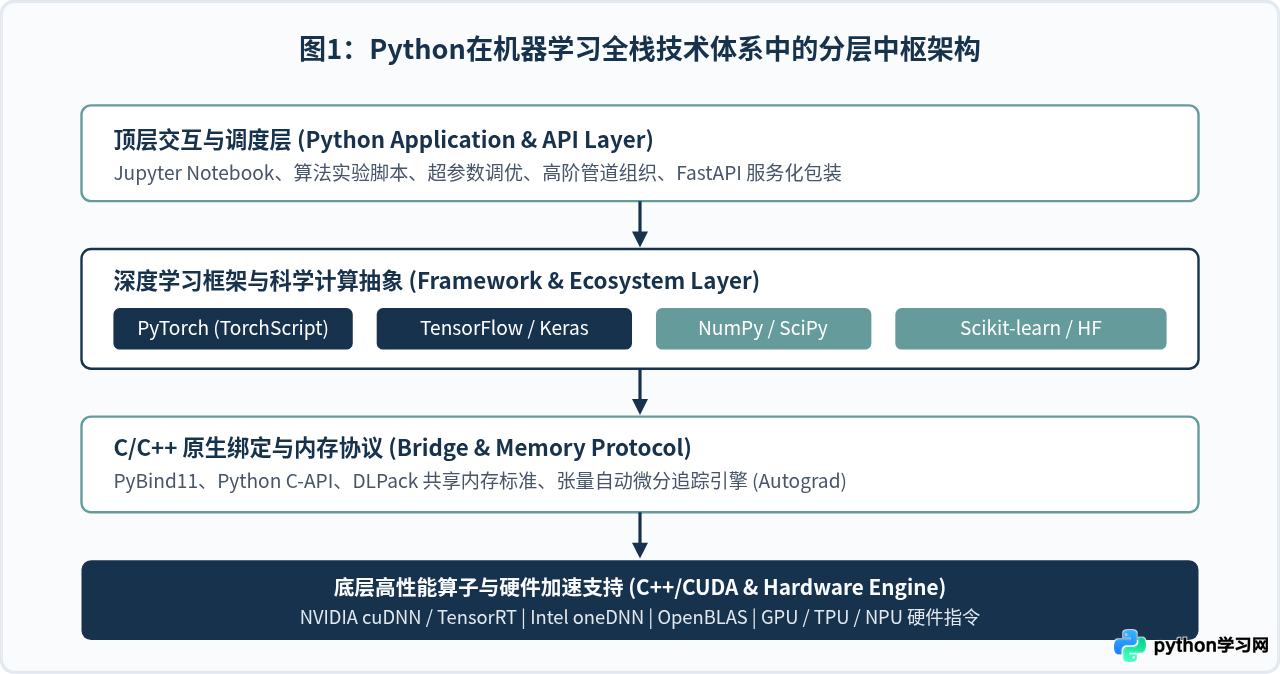
初学者常产生疑问:Python解释器存在全局解释器锁(GIL),且属于动态解释型语言,为何能够主导以算力密集为特征的机器学习领域?答案在于Python的核心定位是“胶水层”与“任务调度器”。实际的模型前向推理、反向求导和梯度更新均发生在编译优化后的C++核心库或CUDA算子中。
Python在此生态中发挥了不可替代的作用,主要体现在三个层面:
- 通用的内存与数组协议:NumPy引入的ndarray连续内存布局与C API规范,使得不同底层库(如BLAS、LAPACK、cuDNN)之间能够零拷贝交换多维数据切片。
- 高效的底层双向互操作:通过PyBind11、Cython以及原生C Extension机制,算法开发者可以用接近自然语言的高阶语法组织复杂数学逻辑,同时享受底层无损的并行加速性能。
- 从数据处理到部署的连续工具链:从Pandas、Scikit-learn的数据预处理,到PyTorch、TensorFlow的模型构建,再到FastAPI、ONNX Runtime的推理服务,整个生命周期均可在同一语言语境下闭环完成。
二、核心机制解析:动态计算图(Eager)与静态计算图(Graph)
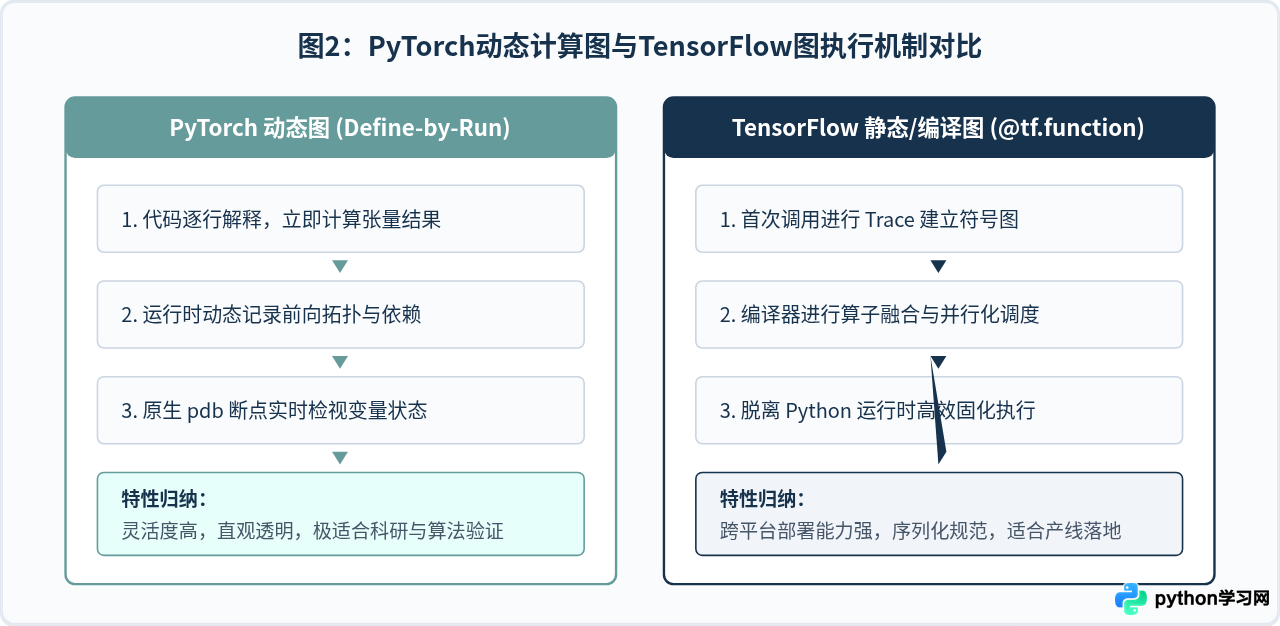
要深刻理解TensorFlow与PyTorch的演化分歧,必须从两者的计算图生成与执行原理切入。在深度学习中,计算图是表达张量(Tensor)运算及自动微分求导的数据结构。
1. PyTorch的动态图哲学(Define-by-Run)
PyTorch采用即时执行机制。当Python解释器运行到某行张量加法或矩阵乘法时,底层立即完成该运算并返回具体数值;同时,Autograd动态跟踪运算并在后台构造求导图拓扑。运算完成后,反向传播执行完毕便释放当前图结构。
优势:与Python原生控制流(if、for、while)完全融合。开发者可以使用标准的Python pdb 或 IDE断点逐行单步调试,直接打印中间张量形状与数值。
2. TensorFlow的静态图与混合执行(Define-and-Run)
早期TensorFlow 1.x强制采用纯静态图模式:先使用符号占位符构建完整图结构,再通过tf.Session()送入C++运行时编译并执行。TensorFlow 2.x默认引入了Eager Execution模式降低学习难度,但在工业生产部署时,仍强烈依赖通过@tf.function装饰器将Python函数转换为优化后的静态计算图(GraphDef)。
优势:静态图由编译器做全局图优化,包括算子融合(Operator Fusion)、死代码消除和显存复用规划,脱离Python解释器后可在C++、Java或移动端轻量级引擎中脱机执行。
3. 核心语法对比:自动微分与前向计算代码实现
以下为在相同线性回归任务下,分别使用PyTorch与TensorFlow完成一次前向求导与参数更新的最小完整代码示例:
PyTorch实现方式:
import torch

# 1. 初始化输入与权重,开启梯度追踪
x = torch.tensor([[2.0]], dtype=torch.float32)
w = torch.tensor([[1.5]], dtype=torch.float32, requires_grad=True)
b = torch.tensor([[0.5]], dtype=torch.float32, requires_grad=True)

# 2. 前向计算
y_pred = torch.matmul(x, w) + b
target = torch.tensor([[5.0]], dtype=torch.float32)
loss = (y_pred - target).pow(2).mean()

# 3. 反向传播求导
loss.backward()

# 4. 打印梯度(直接在原生环境中检视)
print(f"[PyTorch] Loss: {loss.item():.4f}, w.grad: {w.grad.item():.4f}")
TensorFlow 2.x实现方式:
import tensorflow as tf

# 1. 定义变量与输入
x = tf.constant([[2.0]], dtype=tf.float32)
w = tf.Variable([[1.5]], dtype=tf.float32)
b = tf.Variable([[0.5]], dtype=tf.float32)
target = tf.constant([[5.0]], dtype=tf.float32)

# 2. 在梯度带(GradientTape)上下文中记录前向过程
with tf.GradientTape() as tape:
    y_pred = tf.matmul(x, w) + b
    loss = tf.reduce_mean(tf.square(y_pred - target))

# 3. 从梯度带中计算梯度
grads = tape.gradient(loss, [w, b])

# 4. 打印计算结果
print(f"[TensorFlow] Loss: {loss.numpy():.4f}, w.grad: {grads[0].numpy()[0][0]:.4f}")
三、从模型研发到生产部署的五步工程落地流程
工程落地并不是写好训练脚本就结束。将机器学习算法投入生产环境,需要经过标准化的流水线演进。明确各环节的操作步骤,是技术选型的关键前置条件。
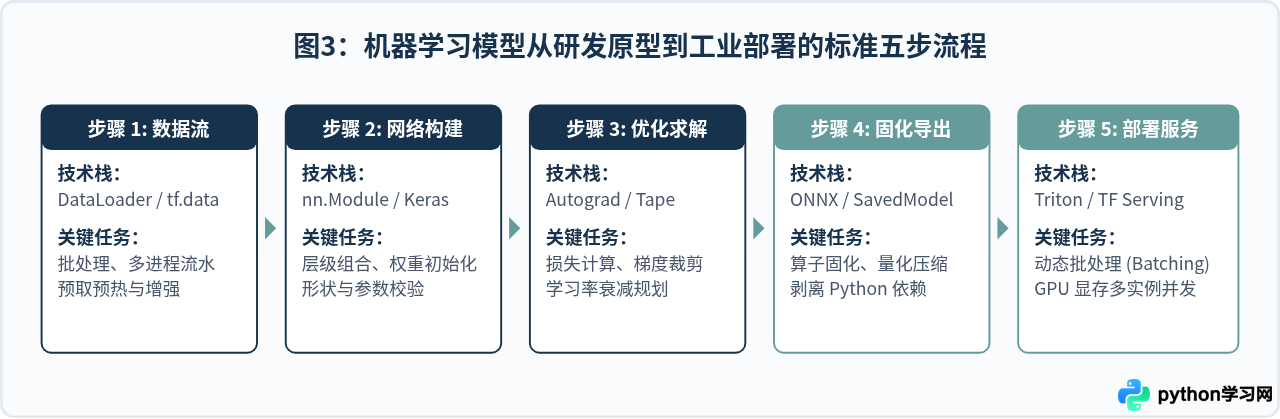
- 数据高效摄取:不要在Python循环中单条读取硬盘图片或文件。PyTorch使用
torch.utils.data.DataLoader(num_workers=4, pin_memory=True),TensorFlow使用tf.data.Dataset.prefetch(buffer_size=tf.data.AUTOTUNE),利用异步C++子进程提前把数据搬运至GPU显存。 - 网络定义封装:继承基础模块类封装前后向计算逻辑,保持网络内部张量维度对齐。
- 训练循环执行:配置优化器(如AdamW)、计算前向损失并更新参数,利用混合精度加速(AMP)减半显存开销。
- 模型序列化剥离:开发完成后,必须将Python动态逻辑固化。PyTorch通过
torch.onnx.export()或TorchScript编译导出为独立模型;TensorFlow则直接保存为包含计算图定义的SavedModel文件夹。 - 专用推理服务托管:线上服务阶段避免使用原生的Python HTTP单进程框架包裹模型推理,推荐使用Triton Inference Server或TensorFlow Serving,由C++后台统一管理显存资源与并发队列。
四、全维度选型对比与决策指南
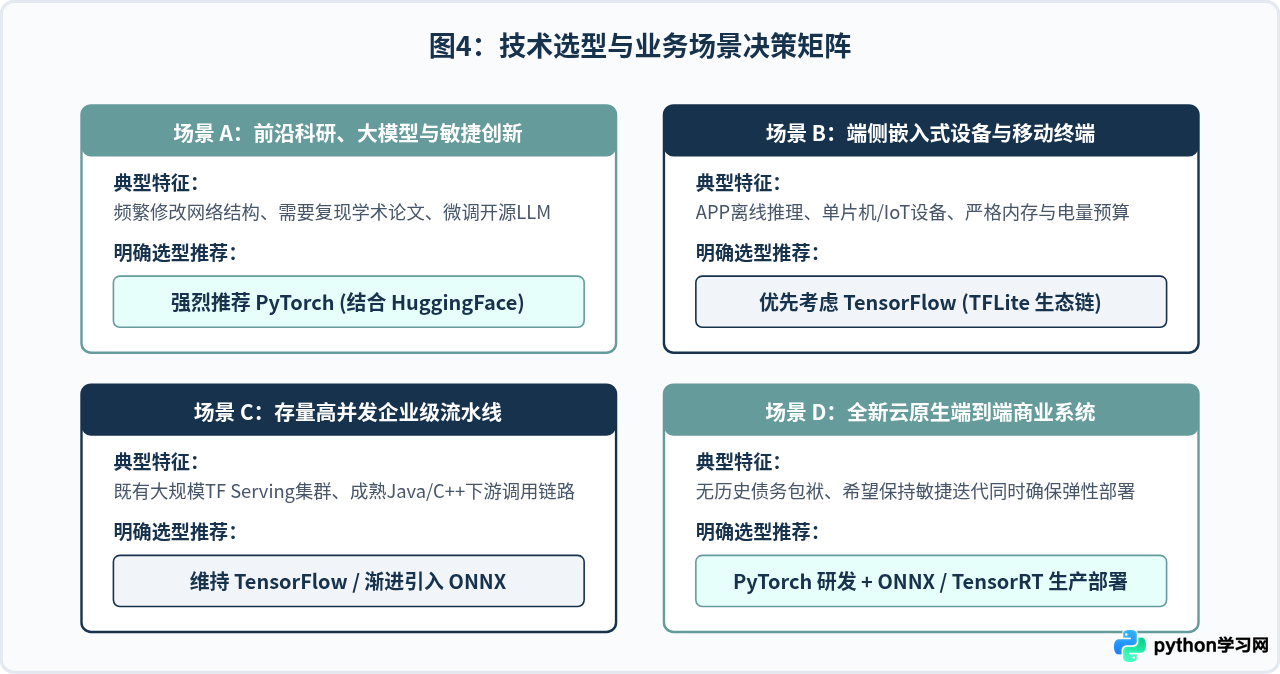
面对具体业务场景,究竟应该选择PyTorch还是TensorFlow?以下对关键维度进行量化与事实梳理:
| 评估维度 | PyTorch 生态 | TensorFlow 生态 | 工程影响与适用分析 |
|---|---|---|---|
| 代码调试与开发门槛 | 极高,语法与Python完全一致,直接用原生print和调试器 |
较高,Keras高阶易用,但深入到图函数或自定义算子时追踪复杂 | 算法原型设计与快速实验期,PyTorch具有压倒性开发效率优势 |
| 前沿科研与开源生态 | 绝对主流,CVPR/NeurIPS绝大部分论文及Hugging Face开源大模型默认使用 | 开源新模型覆盖率逐年收缩,但原有行业基石模型储备仍扎实 | 若业务依赖最新大语言模型(LLM)或扩散模型微调,首选PyTorch |
| 企业服务端部署工具 | 依赖TorchServe、ONNX Runtime或NVIDIA Triton | 官方TensorFlow Serving历史成熟,gRPC与动态批处理高度原生 | 大型互联网高并发广告推荐流水线中,TF历史工程底座深厚 |
| 端侧与边缘设备(Mobile/IoT) | ExecuTorch与PyTorch Mobile处于快速迭代期 | TensorFlow Lite(TFLite)经过多年工业沉淀,端侧转换链非常完备 | Android、iOS移动端离线神经网络落地,TFLite生态依旧极其成熟 |
| 分布式训练扩展 | Torch Distributed(DDP)、FSDP、DeepSpeed、Megatron生态极其活跃 | tf.distribute.Strategy规范严谨,TPU支持极为完善 | 超大规模集群训练在开源社区更青睐PyTorch衍生分布式套件 |
五、开发与上线避坑注意事项
在每个训练批次内部调用
item()、numpy()或在GPU张量与CPU列表之间来回转换,会强制GPU流水线同步等待,引发严重性能瓶颈。聚合度量指标应当在数个Epoch之后或在GPU内部先完成规约。
PyTorch默认采用
NCHW(通道前置)排布,适合GPU的Tensor Core快速卷积;而TensorFlow传统上更习惯NHWC(通道后置)。在通过ONNX转换模型时,务必核验输入张量维度的排列顺序与均值方差归一化参数,避免因隐式转置引入额外推理延迟。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















