


想从事数据分析或Web开发,Python学习重点有什么不同

想从事数据分析或Web开发,初学阶段的Python语法基础高度重合,但一旦跨过基础门槛,两者的学习重心、核心工具链和思维模型就会彻底分流:数据分析以“数据生命周期与业务洞察”为核心,重点在向量化运算、数据清洗、统计分析与可视化;Web开发以“请求生命周期与系统架构”为核心,重点在网络协议、路由状态管理、数据库交互与并发稳定性。明确这两条路径的本质差异,可以避免在漫无目的的语法刷题中浪费时间。
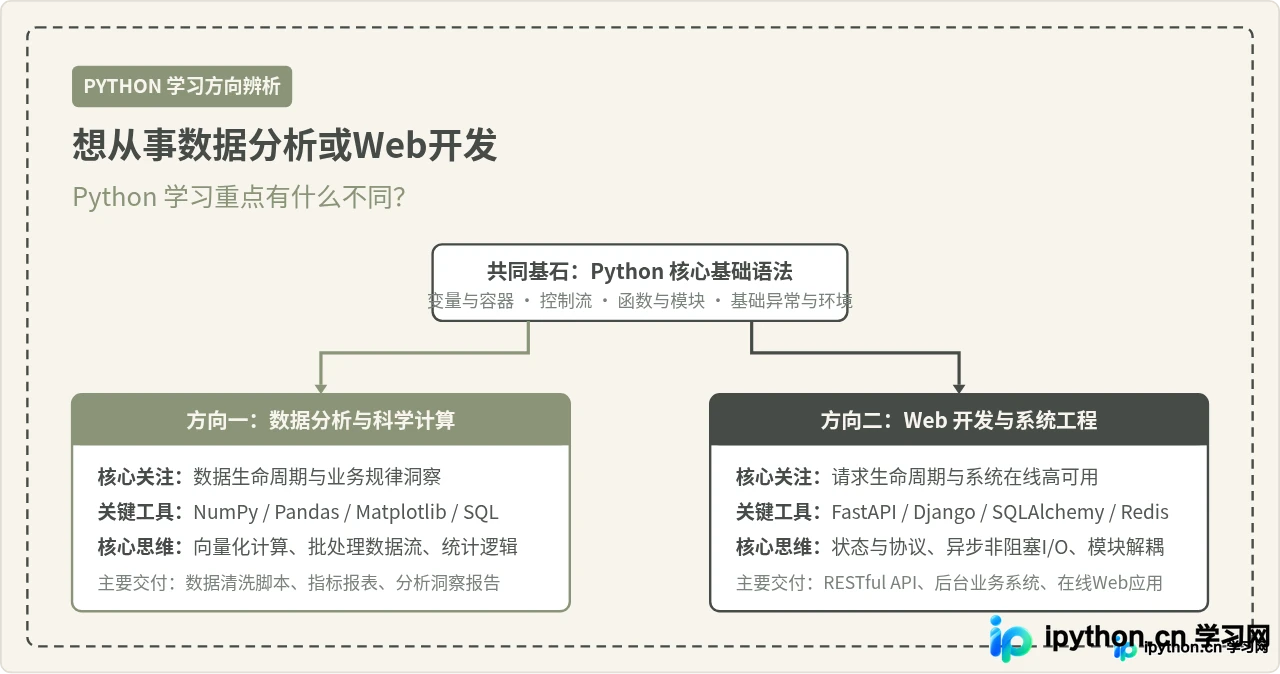
一、公共基础的边界与分流时机
许多初学者容易陷入一种误区,以为必须把 Python 的所有高级语法(如元类、复杂装饰器、多重继承、底层 C 扩展)完全掌握,才能开始选定专业方向。事实上,数据分析和 Web 开发对 Python 语言能力的要求并不是包含关系,而是在一个相对紧凑的公共底座上,向两个截然不同的工程维度展开。
在开始分流之前,两个方向都需要牢固掌握的公共底座仅包括:
- 核心数据结构:整数、浮点数、字符串、列表(list)、字典(dict)、集合(set)与元组(tuple)的常规操作与内存特性。
- 流程控制与抽象:条件判断、循环语句、列表推导式、函数的定义与参数传递机制。
- 模块与工程环境:虚拟环境管理(如 venv 或 uv)、pip 依赖安装、基础异常捕获(try-except)与文件读写。
当能够脱离语法手册独立编写出包含逻辑分支、数据读取与格式化输出的几十行脚本时,就应当果断停止泛泛的基础语法练习,直接切入具体方向的学习。继续停留在通用语法层面,不仅边际收益递减,还会因为缺乏具体的业务目标而丧失驱动力。
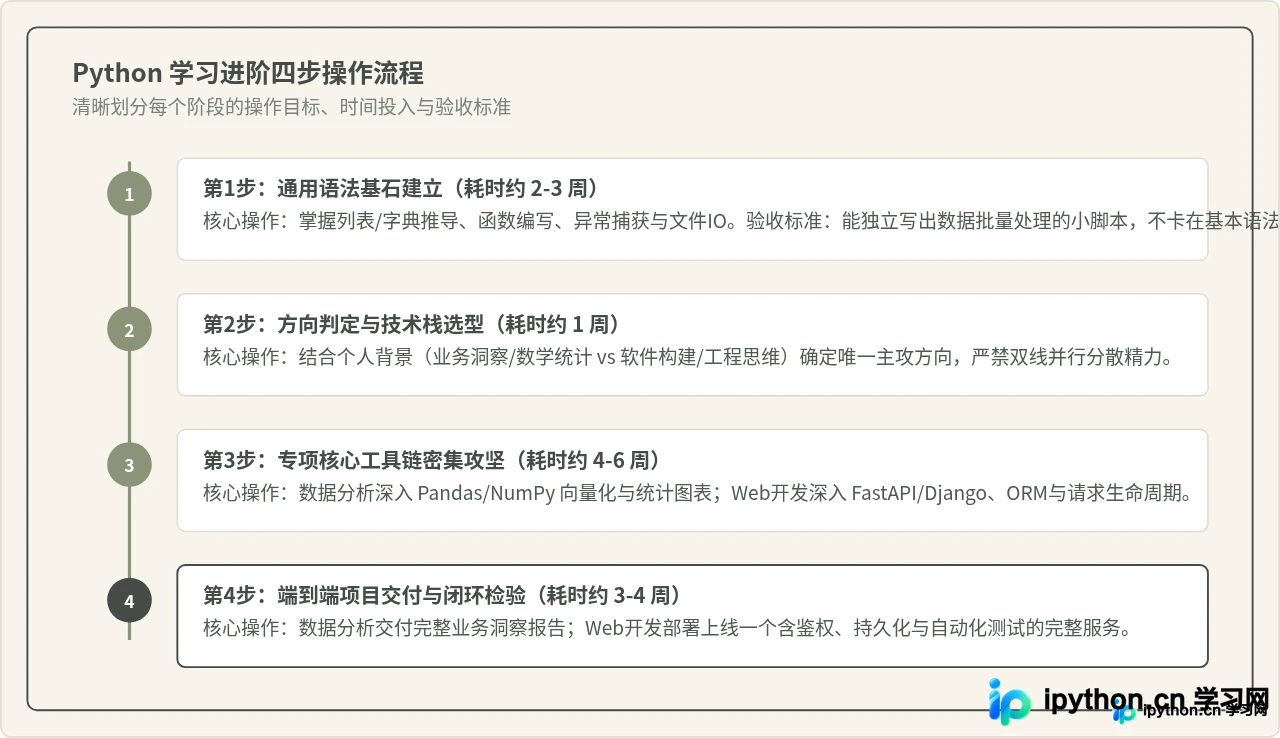
二、数据分析方向的 Python 学习重点
数据分析的核心工作是处理结构化或半结构化的现实数据,从中提取业务规律并为决策提供事实依据。在这一路径下,Python 更多扮演着“高效数据操作与分析胶水”的角色。
1. 核心工具链与能力分层
- NumPy(多维数组与底层计算):理解
ndarray的连续内存结构与广播机制(Broadcasting)。关键不是死记每个线性代数函数,而是理解为什么向量化运算比原生 Python 的for循环快数十倍甚至数百倍。 - Pandas(数据清洗与加工枢纽):数据分析日常耗时最多的工具。必须重点掌握
DataFrame与Series的切片检索(.loc与.iloc)、缺失值与异常值处理、数据类型转换、数据合并(merge、concat)以及核心的分组聚合操作(groupby与透视表pivot_table)。 - SQL 与关系型数据获取:数据很少直接以整齐的 CSV 文件形式存在。结合 Python 使用
sqlite3或数据库驱动执行 SQL 查询,是获取企业内部真实业务数据的前置技能。 - 数据可视化表达:熟练使用
Matplotlib与Seaborn绘制折线图、柱状图、散点图、箱线图与分布直方图。重点在于为业务问题选择正确的图表类型,而非追求花哨的视觉特效。
2. 典型数据处理代码示例
以下示例演示了数据分析中最常见的清洗、过滤与分组聚合操作。环境要求:Python 3.10+,已通过 pip install pandas 安装相关库。
# 文件名:sales_analysis.py
# 执行环境:Python 3.10+,需预先安装 pandas
import pandas as pd

# 1. 模拟原始销售记录数据
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005, 1006],
    "region": ["华东", "华北", "华东", "华南", "华北", "华南"],
    "channel": ["线上", "线下", "线上", "线上", "线下", "线下"],
    "amount": [128.5, 450.0, None, 320.0, 580.0, 210.0],  # 包含缺失值
    "quantity": [2, 5, 1, 3, 6, 2]
}

df = pd.DataFrame(raw_data)

# 2. 数据清洗:填充金额缺失值为该渠道的中位数
df["amount"] = df.groupby("channel")["amount"].transform(
    lambda x: x.fillna(x.median())
)

# 3. 计算单价衍生指标
df["unit_price"] = (df["amount"] / df["quantity"]).round(2)

# 4. 业务统计:按区域和渠道进行多维度销售业绩聚合
summary = df.groupby(["region", "channel"]).agg(
    total_orders=("order_id", "count"),
    total_revenue=("amount", "sum"),
    avg_order_value=("amount", "mean")
).reset_index()

# 5. 输出格式化结果
print("=== 区域与渠道销售业绩分析报告 ===")
print(summary.to_string(index=False))
(示例运行命令:python sales_analysis.py)
终端示例输出结果:
=== 区域与渠道销售业绩分析报告 ===
 region channel  total_orders  total_revenue  avg_order_value
   华东      线上             2          338.5           169.25
   华北      线下             2         1030.0           515.00
   华南      线上             1          320.0           320.00
   华南      线下             1          210.0           210.00
可以看到,数据分析代码通常是以整个表格(DataFrame)为操作单元,通过链式调用或组合变换直接完成大批量记录的计算,几乎不出现显式的游标迭代或对象生命周期管理。
三、Web 开发方向的 Python 学习重点
Web 开发的核心目标是构建能够长期在线运行、稳定响应并发请求并正确持久化业务状态的软件系统。在这一路径下,Python 是整个后端软件架构的承载语言。
1. 核心工具链与能力分层
- HTTP 协议与网络基础:必须清晰理解请求方法(GET、POST、PUT、DELETE)、状态码语义(200、400、401、403、404、500)、请求头、Cookies 与 Session 认证机制,以及 RESTful API 的设计规范。
- 现代 Web 框架:推荐以
FastAPI或Django为核心切入点。如果追求高吞吐量与现代化异步接口,FastAPI 能够帮助深入理解类型注解(Type Hints)与自动模式生成;如果是需要开箱即用的后台管理系统,Django 的一体化组件群能提供完整的工程范式。 - 数据库与 ORM 技术:学习如何通过
SQLAlchemy或Django ORM对关系型数据库(如 PostgreSQL 或 MySQL)进行表结构建模、关联关系查询(一对多、多对多)、事务提交与回滚,以及使用 Alembic 进行数据库版本迁移。 - 异步编程与系统高并发:理解 Python 的
asyncio机制、事件循环(Event Loop)以及协程(coroutine)。明确 I/O 密集型任务与 CPU 密集型任务的区别,掌握 ASGI 服务器(如 Uvicorn)的启动与工作模型。
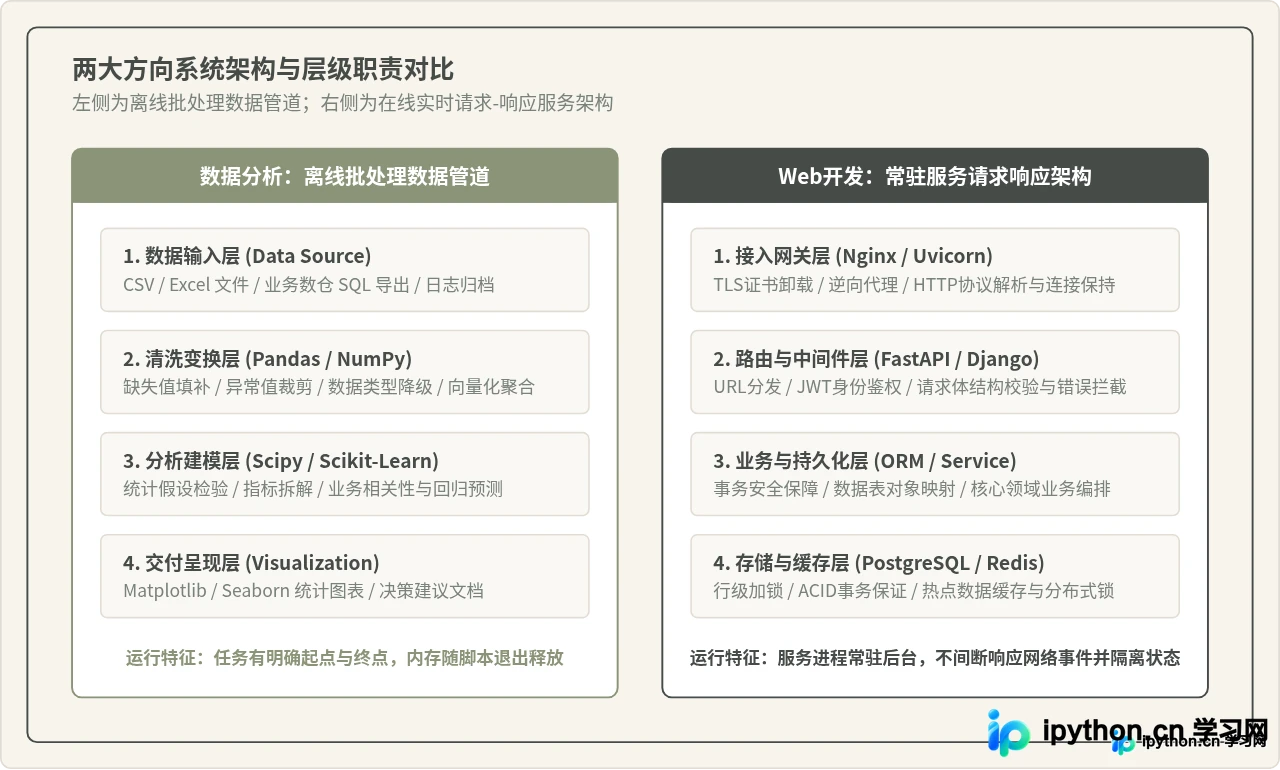
2. 典型 Web 服务接口代码示例
以下示例展示了现代 Web 开发中基于 FastAPI 的典型接口实现。代码包含了数据验证模型(Pydantic)、异步路径操作与结构化响应。环境要求:Python 3.10+,已通过 pip install fastapi uvicorn 安装依赖。
# 文件名:server_api.py
# 执行环境:Python 3.10+,需安装 fastapi 与 uvicorn
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import List, Optional

app = FastAPI(title="用户任务管理接口服务", version="1.0.0")

# 1. 定义入参验证模型
class TaskCreate(BaseModel):
    title: str = Field(..., min_length=2, max_length=50, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")

# 2. 定义出参返回模型
class TaskResponse(BaseModel):
    id: int
    title: str
    priority: int
    is_completed: bool

# 内存模拟持久化数据存储
task_database = []
id_counter = 1

# 3. 异步路由处理:创建任务
@app.post("/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
async def create_task(payload: TaskCreate):
    global id_counter
    new_task = {
        "id": id_counter,
        "title": payload.title,
        "priority": payload.priority,
        "is_completed": False
    }
    task_database.append(new_task)
    id_counter += 1
    return new_task

# 4. 异步路由处理:根据ID获取任务
@app.get("/tasks/{task_id}", response_model=TaskResponse)
async def get_task(task_id: int):
    for task in task_database:
        if task["id"] == task_id:
            return task
    raise HTTPException(status_code=status.HTTP_404_NOT_FOUND, detail="任务不存在")
(服务启动命令:uvicorn server_api:app --host 127.0.0.1 --port 8000 --reload)
通过终端发送 POST 请求示例与响应:
# 示例请求
curl -X POST "http://127.0.0.1:8000/tasks" \
     -H "Content-Type: application/json" \
     -d '{"title": "重构认证模块", "priority": 3}'

# 示例输出
{"id":1,"title":"重构认证模块","priority":3,"is_completed":false}
在 Web 开发中,重点在于协议约定、输入边界防御、状态安全转换以及异常状态的标准化返回。代码执行并非一次性线性结束,而是在长驻进程中随时准备响应外部事件。
四、核心思维模型与运行机制对比
工具链的差异只是表象,驱动这些工具背后的思维模型与底层机制才是决定学习效率的关键所在。如果带着数据分析的习惯去写 Web 服务,容易写出高延迟的阻塞系统;反之,若带着纯面向对象的工程习惯去写数据分析,往往会导致效率低下且代码繁琐。
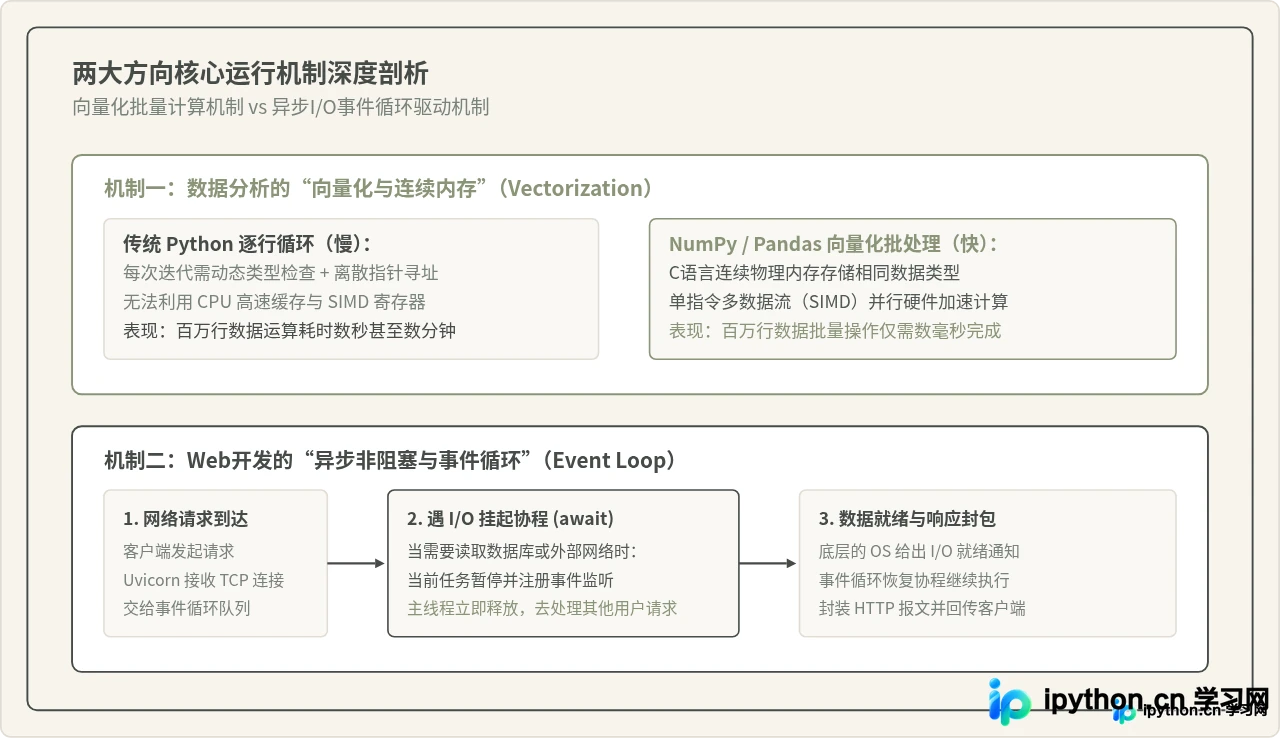
| 对比维度 | 数据分析方向 | Web 开发方向 |
|---|---|---|
| 核心关注对象 | 数据集(表格、矩阵、时序、离散特征) | 系统服务(路由、连接、请求与响应报文) |
| 代码执行生命期 | 批处理作业,按需运行,执行完即退出 | 服务进程常驻后台,7x24 小时保持监听 |
| 性能瓶颈核心 | 内存容量占用、矩阵计算吞吐量、算法时间复杂度 | 网络 I/O 阻塞、并发吞吐量(RPS)、接口延迟(P99) |
| 核心数学与工程需求 | 统计推断、概率论基础、业务指标建模 | 网络协议原理、数据库事务隔离级别、系统安全性 |
| 最终产出形式 | 探索性报告、仪表盘图表、业务决策建议、指标看板 | 生产级 API 接口、在线管理后台、用户交互平台 |
五、常见认知误区的客观辨析
在选择和学习这两个方向的过程中,初学者经常听到一些流行说法。这些说法通常包含部分合理性,但在具体场景下若不加以甄别,很容易造成学习方向的偏差。
辨析一:“做数据分析只要调包背 API,不需要理解数据结构和底层原理”
为什么看似合理:在入门阶段,如果只处理几百行、几千行的示例 CSV 文件,调用 df.dropna() 或 df.groupby() 确实不需要理解任何计算机底层原理,初学者能在几分钟内看到图表成果。
成立的条件:数据规模小(通常在百兆级别以内)、没有严格的执行耗时约束、只需要进行一次性探索分析的场景。
哪里需要修正:当面对数千万行的生产级真实数据时,如果不理解内存布局与数据类型,一个简单的类型未降级(如默认 float64 未转为 float32 或 category)就会直接导致服务器内存溢出(OOM);如果不理解索引哈希查找与逐行遍历的性能鸿沟,一段耗时半小时的脚本往往只需重构为向量化计算就能在数秒内跑完。真正的数据分析不仅要调包,更要懂得在内存受限时如何规避性能陷阱。
辨析二:“做 Web 开发只要套框架模板写 CRUD,没必要深入计算机网络与并发”
为什么看似合理:现代 Web 框架(如 Django、FastAPI)封装程度极高,遵循官方教程复制几行代码,确实能在本地机器上成功启动一个增删改查(CRUD)接口。
成立的条件:个人本地练手、低频内部工具、并发请求接近为 1 的开发演示阶段。
哪里需要修正:一旦服务面向外部真实用户,网络抖动、慢查询、未捕获异常和安全攻击就会接踵而至。如果缺乏对 HTTP 状态流转、连接池耗尽、数据库行锁冲突以及异步事件循环挂起机制的理解,只要遇到一个耗时的外部请求阻塞了主线程,整个服务的所有接口就会瞬间陷入假死。框架能够简化样板代码,但无法替代对网络协议与并发隔离的底层理解。
六、选择依据与技能树总结
面对这两个方向,学习者应该如何依据自身情况做出明确的选择?选择的依据应当建立在自身的思维偏好、学科背景以及目标工作形态之上,而不是盲目追随当下的讨论热度。
选择判定准则:
如果符合以下特征,优先选择数据分析:对商业运营、市场变化、指标驱动增长有天然好奇;具备统计学、数学、经济学、财会或经管类背景;相比于构建庞大的软件系统,更喜欢用数据发现异常规律并影响业务决策。
如果符合以下特征,优先选择 Web 开发:喜欢从零构建具体产品或工具并给他人使用;对计算机网络、操作系统、软件工程架构充满探索欲;享受设计严密的数据结构、优化服务响应速度并维护系统稳定运行。
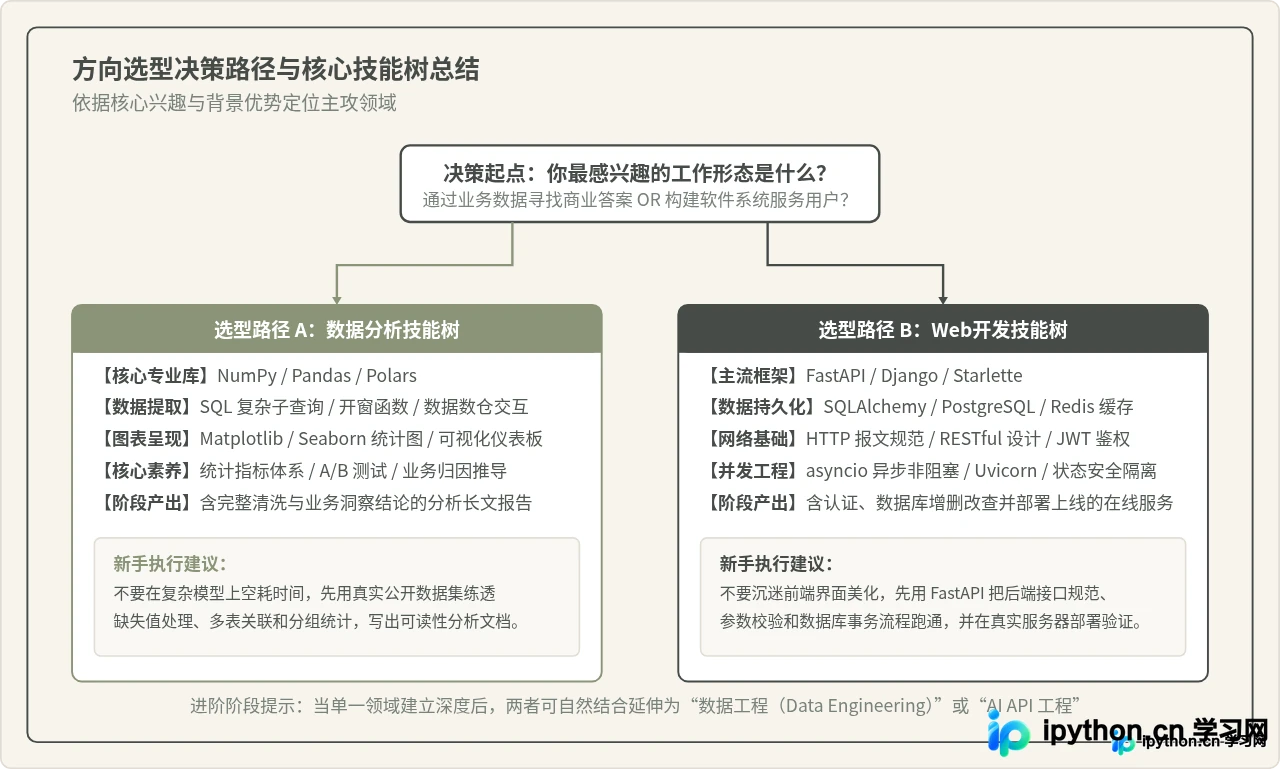
Python 作为一门通用编程语言,其最大优势在于生态的丰富与高度模块化。掌握基础语法只是拿到了通往工程实践的钥匙,而真正决定技能价值的,是选定一条符合自身优势的专业路线并持续深耕。明确数据分析与 Web 开发在数据流向、运行模式以及最终交付上的本质区别,集中精力攻坚对应的核心工具链与思维模型,是跨越初学迷茫阶段最高效的实践路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















