


Python代码输出中文乱码怎么解决?控制台编码UTF-8配置方法
在编写和运行Python程序时,控制台输出中文出现“锟斤拷”、“???”或形如 \xe4\xbd\xa0 的乱码,最根本的原因在于Python输出流的编码格式与终端控制台当前的接收解码格式不一致。通常情况下,Python 3在内部使用Unicode处理字符串,但在向终端写入字节流时,依赖系统标准输出环境;若宿主终端(尤其是Windows命令提示符)默认仍处于GBK或代码页936模式,两者对接就会发生解码失配。解决这一问题的核心路径,就是统一“源代码文件编码”、“Python运行时标准输出编码”和“终端控制台代码页”三者为UTF-8。
一、中文乱码产生的核心机制
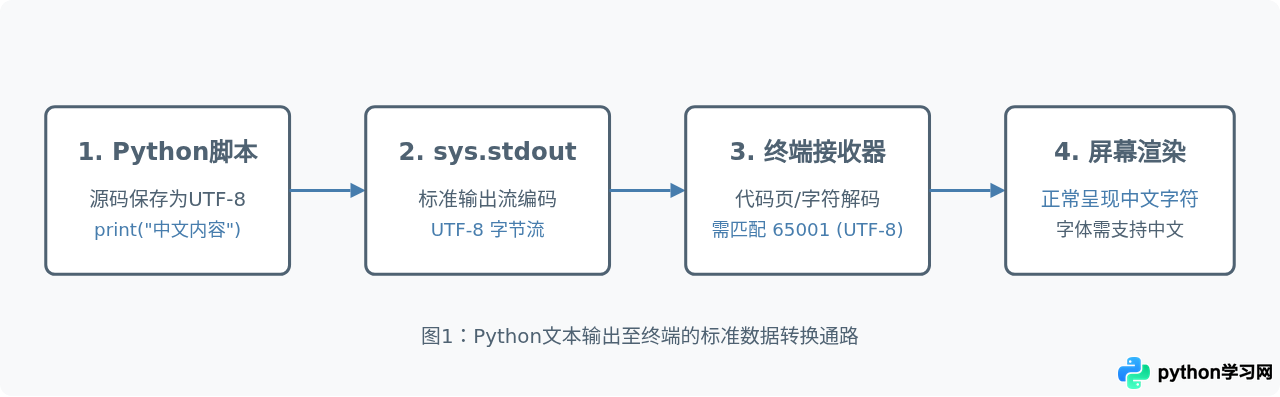
字符从Python脚本最终显示到屏幕上,需要经历“源码读取 → 字符串在内存中表示 → 标准输出流编码为字节 → 终端获取字节并依其代码页解码渲染”四个阶段。只要其中一个环节采用的字符集不同,渲染出的文字就会失真。
常见的具体乱码形态具有明确的指示意义:
- 问号或方框(如
???):终端当前代码页无法识别传入的UTF-8多字节序列,强行截断或替代。 - 锟斤拷 / 烫烫烫:典型的UTF-8与GBK交叉解析错误(例如将UTF-8字节流按GBK两两拼接解析)。
- 十六进制转义符(如
['\xe4\xbd\xa0']):直接打印包含中文字符串的列表、字典等容器时,Python默认调用对象的__repr__而非__str__,这不是控制台故障,而是正常输出格式。
二、配置控制台UTF-8编码的具体操作步骤
在Windows系统下,命令提示符(cmd.exe)默认代码页常为 936(即GBK/ANSI)。按照以下步骤操作,可将运行环境完整迁移至UTF-8模式。
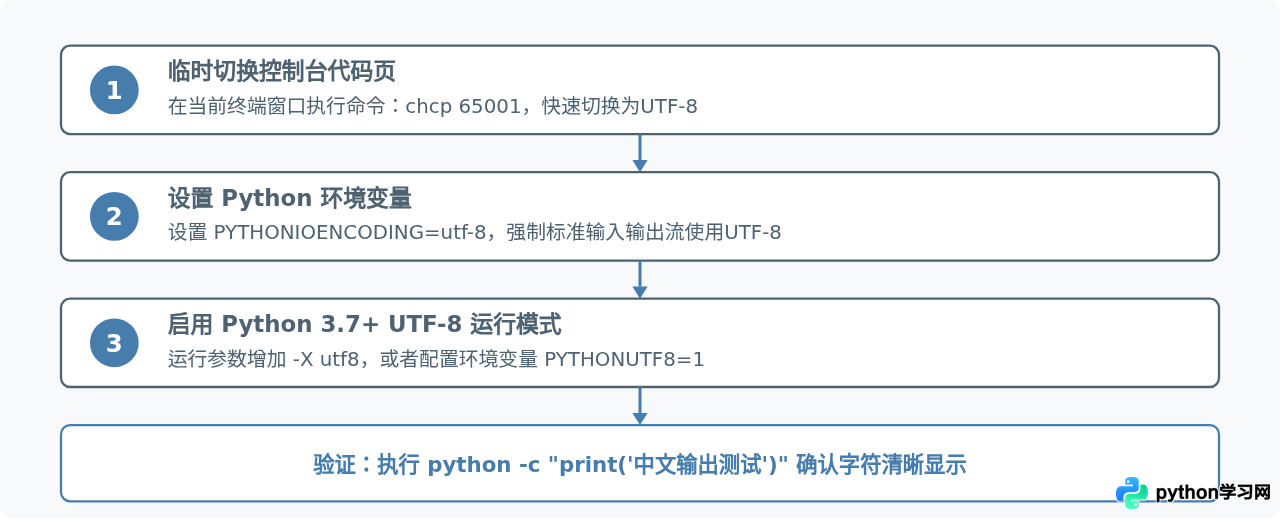
步骤 1:调整终端代码页为 65001
在启动Python程序前,直接在控制台中执行以下命令:
chcp 65001命令执行后终端会提示“Active code page: 65001”,即代表当前窗口已进入UTF-8解析状态。
步骤 2:配置环境变量 PYTHONIOENCODING
为了让Python解释器明确知道向终端管道输出UTF-8字节流,可以设置系统环境变量:
- 临时生效(当前终端):
set PYTHONIOENCODING=utf-8 - 永久生效(系统属性设置):
打开“系统属性” → “高级” → “环境变量”,在“系统变量”区域点击“新建”,变量名填写
PYTHONIOENCODING,变量值填写utf-8,保存后重启终端。
步骤 3:开启 Python UTF-8 Mode(PEP 540)
Python 3.7及更高版本引入了专门的UTF-8模式。开启该模式后,即使系统locale为GBK或C,解释器也会无条件使用UTF-8读写标准流与文件:
# 启动时添加参数
python -X utf8 main.py

# 或者设置全局环境变量
set PYTHONUTF8=1
三、在Python代码层直接重定向标准流
当无法要求所有运行环境均提前配置系统变量时,可以直接在脚本入口处重构 sys.stdout 的文本包装器,确保程序自发输出正确的UTF-8编码:
import sys
import io

# 检查当前标准输出编码,如果不是 utf-8 则重新包装
if sys.stdout.encoding.lower() != 'utf-8':
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
    sys.stderr = io.TextIOWrapper(sys.stderr.buffer, encoding='utf-8', errors='replace')

print("中文输出验证:正常显示!")这种方法的作用机制如下:sys.stdout.buffer 代表标准输出底层的原始二进制写入接口,通过 io.TextIOWrapper 在其上重新叠加一层以 utf-8 规范编解码的文本接口,并在遇到非法字节时采用 replace 平滑降级,从而彻底阻断编码异常崩溃。
四、各运行环境与编码方案对比
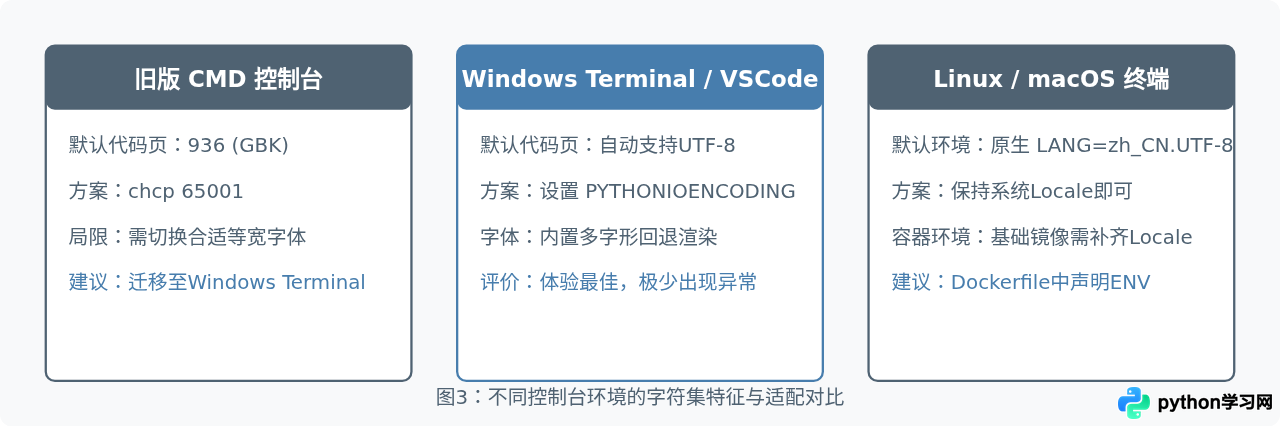
不同的终端容器和开发工具对UTF-8的支持程度存在客观差异,开发者应根据部署平台选用最合适的配置策略:
五、常见问题排查与关键注意事项
在实际操作中,即便配置了UTF-8,部分场景下仍会遇到特殊乱码,可根据以下特征进行定向排查:
1. 控制台字体缺失中文图形
在旧版CMD中执行 chcp 65001 后,窗口如果使用的是光栅字体(Raster Fonts),因字体本身不包含汉字字形,字符依然会显示为空白或方框。右键点击控制台标题栏 → “属性” → “字体”,将字体修改为“新宋体”、“Consolas”或“微软雅黑”,即可恢复正常显示。
2. 打印集合或复杂对象时出现转义序列
当执行以下代码时:
data = ['苹果', '香蕉', '橙子']
print(data)
# 输出: ['\xe8\x8b\xb9\xe6\x9e\x9c', '\xe9\xa6\x99\xe8\x95\x89', '\xe6\xa9\x99\xe5\xad\x90']
这并非控制台编码故障。Python打印列表等对象时,会调用每个元素的 repr() 进行转义。如果需要正常中文,应转换为字符串或使用格式化打印:
# 方案一:通过 join 格式化
print(', '.join(data))

# 方案二:使用 json.dumps 关闭 ASCII 转换
import json
print(json.dumps(data, ensure_ascii=False))
六、解决方案总览与速查
为便于日常开发快速定位,下表汇总了各场景下解决中文乱码的最优措施:
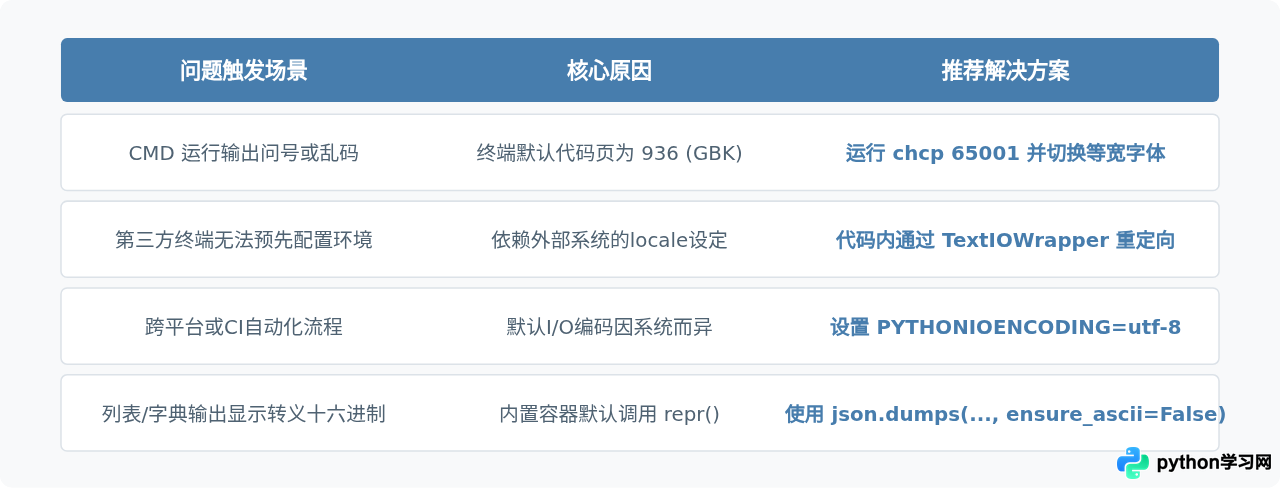
Windows Terminal 搭配 PYTHONIOENCODING=utf-8 环境变量,这能从根源上保障不同工具链之间字符传输的一致性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















