


Python multiprocessing基础教程:Process类创建与管理进程
在处理计算密集型任务时,Python由于全局解释器锁(GIL)的存在,标准多线程无法在多核CPU上达成真正的并行运算。标准库提供的 multiprocessing 模块通过派生独立的操作系统进程避开了GIL限制,其中核心的 Process 类正是管理和调度独立子进程的基础单元。本文将聚焦于 Process 类的核心原理、生命周期方法、参数传递与安全退出控制,提供开箱即用的代码示例与注意事项。
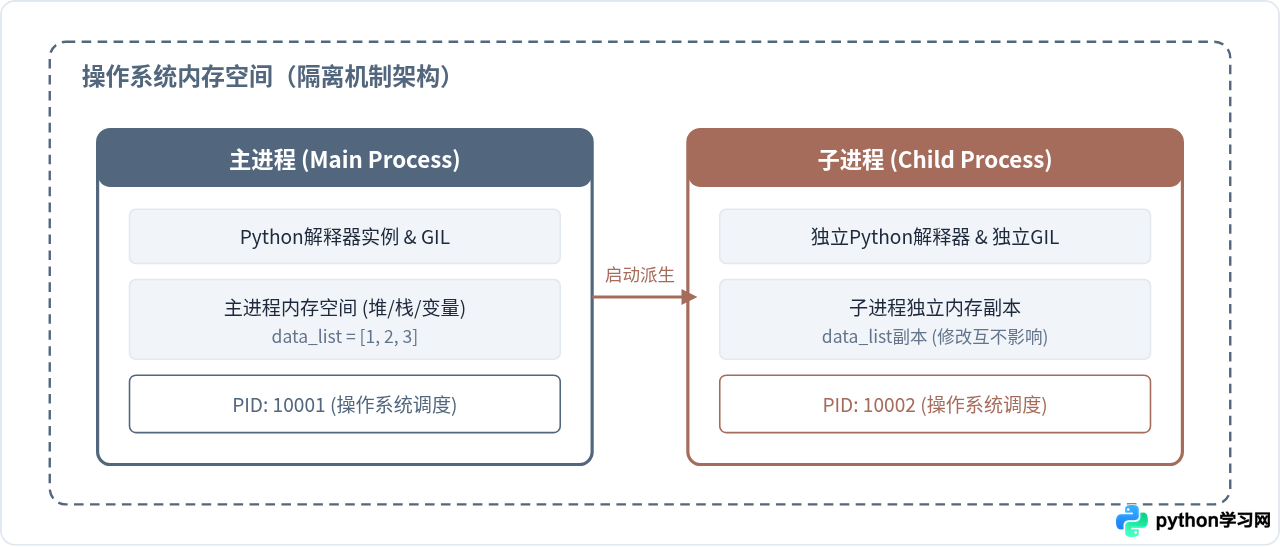
一、进程模型与多进程内存隔离
很多初学者容易将线程与进程混为一谈。在操作系统的视角下,每个进程都拥有完全独立的虚拟地址空间、独立的文件描述符表以及独立的Python解释器实例。这意味着主进程中的全局变量在子进程中是完全隔离的,修改子进程内的变量绝不会影响主进程。
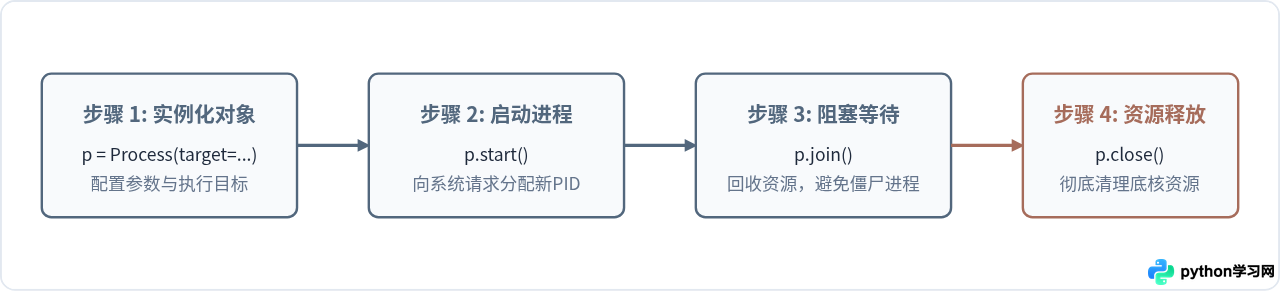
二、创建与启动进程的标准操作步骤
创建子进程通常有两种方式:一是直接实例化 multiprocessing.Process 并传入可调用对象(目标函数);二是继承 Process 类并重写 run() 方法。无论是哪种方式,其生命周期管理的基本步骤是一致的。
1. 函数目标方式创建进程
最直接的方式是将目标任务定义为一个标准函数,通过 Process(target=func, args=(...), kwargs={...}) 进行初始化。请注意,在 Windows 和 macOS 默认使用 spawn 启动模式的平台上,多进程入口代码必须被 if __name__ == '__main__': 守卫保护,否则子进程加载模块时会反复递归导入并抛出 RuntimeError。
import multiprocessing
import os
import time

def task_worker(task_name, duration):
    print(f"[{task_name}] 启动, 进程PID: {os.getpid()}, 父进程PPID: {os.getppid()}")
    time.sleep(duration)
    print(f"[{task_name}] 完成执行")

if __name__ == '__main__':
    # 实例化两个子进程
    p1 = multiprocessing.Process(target=task_worker, args=("数据分析任务", 1))
    p2 = multiprocessing.Process(target=task_worker, kwargs={"task_name": "日志清理任务", "duration": 2})

    p1.start()
    p2.start()

    # join() 会阻塞主进程,直到目标子进程执行完毕
    p1.join()
    p2.join()

print("所有子进程已执行完毕,主进程退出。")2. 自定义类继承 Process
当任务包含较复杂的内部状态维护或需要封装专有业务逻辑时,继承 multiprocessing.Process 是更好的结构化选择。只需重写 run() 方法,并在构造函数中务必调用 super().__init__()。
import multiprocessing
import time

class ComputationWorker(multiprocessing.Process):
    def __init__(self, worker_id, count_to):
        super().__init__()
        self.worker_id = worker_id
        self.count_to = count_to

    def run(self):
        # 实际运行在子进程中的逻辑
        print(f"Worker {self.worker_id} 开始计算...")
        total = sum(i * i for i in range(self.count_to))
        time.sleep(0.5)
        print(f"Worker {self.worker_id} 计算完成: 结果长度={len(str(total))}")

if __name__ == '__main__':
    workers = [ComputationWorker(worker_id=i, count_to=1000000) for i in range(3)]
    for w in workers:
        w.start()
    for w in workers:
        w.join()
三、进程管理核心属性与方法对比
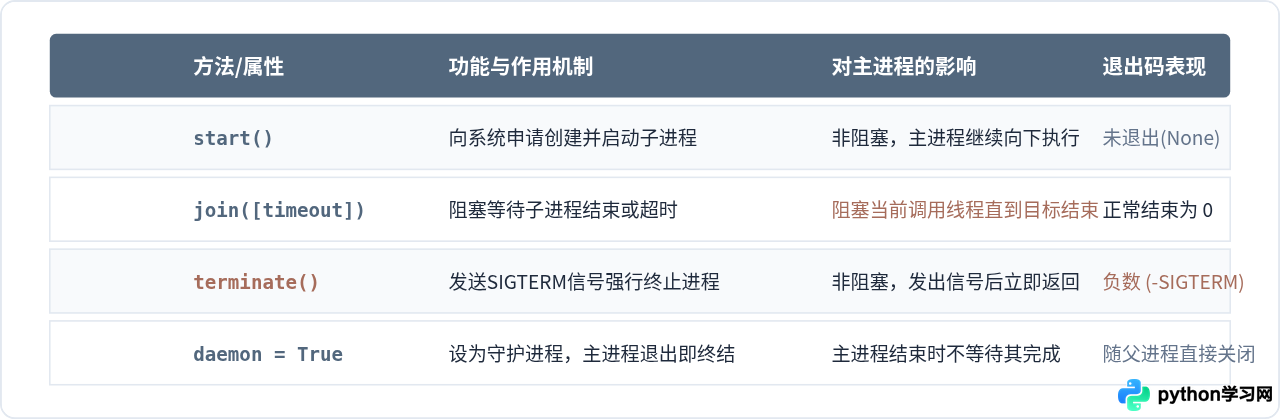
在管理子进程时,控制其生命周期和监测运行状态依赖于一系列专用方法和属性。掌握这些控制指令的差异是构建健壮多进程程序的关键。
守护进程(daemon)机制
当一个子进程的 daemon 属性设置为 True 时,它将成为守护进程。守护进程的唯一使命是服务于主进程。一旦主进程执行完毕准备退出,无论守护进程是否仍在运行,操作系统都会直接将其终止。另外需要注意:守护进程内部禁止再创建新的子进程。
start() 之前设置 p.daemon = True,一旦进程已启动,再尝试修改 daemon 属性将直接抛出 RuntimeError。
import multiprocessing
import time

def background_monitor():
    while True:
        print("[守护进程] 心跳检测中...")
        time.sleep(0.5)

if __name__ == '__main__':
    p = multiprocessing.Process(target=background_monitor)
    p.daemon = True  # 必须在 start() 之前指定
    p.start()

    time.sleep(1.2)
    print("主进程工作完成,准备退出(守护进程将随之直接销毁)")
四、异常退出与 exitcode 状态排查
在生产环境中管理子进程时,了解子进程是否正常完成极为重要。Process.exitcode 属性提供了该状态:
None:表示子进程尚未结束,或从未启动。0:表示子进程正常运行完毕退出,未遇到未捕获异常。> 0:表示子进程在执行期间抛出了未捕获的 Python 异常并退出,数值通常为错误代码(如 1)。< 0:表示子进程被操作系统信号强制中断退出,退出码等于负的信号编号。例如,在 Unix 系统上通过terminate()发送SIGTERM信号时,其exitcode值为-15。
import multiprocessing
import time

def error_task():
    raise ValueError("子进程发生业务计算错误")

def long_task():
    time.sleep(10)

if __name__ == '__main__':
    # 测试异常抛出场景
    p_err = multiprocessing.Process(target=error_task)
    p_err.start()
    p_err.join()
    print(f"异常子进程退出码 (exitcode): {p_err.exitcode}")

    # 测试强制终止场景
    p_term = multiprocessing.Process(target=long_task)
    p_term.start()
    print(f"终止前 is_alive(): {p_term.is_alive()}")
    p_term.terminate()
    p_term.join()  # 必须 join 协助系统回收
    print(f"终止后 is_alive(): {p_term.is_alive()}")
print(f"强制终止退出码 (exitcode): {p_term.exitcode}")五、知识结构与排错决策总结
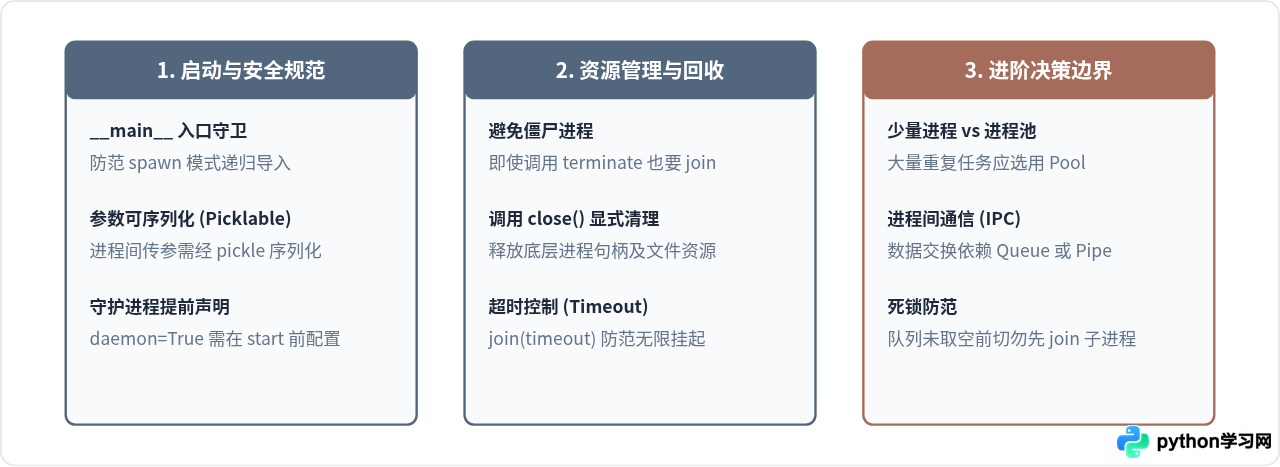
掌握 multiprocessing.Process 是构建高并发系统的前提。在日常使用中,遵循一套清晰的设计与排错检查清单,可以有效规避死锁、资源泄漏和平台兼容性问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















