


解决Python循环中使用with导致的Too many open files错误
很多 Python 开发者在批量处理文件时,都会严格遵循官方推荐的规范使用 with open(...) as f: 语法,并坚信上下文管理器退出时会自动调用 f.close()。然而在面对数万级文件循环、高并发多线程或异步任务时,程序依然频频抛出 OSError: [Errno 24] Too many open files。出现该错误并不是 with 语法本身失效,而是因为瞬时并发导致活跃句柄数突破了系统上限、引用的外部保留导致垃圾回收与底层关闭脱节、动态上下文被错误累积,或是第三方库隐式持有了底层文件描述符。本文将拆解该错误的本质原因,提供从代码作用域、流量管控到系统配额的完整排查与解决路径。
一、为什么使用了 with 依然会耗尽文件描述符?
操作系统为每个正在运行的进程维护着一张有限的文件描述符表(File Descriptor Table,简称 FD 表)。在 Linux 系统中,单个进程默认的文件描述符上限通常为 1024,在 macOS 开发机中甚至默认只有 256。当进程中同时处于打开状态的文件数量超过该上限时,任何进一步的文件打开调用都会被内核直接拒绝,抛出 [Errno 24] Too many open files。
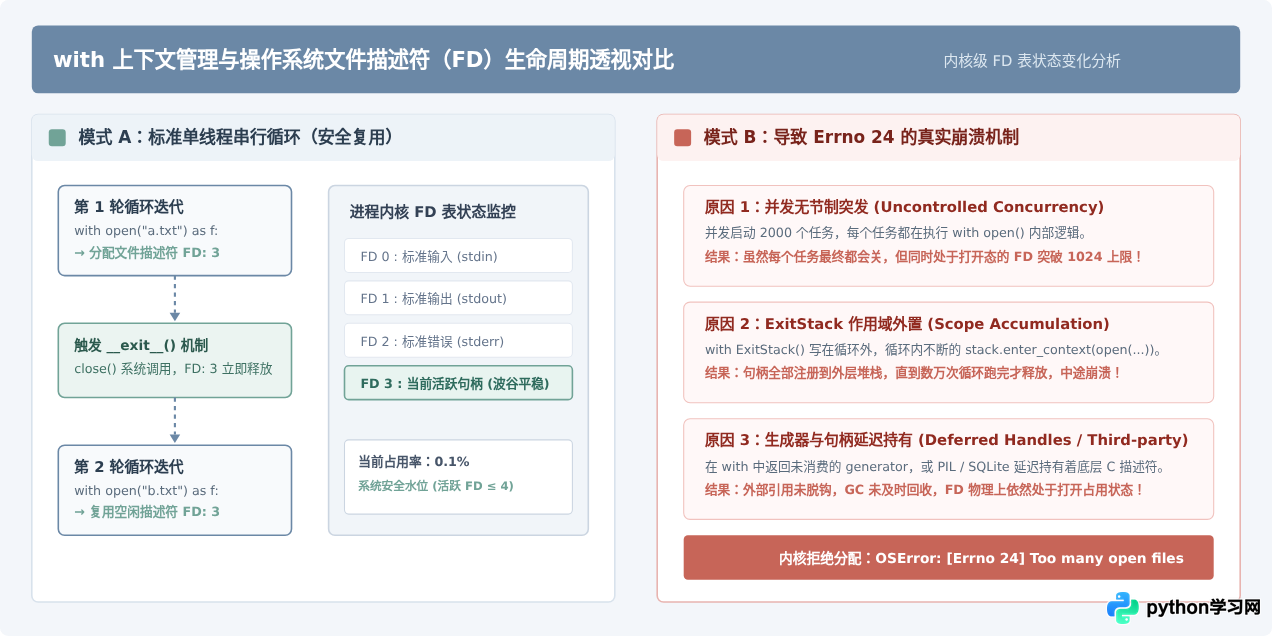
在常规的单线程串行循环中,with open(...) as f: 每次执行完代码块内部的最后一行语句,Python 解释器都会立即调用文件对象的 __exit__() 方法,由其触发底层 close() 系统调用释放 FD,FD 编号在下一轮循环中会被反复复用,因此单线程串行且无引用的循环极少耗尽描述符。但在真实业务开发中,开发者往往遭遇以下四种非典型泄漏与超限场景:
- 并发峰值击穿上限:虽然每个子线程或异步协程内部都使用了
with open(...),但由于循环提交了成千上万个并发任务,瞬时并发处理的文件数量远远超过了系统的ulimit限制。在同一时间点上,每个活跃任务都持有处于with代码块内的打开句柄。 - ExitStack 错误定义在循环外部:在使用
contextlib.ExitStack动态管理文件上下文时,误将with ExitStack() as stack:写在循环外部,而在循环内部不断调用stack.enter_context(open(...))。这导致所有文件必须等到整场外层循环彻底结束后才统一关闭,期间句柄全部累积。 - 句柄或未消费的惰性迭代器外溢:在
with代码块内部打开了文件,但将文件句柄本身、包含底层引用的生成器(如生成器表达式或行迭代器)存入了循环外部的列表或全局缓存。即便上下文退出了,底层流对象的解引用与状态同步仍可能存在异常。 - 第三方图像与数据处理库的延迟释放:例如使用
PIL.Image.open()、openpyxl或某些 C 扩展库读取循环文件时,库内部为了提升读取性能往往采用延迟加载(Lazy Loading),内部文件句柄并未随着外部简单的上下文退出而关闭,最终造成静默泄漏。
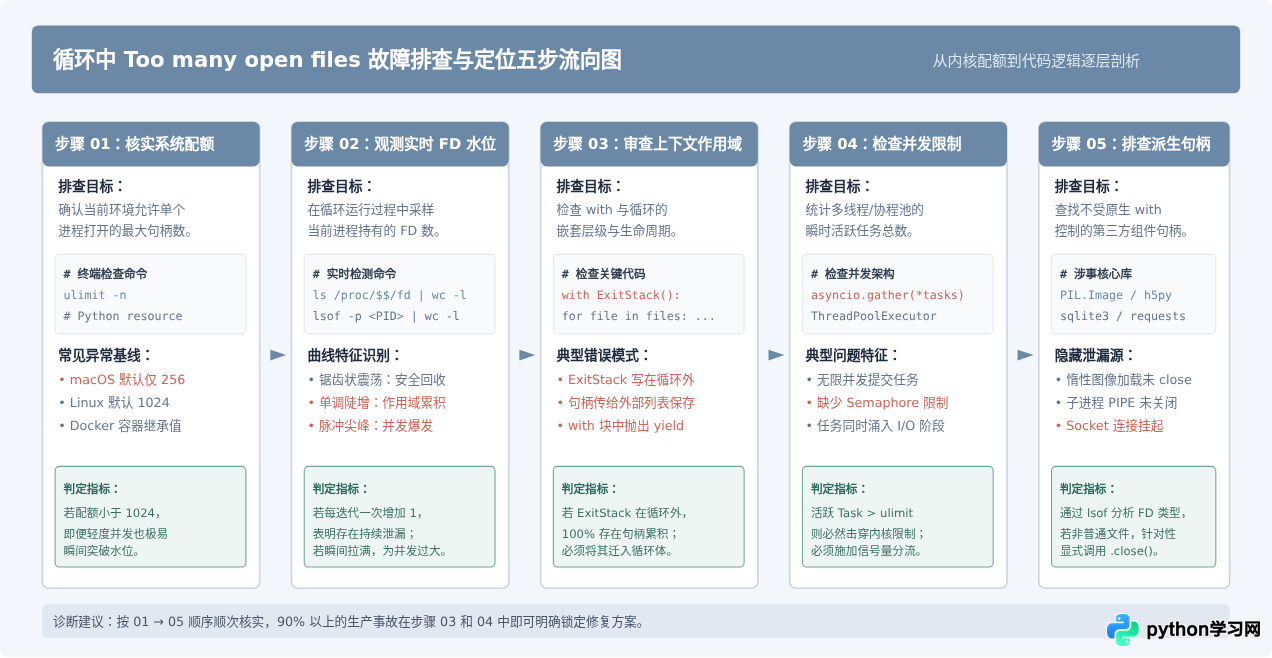
二、定位文件句柄泄漏的排查五步法
当生产环境抛出该异常时,不能盲目地调大系统限制或随处添加 gc.collect()。按照由外及内的标准排查路径,可以在数分钟内精确定位出现泄漏的代码行和执行模式。
如何在代码中动态监控当前进程的文件描述符使用量?
在 Linux 和 macOS 环境下,可以直接在 Python 内部读取当前进程的描述符使用量。将以下轻量监控逻辑嵌入到可疑循环中,可以直观观察到 FD 是否在每轮循环后正常回落:
import os
import resource

def get_fd_usage():
    """获取当前进程已使用的文件描述符数量与系统软限制"""
    # 软限制与硬限制
    soft_limit, hard_limit = resource.getrlimit(resource.RLIMIT_NOFILE)

    # 在 Linux 下通过 /proc 文件系统获取精准占用数量
    if os.path.exists('/proc/self/fd'):
        current_fds = len(os.listdir('/proc/self/fd'))
    else:
        # macOS 或未挂载 proc 的容器降级方案
        current_fds = -1

    return current_fds, soft_limit

# 示例:在处理大批量文件前后采样
current, limit = get_fd_usage()
print(f"当前活跃 FD 数量: {current} / 上限限制: {limit}")
三、实战解决方案与代码修复
1. 修正 ExitStack 的作用域(避免循环外累积)
当需要根据运行时参数动态打开未知数量的文件时,contextlib.ExitStack 是非常优秀的工具。但切忌将整个循环包裹在一个全局的 ExitStack 之中,否则所有的 close 动作都会延后到循环全部完成之后。
错误写法(句柄无限累加直至崩溃):
from contextlib import ExitStack

file_paths = [f"data/log_{i}.txt" for i in range(10000)]

# 错误:ExitStack 放在循环外部,所有文件的退出方法被压入同一个栈
with ExitStack() as stack:
    for path in file_paths:
        f = stack.enter_context(open(path, 'r', encoding='utf-8'))
        process_data(f.readline())
        # 循环继续,上一个文件并没有关闭!FD 持续递增!
正确修复方案(将 ExitStack 限制在单次循环内部):
from contextlib import ExitStack

file_paths = [f"data/log_{i}.txt" for i in range(10000)]

# 正确:每轮循环使用独立的 ExitStack,或者如果只是单个文件直接用 with open
for path in file_paths:
    with ExitStack() as stack:
        f = stack.enter_context(open(path, 'r', encoding='utf-8'))
        process_data(f.readline())
# 退出当前代码块后,本轮打开的文件被强制关闭,FD 立即释放归还很多开发者为了节约内存,在 with open() as f: 内部写了 results.append(line.strip() for line in f),然后将迭代器传递到循环外部再遍历。此时外层迭代时文件早已处于非正常关闭状态或触发 I/O 冲突。正确的做法是在 with 内部完成消费(例如 f.read() 或解析为具体业务模型),或使用生成器函数严格封装完整的 with 作用域。
2. 并发与异步循环中的流量控制(引入 Semaphore 信号量)
在异步爬虫、多线程数据清洗场景中,最常见的失误是把 with open(...) 放入协程后直接使用 asyncio.gather(*tasks) 一次性发射数千个任务。哪怕每个协程内部都有 with,由于操作系统调度机制,在并发起步阶段,数千个协程会同时执行到 with open 处,导致打开的文件数在一毫秒内击穿 ulimit 限制。
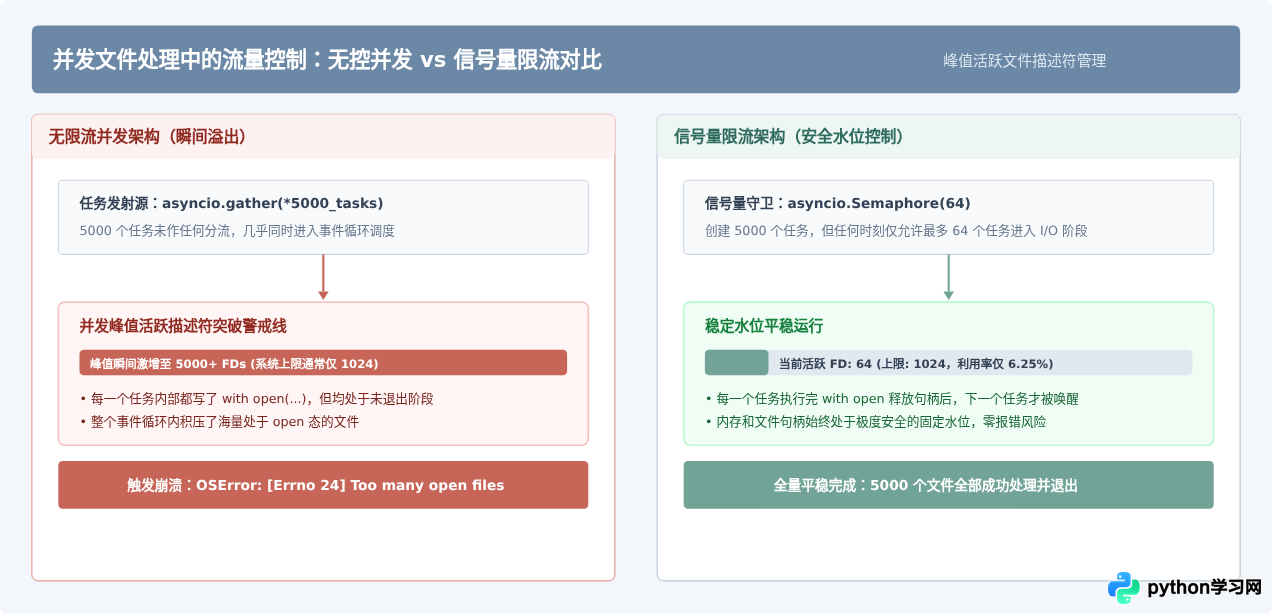
以下是使用 asyncio.Semaphore 保护并发文件 I/O 的完整生产级范式代码:
import asyncio
import aiofiles  # 或在线程池中使用标准 open

# 严格限制最多同时打开 64 个文件句柄
MAX_CONCURRENT_FILES = 64
semaphore = asyncio.Semaphore(MAX_CONCURRENT_FILES)

async def process_single_file(file_path):
    # 使用信号量作为守卫,保证同一时刻持有着 with open 的协程不超过配额
    async with semaphore:
        async with aiofiles.open(file_path, mode='r', encoding='utf-8') as f:
            content = await f.read()
            return len(content)

async def main():
    file_list = [f"corpus/doc_{i}.txt" for i in range(10000)]
    # 创建所有任务
    tasks = [process_single_file(path) for path in file_list]
    # 安全运行,绝不会发生 Errno 24
    results = await asyncio.gather(*tasks)
    print(f"成功处理 {len(results)} 个文件")

if __name__ == '__main__':
    asyncio.run(main())
3. 正确处理第三方库的延迟加载句柄(以 PIL 为例)
当在循环中批处理图像、Excel 或 HDF5 文件时,即使你用 with open(...) 读取流,传给第三方对象后依然可能会泄漏。以最典型的 Pillow(PIL)为例:
from PIL import Image

# 隐患写法:即使使用 with,PIL.Image 仍然持有着底层句柄直到被垃圾回收
for path in image_paths:
    with Image.open(path) as img:
        # 如果未调用 load(),某些格式(如 TIFF、未完全读取的 PNG)可能不会立即释放底层文件指针
        img.load()  # 强制将像素数据完全载入内存,脱离底层文件描述符
        process_image(img)
# 退出 with 时,Image 的上下文管理器会确保 close() 被执行在处理复杂对象时,优先考虑在 with open(path, 'rb') as f: data = f.read() 中一次性读取原始二进制字节流,随后使用 io.BytesIO(data) 在纯内存中构建目标对象。这样物理文件句柄在毫秒级内即可完成 close() 闭环,后续解析即便耗时几秒也不会占用任何系统文件描述符。
4. 调整操作系统与容器的配额上限
如果业务本身确实属于重型并发服务(如高吞吐 Web 服务器、大并发网关),单进程在合法生命周期内就需要维持数千个有效连接或文件句柄,那么除了优化代码,还需要针对宿主机或 Docker 容器调整 ulimit 限制。
| 操作系统 / 运行环境 | 临时修改方式(当前会话生效) | 永久生效配置路径 |
|---|---|---|
| Linux (Ubuntu / CentOS) | ulimit -n 65535 |
编辑 /etc/security/limits.conf,增加 * soft nofile 65535 与 * hard nofile 65535 |
| macOS | ulimit -n 4096 |
创建 /Library/LaunchDaemons/limit.maxfiles.plist 并在内核中设置 sysctl -w kern.maxfiles=65536 |
| Docker 容器 | 启动参数追加 --ulimit nofile=65535:65535 |
在 Docker Compose 中配置 ulimits: nofile: soft: 65535 hard: 65535 |
| systemd 服务管理 | 不适用 | 在服务的 .service 文件中添加 LimitNOFILE=65535 |
四、健壮性架构防御体系与总结
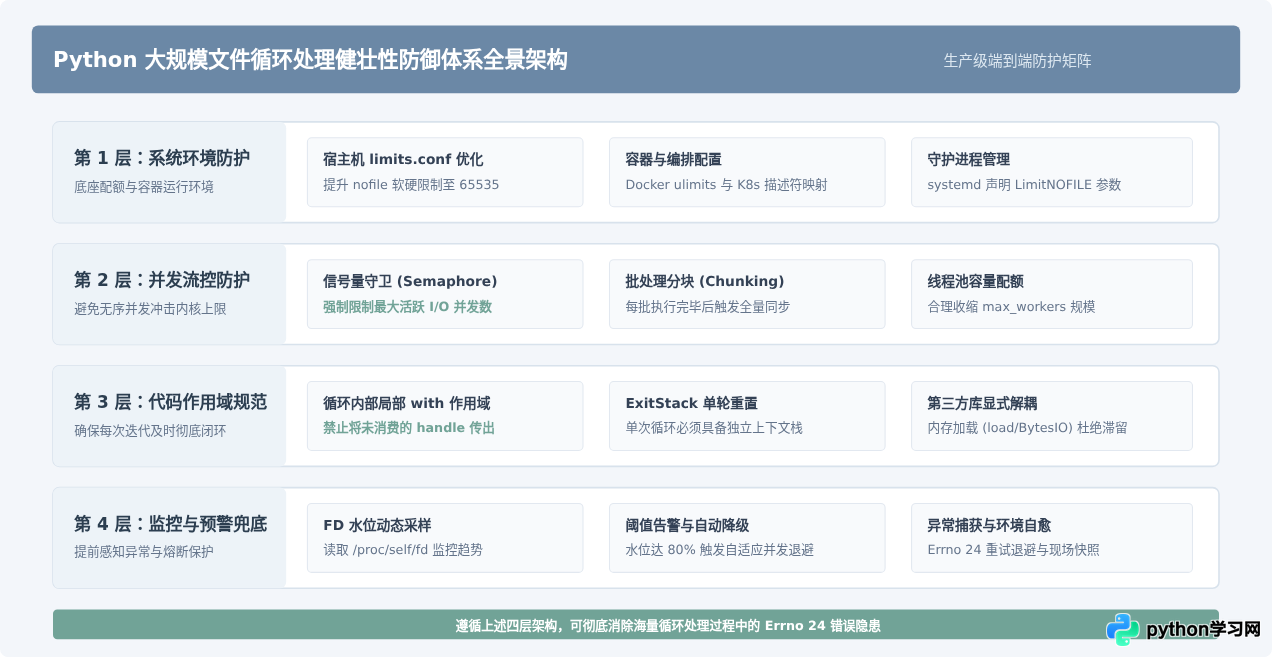
解决循环中文件描述符耗尽的问题,不能依赖零散的代码打补丁。建立起从代码作用域规范、流量并发控制、异常兜底再到系统环境配置的四层立体防御体系,才能保证大体量数据处理脚本与生产系统长期稳定运行。
五、常见疑惑解答 (FAQ)
Q1:既然使用了 with,手动再写一次 f.close() 有意义吗?
没有意义。with 语法在底层实现中,正是通过在代码块退出(包括正常结束与异常中断)时强制触发 __exit__(),而标准文件对象的 __exit__() 本质调用的就是 self.close()。如果你在 with 内手动写 f.close(),只会导致同一句柄被重复关闭,既不能解决并发超限问题,也不能改变外部对象持有句柄导致的滞留问题。
Q2:为什么同样的代码在 Windows 开发机上正常运行,部署到 Linux 容器或 macOS 却直接报错?
因为不同系统与环境对进程文件描述符的限制默认值差异极大。Windows 对标准句柄的限制相对宽泛,而 macOS 终端会话默认的 ulimit -n 常常只有 256,Linux 服务器系统通常默认 1024。在 Windows 下跑 500 个并发文件可能毫无感知,但在 macOS 或默认配置的 Linux 容器中会瞬间击穿阈值报错。
Q3:能否通过在循环中频繁调用 gc.collect() 来解决该问题?
非常不推荐。依赖垃圾回收器释放文件描述符属于典型的“反模式”。第一,Python 的垃圾回收(尤其是分代回收和周期检查)成本极高,在循环中频繁调用会严重拉低吞吐性能;第二,如果文件句柄被全局容器、闭包或第三方 C 扩展隐式强引用,gc.collect() 也根本无法将其释放。核心解决方案必须是规范 with 作用域、收紧并发水位并显式关闭流对象。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















